

Python3实现12306火车票查询工具详解
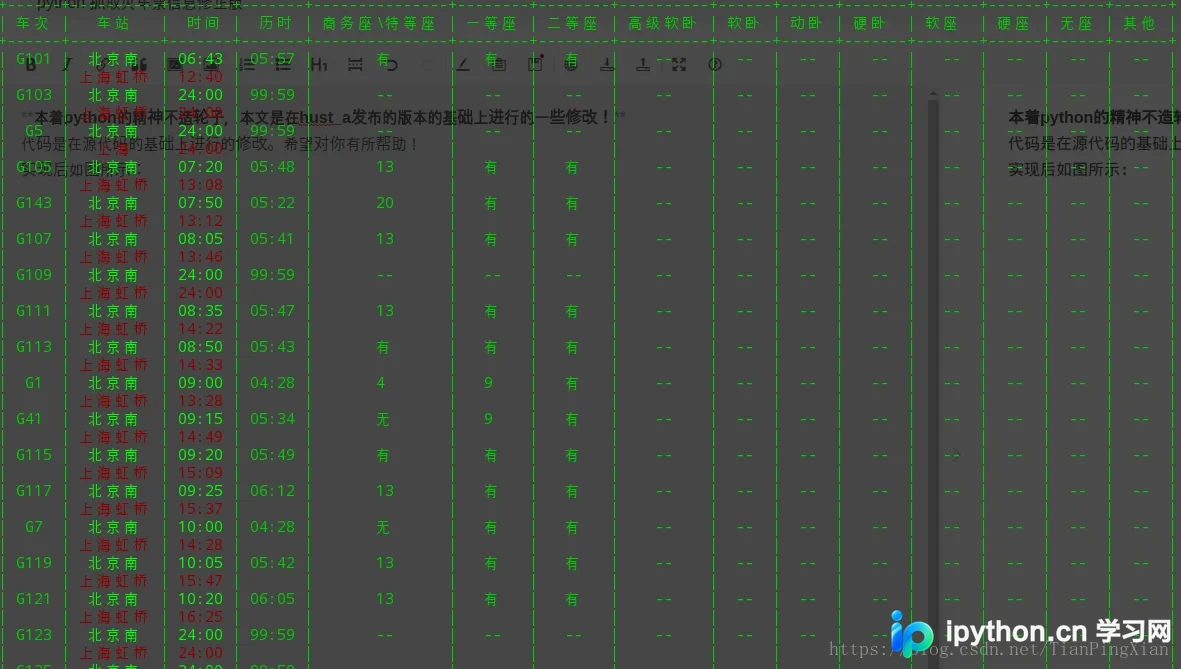
本文介绍基于Python3的12306火车票查询程序实现。通过抓取车站名称JS文件获取车站字典,利用urllib和requests库构建查询URL。代码包含日期格式化、学生票判断及终端彩色输出功能,最终使用PrettyTable展示车次、余票等详细信息,并提供完整源码链接供参考。
2026-10-13
21

本文介绍基于Python3的12306火车票查询程序实现。通过抓取车站名称JS文件获取车站字典,利用urllib和requests库构建查询URL。代码包含日期格式化、学生票判断及终端彩色输出功能,最终使用PrettyTable展示车次、余票等详细信息,并提供完整源码链接供参考。
本文详解利用Numpy和Pandas库将CSV文件数据读取为数组或矩阵的方法。重点解决路径转义字符导致的SyntaxError,并演示使用Pandas处理缺失值及结合Sklearn的Imputer进行数据清洗的完整流程。
本文介绍了一个基于Python的小型爬虫系统实现,涵盖URL管理、HTML下载、解析及输出模块。通过正则表达式提取链接,利用BeautifulSoup解析文本内容,并支持将抓取结果保存为HTML表格或TXT文件。代码展示了从初始URL到批量文档下载的全流程,适合Python初学者理解爬虫架构与核心逻辑。
本文详细介绍如何在Scrapy框架中集成Redis以实现分布式爬虫。涵盖scrapy-redis库的安装方法、Redis服务器的启动与缓存清理,以及settings.py中的关键配置参数。通过示例代码展示如何继承RedisSpider类并设置redis_key,帮助开发者高效构建高性能的分布式数据采集系统。
本文详细解析Python Pandas中数据选取的三种核心方法:.loc、.iloc和.ix。通过具体代码示例,阐述在已知列名与索引时使用.loc,通过整数位置切片时使用.iloc,以及混合使用标签与下标时使用.ix的适用场景。文章旨在帮助开发者清晰区分三者差异,提升数据处理的效率与准确性。
本文详细讲解如何利用pandas库对Series和DataFrame进行排序操作。内容涵盖按索引排序、按值排序、升降序调整及多列排序等核心功能,通过具体代码示例与运行结果展示,帮助开发者掌握数据清洗与预处理中的关键排序技巧。
本文详细介绍Python内置函数complex()的用法。该函数用于创建复数对象,支持传入实部和虚部参数,或仅通过字符串解析生成复数。文章涵盖其语法结构、参数说明、返回值类型及实际代码示例,展示如何进行复数的加减乘除运算,适用于科学计算与信号处理等场景。
本文探讨Pandas中DataFrame排序后索引保持原值的问题,详细解析了.loc按标签索引与.iloc按位置索引的区别。通过具体代码示例说明排序后如何正确获取数据,并指出.iloc访问时需使用整数位置而非列名的注意事项,帮助开发者避免常见索引错误。
本文详解Python中使用re模块通过正则表达式提取字符串中括号内内容的方法。重点解析了r前缀、字符集去特殊化、分组提取、.匹配任意字符及re.S标志的作用,并对比了最小匹配与贪婪匹配的区别,附带完整代码示例及在线工具推荐。
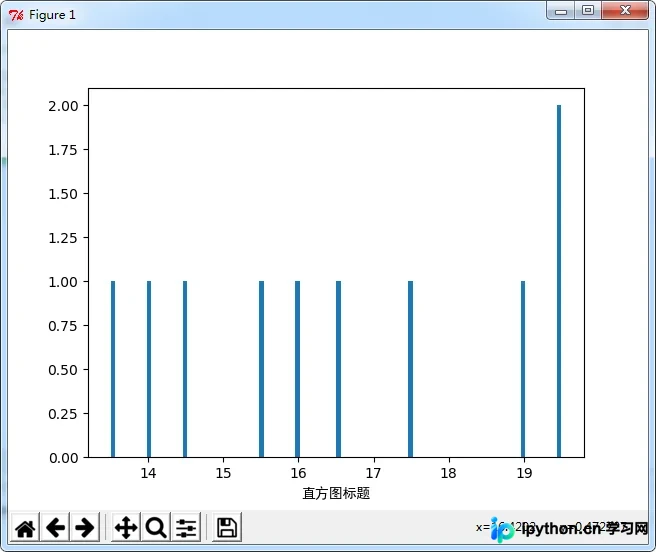
本文介绍如何利用Python的pylab库实现直方图的绘制。通过读取包含数值数据的文本文件,提取第一列数据并使用pl.hist函数生成统计直方图。示例代码展示了完整的文件读取、数据处理及图表展示流程,适用于基础数据分布分析场景。
本文深入解析Python中字符串格式化的两种主要方式:%操作符与format方法,并通过实例对比展示format在参数处理上的优势。同时介绍Python 3.6引入的f-string新特性,详细讲解位置、关键字、属性及下标等format用法,涵盖对齐、精度、进制转换及千位分隔符等高级技巧,帮助开发者选择更高效的格式化方案。
本文介绍如何使用Python的win32clipboard模块实现剪切板的读写操作。通过封装获取和写入函数,开发者可以方便地在桌面程序或特殊操作中处理剪贴板数据,支持手动复制粘贴与程序写入的交互测试。