Django 数据库查询结果封装为字典的三种方式
本文介绍在 Django 中将数据库查询结果(QuerySet)封装为字典的三种常用方法。包括使用 `model_to_dict` 进行模型序列化、利用 `serializers` 模块生成 JSON 数据,以及通过自定义游标函数将原始查询结果转换为字典列表。文章提供了具体的代码示例和操作步骤,帮助开发者灵活处理数据库返回数据。
2026-10-11
23

本文介绍在 Django 中将数据库查询结果(QuerySet)封装为字典的三种常用方法。包括使用 `model_to_dict` 进行模型序列化、利用 `serializers` 模块生成 JSON 数据,以及通过自定义游标函数将原始查询结果转换为字典列表。文章提供了具体的代码示例和操作步骤,帮助开发者灵活处理数据库返回数据。
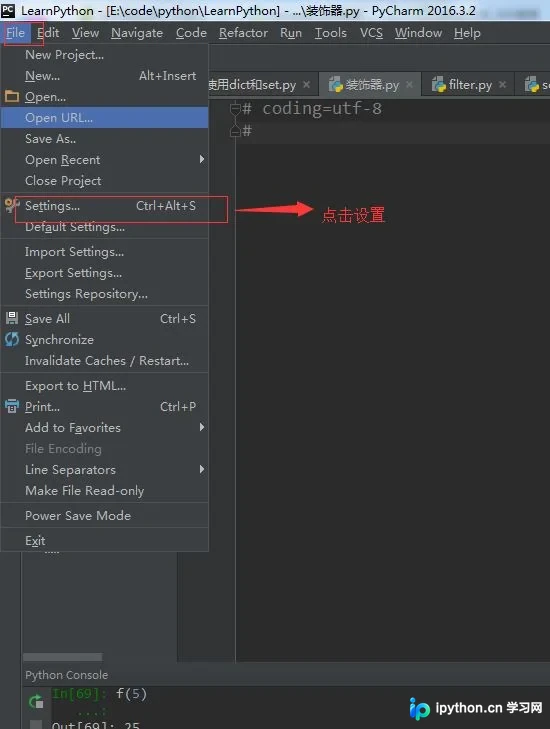
本文详细讲解如何在PyCharm中配置IPython 4.2.1交互环境,解决原生Python编码效率低的问题。通过安装指定版本IPython、修改控制台设置以及编写和绑定宏快捷键,实现多行代码快速执行,提升Python数据分析的开发体验。
本文介绍如何使用Python对接钉钉开放平台,通过注册应用获取appkey和appsecret,进而调用接口获取access_token。文章提供了完整的代码示例,展示如何发起请求并解析返回的token数据,以及利用该token获取部门列表的基本方法,帮助开发者快速上手钉钉接口开发。
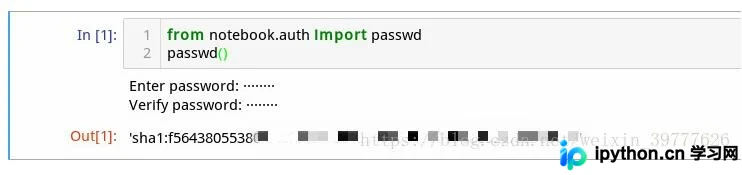
本文介绍如何修改 Jupyter Notebook 的默认工作目录,以及解决 Linux 环境下以 Root 用户运行 Notebook 时的权限警告。通过修改快捷方式目标路径、生成配置文件并调整 allow_root 参数,可快速完成环境配置。
本文提供使用Python和pymysql库实现通讯录管理系统的完整代码示例。内容涵盖数据库连接、数据表创建及字段定义,并详细演示了信息的添加、查询、更新与删除功能。代码包含完整的交互逻辑,适合Python初学者参考学习数据库基础操作。
本文介绍如何利用Python pandas库中的fillna方法处理数据缺失值。通过value参数指定具体填充数值,利用method参数(ffill/bfill)控制前后向自动填充方向,并结合limit参数限制最大填充行数。文章包含读取Excel、字典映射填充及限制填充行数的完整代码示例,帮助开发者高效完成数据清洗任务。
本文提供基于Python和Tkinter库实现的俄罗斯方块游戏完整代码。通过多线程控制方块下落,利用Canvas进行图形绘制,并处理键盘交互事件。代码包含方块定义、移动、旋转及碰撞检测逻辑,适合Python初学者参考学习GUI编程与游戏逻辑实现。
本文介绍如何利用Python的hashlib模块计算文件的MD5值,进而识别目录下的重复文件。文章提供了命令行快速检测方法及完整的Python脚本实现,包含逐块读取大文件的优化方案,并演示如何生成重复文件日志。
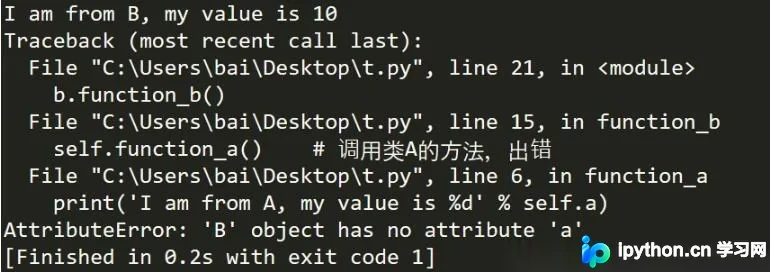
在Python面向对象编程中,子类重写__init__时若不调用父类初始化,会导致父类属性缺失。本文详解两种调用父类__init__的方法:直接通过类名调用未绑定方法及使用super函数,分析各自在单继承与多继承场景下的优劣及注意事项。
本文详细解析Python网络爬虫的基本工作原理及系统架构。从发起请求、获取响应、解析内容到保存数据四个步骤阐述抓取流程,并深入剖析调度器、URL管理器、下载器、解析器及存储器五大核心模块的功能与协作机制,旨在帮助开发者构建高效、模块化的爬虫系统。

本文介绍在PyCharm中运行.py文件的两种方法。手动配置需通过Run/Debug Configurations添加Python脚本路径;快捷方式是将光标置于代码行后按F9键直接运行。F9默认配置与手动配置信息一致,适用于快速执行脚本。

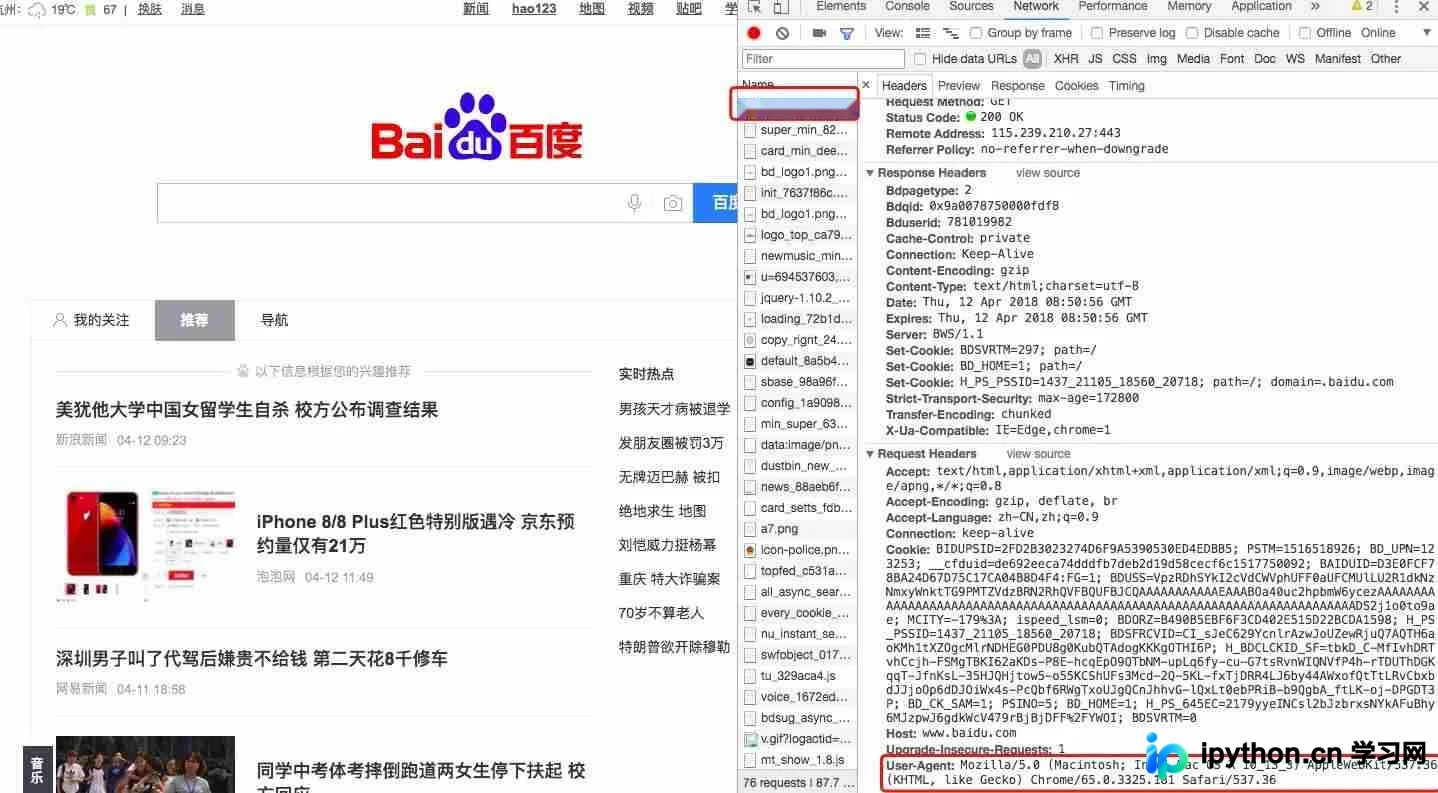
本文介绍如何利用Python的requests库通过伪装浏览器User-Agent来绕过网站的反爬机制。通过模拟真实浏览器的请求头(如Accept、Connection等),并随机切换User-Agent,可以有效防止IP被封禁,提高爬虫的稳定性和成功率。