

Python卷积函数详解:参数解析、性能对比与边缘提取实战
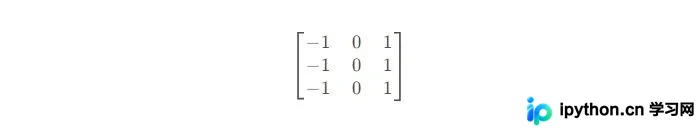
本文详细解析Python中常用的卷积函数,对比全量、同尺寸及有效交叠三种输出模式,图解scipy.ndimage的边界填充策略,并通过基准测试验证各方案的性能差异,最后演示如何利用卷积核完成图像纵向边缘提取。
2026-10-12
23

本文详细解析Python中常用的卷积函数,对比全量、同尺寸及有效交叠三种输出模式,图解scipy.ndimage的边界填充策略,并通过基准测试验证各方案的性能差异,最后演示如何利用卷积核完成图像纵向边缘提取。
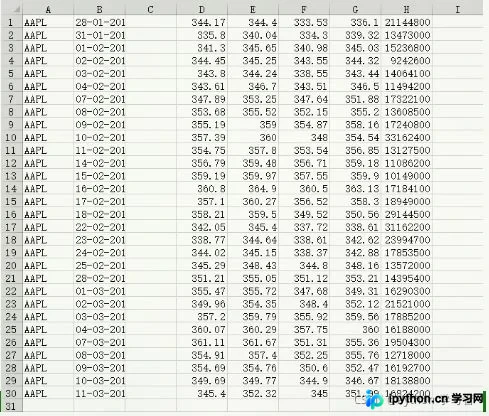
本文以Python NumPy库为核心,展示如何从TXT与CSV文件中加载数据,并演示如何利用内置函数完成单位矩阵生成、加权平均价格(VWAP/TWAP)、基础统计量(均值、中位数、方差、极差)以及股票收益率与波动率的量化计算。代码已适配Python 3环境,可直接应用于金融数据预处理与统计分析场景。
本文详细介绍如何在 Django 项目中利用 django-celery-beat 库创建和管理动态定时任务。内容包括环境搭建、Celery 配置、调度器类型选择、任务定义及系统启动流程,并提供常见问题的排查方法,帮助用户快速实现可靠的后台任务自动化。
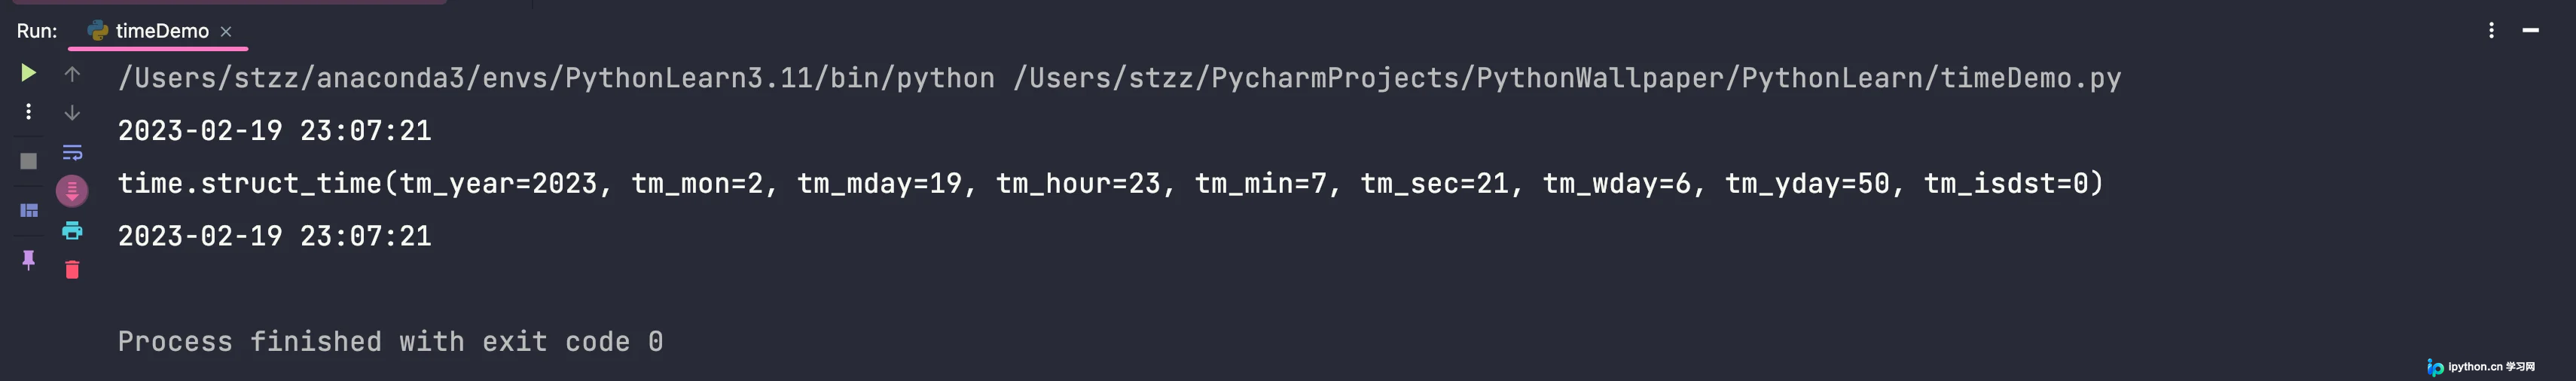
本文详细介绍Python中datetime模块的核心用法,涵盖date、time、datetime及timedelta类的特性。内容包含时间戳与字符串的双向转换、指定格式输出、获取当前日期、计算时间间隔及日期比较等实用操作,帮助开发者高效处理时间相关逻辑。
本文详解Python中使用readline()和readlines()函数按行读取文件的核心语法与参数控制。通过文本与二进制模式的对比代码,演示如何获取单行数据、处理末尾换行符及限制读取长度,并分析两者在返回值类型与内存占用上的差异,帮助开发者高效完成文件内容解析。
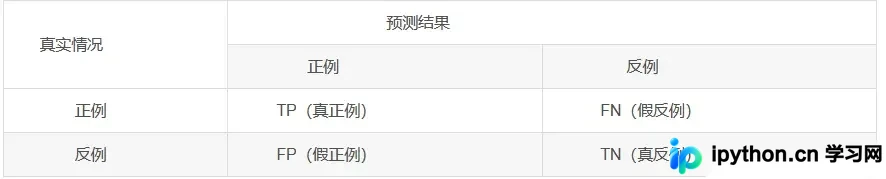
在机器学习分类任务中,混淆矩阵是量化模型性能的核心工具。本文基于 Python 和 sklearn 库,详细演示如何从原始预测数据中提取真实值与预测值,准确计算 TP、FP、TN、FN 等基础指标,并分步实现 Seaborn 热力图与官方可视化组件的代码编写。掌握该流程可快速定位模型误判分布,指导后续的特征工程与超参数调优。
本文解析Python报错“SyntaxError: invalid character in identifier”的常见原因,重点指出缩进中混入制表符(Tab)是主要诱因,Python仅识别4空格缩进。同时补充版本兼容、括号匹配、赋值与比较混淆等导致SyntaxError的其他因素,提供排查与修复建议。
本文介绍Python处理包含非法双引号的JSON字符串时的报错问题,提供通过正则替换转义特殊字符的解决方案。同时详解json.dumps与json.loads的正确用法,避免单双引号混用导致的解析错误,适用于数据清洗与跨系统数据传输场景。
在 Python 3.7 环境中使用 Sanic 时,安装 sanic-ext 后 /docs 路由无法访问且服务静默不报错。本文通过分析启动日志中的 packages 字段定位问题根源,发现是第三方元数据管理包 importlib-metadata 版本与扩展插件不匹配所致,并提供快速验证与升级建议。
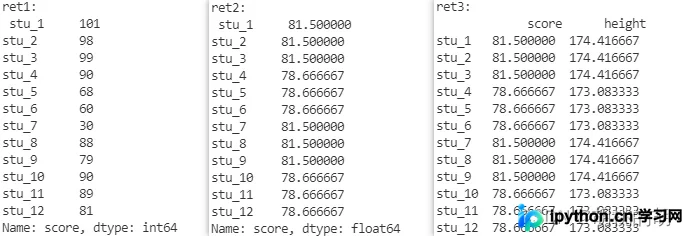
本文详细解析Pandas中transform与apply方法在分组聚合中的区别与应用。通过示例展示如何利用自定义函数处理Series和DataFrame,包括数值计算、字符串操作及多列聚合。重点阐述transform保持原索引长度与apply返回聚合结果的特性,帮助开发者根据需求选择合适方法,提升数据处理效率。
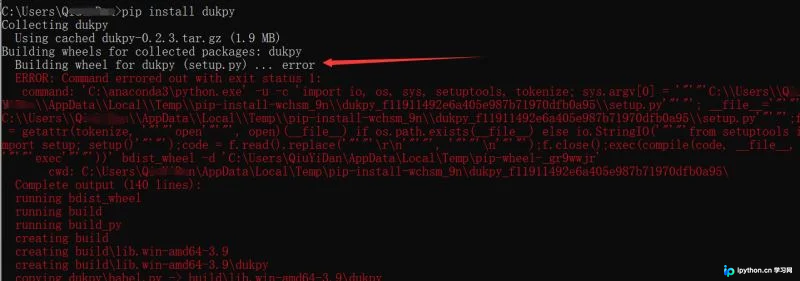
本文详细解析在使用pip安装Python库时遇到的“Failed building wheel for xxx”错误原因及解决方案。该错误通常因缺少预编译的.whl文件导致。通过访问第三方资源网站下载对应Python版本和系统的.whl文件,并手动执行安装命令,可有效绕过编译问题,确保依赖库正常部署。
本文系统梳理Pandas在数据分析中的核心应用,涵盖数据导入导出、重复值与缺失值处理、字符串清洗、数据筛选与抽样、多表合并、时间序列解析及标准化等关键步骤。通过具体代码示例,帮助开发者快速掌握高效处理表格型数据的方法,提升数据预处理效率。