

Python使用xlwt库向Excel写入中文文件的解决方案
本文介绍使用Python的xlwt库向Excel写入中文文件名时遇到的编码问题。通过对比Windows与Linux环境下的编码处理差异,指出Windows下cp936有效而Linux需使用utf-8。文章提供了修正后的Python脚本代码,确保在生成Excel文件时能正确写入中文字符,避免UnicodeDecodeError错误。
2026-10-13
23

本文介绍使用Python的xlwt库向Excel写入中文文件名时遇到的编码问题。通过对比Windows与Linux环境下的编码处理差异,指出Windows下cp936有效而Linux需使用utf-8。文章提供了修正后的Python脚本代码,确保在生成Excel文件时能正确写入中文字符,避免UnicodeDecodeError错误。
本文介绍如何利用pandas库中的usecols参数,在读取CSV文件时仅提取指定的列数据。通过对比全量读取与指定列读取的输出结果,展示了该方法在清理无效列、简化数据展示及提升终端界面清爽度方面的实际应用价值。
本文介绍在Python中处理如4GB大小的超大文本文件时,如何高效地逐行读取内容并写入目标文件。通过对比直接迭代文件对象与使用readlines()方法的差异,提供具体的代码实现,帮助开发者在避免内存溢出的同时完成文件数据的迁移与处理。
本文介绍一种利用Python将字符串按指定行数进行Z字形(或之字形)列分配,随后按行拼接输出的实现方法。通过构建二维矩阵并填充空白占位符,清晰展示字符在行与列间的分布逻辑,提供完整代码及多组测试用例,帮助开发者理解字符串重排算法的核心思路。
本文详解Numpy中掩码式数组(Masked Array)的原理与应用。通过结合正常数组与布尔掩码,可有效忽略残缺或无效数据。文章涵盖从创建方法到具体实例,并演示如何利用掩码数组处理负数对数计算及极值忽略等场景,帮助开发者更高效地处理含噪声或空白的复杂数据集。
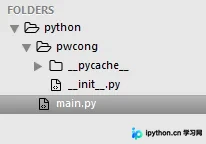
本文详细解析Python3中导入自定义模块的三种方式:直接import、利用sys.path动态添加路径以及通过.pth文件配置。文章结合廖雪峰教程基础,针对模块与执行文件同目录或不同目录的场景,提供具体代码示例和操作步骤,帮助开发者解决模块导入失败的问题,提升代码可维护性。
本文介绍如何在Python中将字典转换为二维数据及DataFrame对象。通过将字典的键值对列表化,可快速生成二维数组;利用pandas库可直接将字典项转换为DataFrame,并自定义列名。该方法简洁高效,适用于数据预处理与结构转换场景。
本文提供了一段Python脚本,用于每日将MySQL数据库中的历史数据迁移至归档库。脚本通过命令行参数配置源与目标数据库连接、表名及迁移策略,支持按时间区间自动清理旧数据,适用于需要定期归档历史记录的数据库维护场景。
本文详解Python pandas中生成指定日期范围的方法,包括使用date_range设定起止时间、周期及频率。重点讲解时间序列的重采样技术,涵盖通过resample进行降采样(高频转低频)与升采样(低频转高频)的具体操作,解析closed、label等关键参数对聚合结果的影响,并提供基于groupby的替代聚合方案及填充策略。
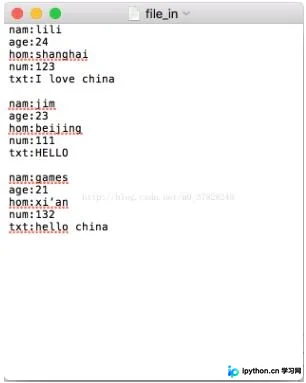
本文介绍如何使用Python和Pandas库,将包含“类别:内容”格式的纯文本文件转换为结构化的DataFrame表格。通过遍历文件行、利用冒号分割键值对并构建字典,最终生成包含指定列名的DataFrame对象,实现从非结构化数据到表格数据的便捷转换。
本文详解Python Pandas中DataFrame的行列选择与切片方法。对比loc、iloc、at、iat及ix函数的用法,说明基于标签与位置索引的区别。通过实例展示正确与错误的代码写法,总结各方法的适用场景及常见错误,帮助开发者高效进行数据筛选。
本文介绍在pandas中如何将DataFrame转换为Series,以及利用astype方法结合numpy模块修改列中值的数据类型。通过具体代码示例展示了创建Series时指定索引的技巧,以及使用np.int64等类型参数进行数据格式转换的实际操作,适用于需要处理数据格式的场景。