

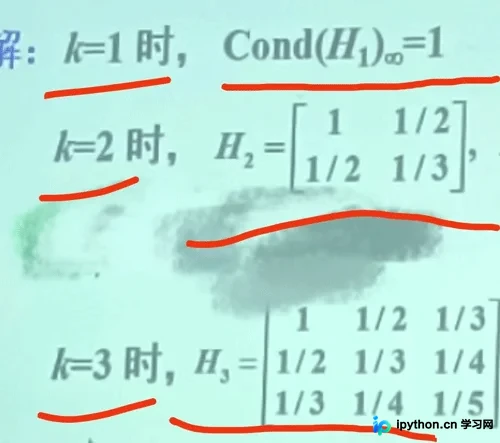
如何使用Python生成Hilbert矩阵及构建增广矩阵
本文详细讲解利用Python与NumPy库生成Hilbert矩阵的核心逻辑。通过解析行列下标与元素值的对应规律,提供基础构造代码,并演示如何扩展生成包含行求和结果的增广矩阵。附完整源码、运行结果及关键参数说明,帮助开发者快速掌握矩阵计算技巧。
2026-10-12
23

本文详细讲解利用Python与NumPy库生成Hilbert矩阵的核心逻辑。通过解析行列下标与元素值的对应规律,提供基础构造代码,并演示如何扩展生成包含行求和结果的增广矩阵。附完整源码、运行结果及关键参数说明,帮助开发者快速掌握矩阵计算技巧。
本文分析 Django Admin 中因关联模型数据量过大(如十万级外键)导致打开编辑页时出现 Broken Pipe 错误的解决方案。通过对比默认滑动选择框与 raw_id_fields 放大镜控件的性能差异,指出生成大量 HTML 标签是造成请求超时的根本原因。建议对大数据量外键使用 raw_id_fields 优化加载速度,避免连接断开。
在运行Python脚本时,经常需要通过命令行动态传入变量。本文详细介绍三种常用传参方式:基础列表解析(sys.argv)、带短长选项解析(getopt模块)以及通过外部配置文件中转。结合实际仿真计算与浏览器自动化测试场景,给出完整代码示例与参数对比,帮助开发者灵活选择适合项目需求的传参方案。
本文详细解析Python 3内置的七种算术运算符功能与严格优先级规则,深入演示加号与乘号在字符串、列表及元组等序列结构中的拼接合并与重复复制特性,并提供完整可运行代码与预期输出对照,帮助开发者准确掌握基础数学运算与类型转换逻辑。
本文详细记录在 Windows 系统中为 Anaconda 配置环境变量的标准流程。通过精准修改系统 Path 参数,解决终端无法识别 conda 指令的问题,并附带路径录入规范、重启终端要求与常见报错排查指南,协助开发者快速完成本地开发环境的初始化。
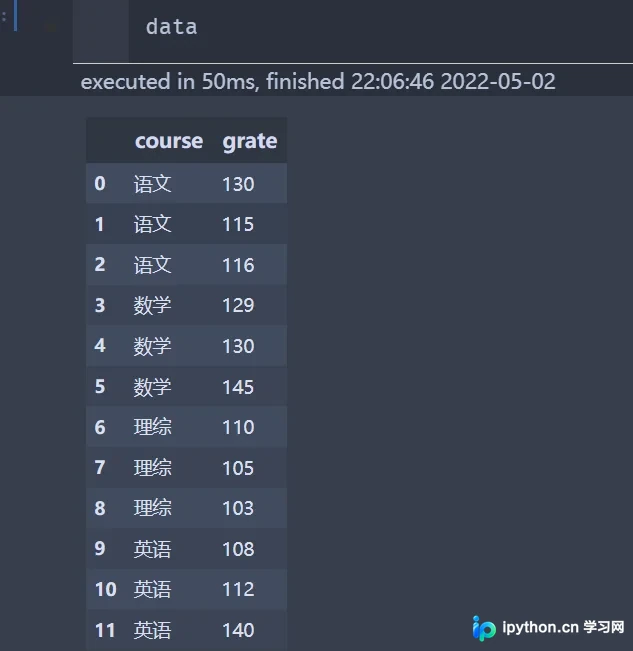
本文介绍如何利用Python pandas库的groupby函数,结合apply和lambda表达式,从分组数据中筛选出每组最大值与最小值所在的行。通过具体代码示例,演示如何处理多级索引并导出结果至Excel,解决直接使用groupby无法直接获取极值行的问题。
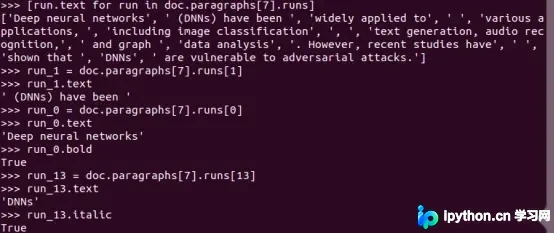
本文详细演示如何使用 Python 的 python-docx 库加载 .docx 文件,通过 core_properties 获取作者与创建日期等元数据,遍历 paragraphs 过滤空行并提取纯文本,同时利用 runs 属性精准判断粗体与斜体样式。全程提供可运行的代码示例,适用于自动化文档解析与内容抓取场景。
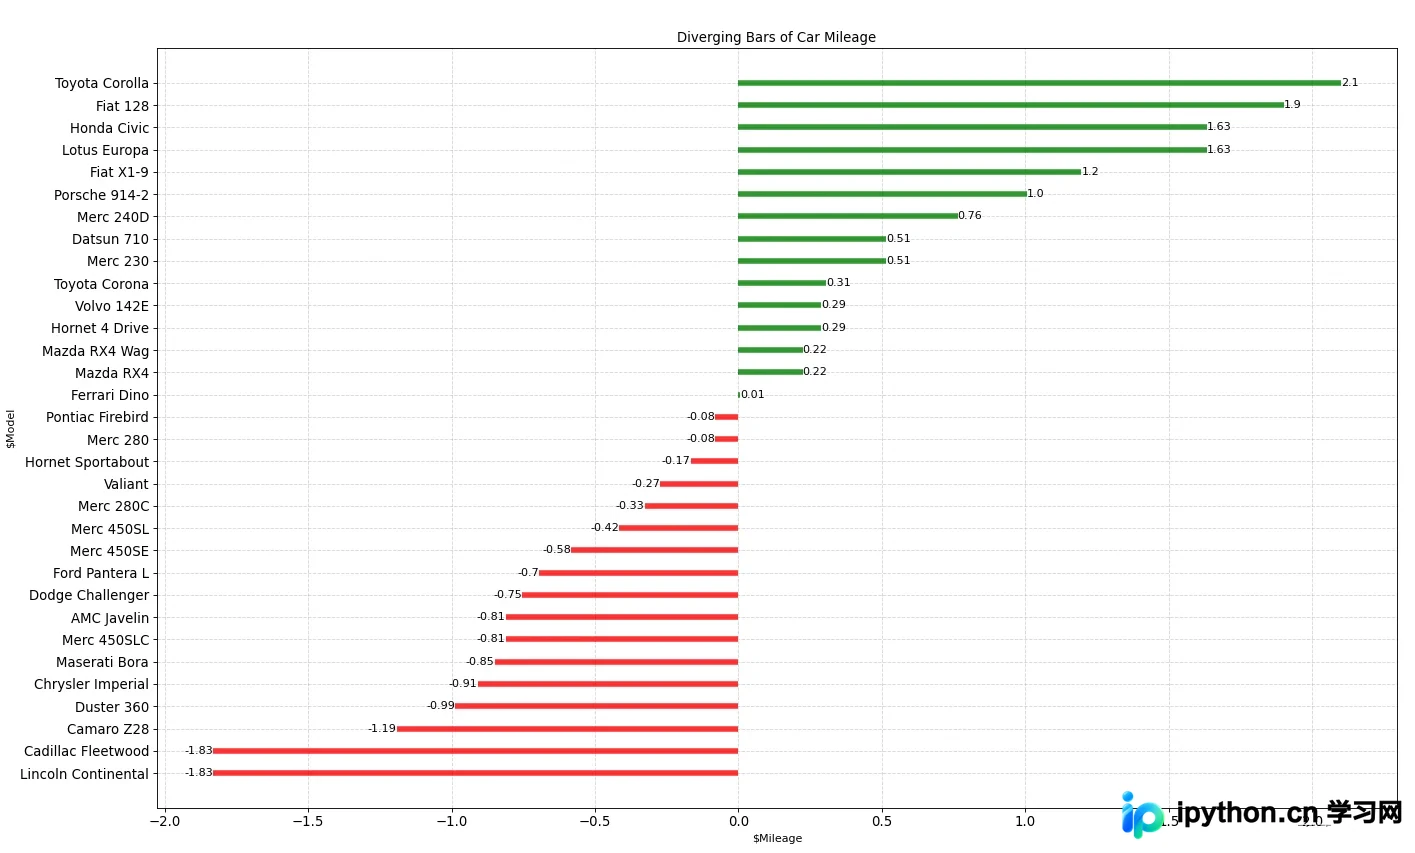
本文详细介绍四种Python数据可视化图表的实现方法。首先展示如何绘制发散型柱状图以对比指标差异;其次演示带误差阴影的时间序列图,用于展示数据波动范围;接着讲解双坐标系时间序列图的绘制技巧,实现双变量同图展示;最后介绍金字塔图的构建,适用于漏斗模型或分组差异分析。
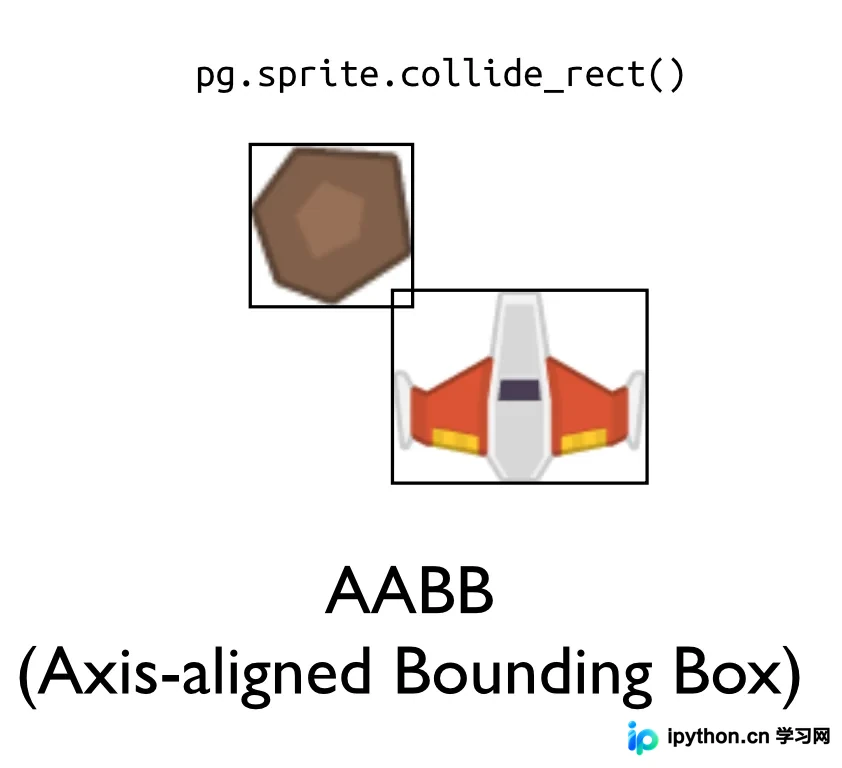
本文深入解析Pygame中常见的矩形碰撞误判问题,并提供两种有效的优化方案。通过对比AABB矩形碰撞与圆形碰撞的优劣,详细演示如何为精灵设置半径属性,利用collide_circle函数提升玩家与流星碰撞的判定精度,同时保留子弹矩形碰撞以平衡性能与体验。
掌握Python中的条件判断与循环语句是编写程序的基础。本文详解if、elif、else的组合用法,剖析while与for循环的执行逻辑及range()特性,并结合break和continue实现流程控制。通过完整代码示例与九九乘法表实战,帮助开发者快速理清逻辑分支与迭代遍历的核心操作。
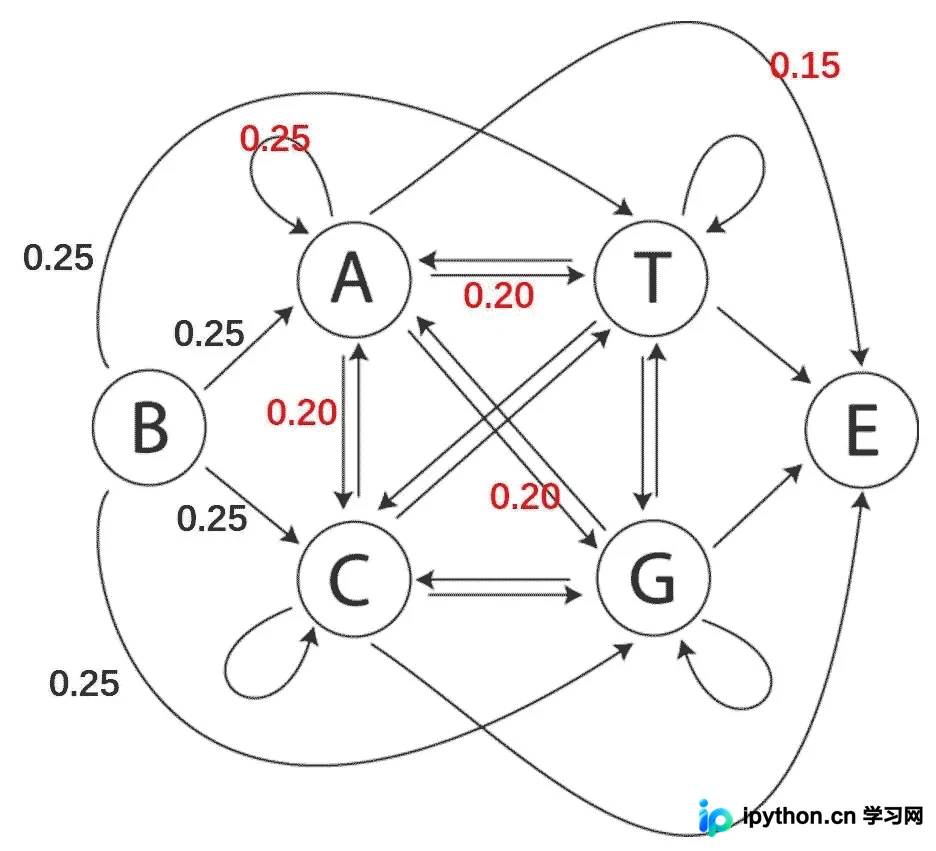
本文介绍如何在Python中利用一阶马尔科夫链生成随机DNA序列。通过设定碱基转移概率矩阵,结合numpy和random模块模拟序列演化过程,并统计长度分布。代码可直接运行于Jupyter Notebook,支持自定义序列数量和概率参数,适合生物信息学中的序列建模需求。
在读写文件前验证路径有效性是避免程序异常的关键。本文系统梳理Python中判断文件或文件夹是否存在的三种标准方案:基于os模块的路径与权限校验、利用try-except捕获异常直接尝试访问,以及现代标准的pathlib路径对象检测。结合完整代码示例说明适用场景与操作细节。