Scrapy结合Selenium动态加载页面抓取实战
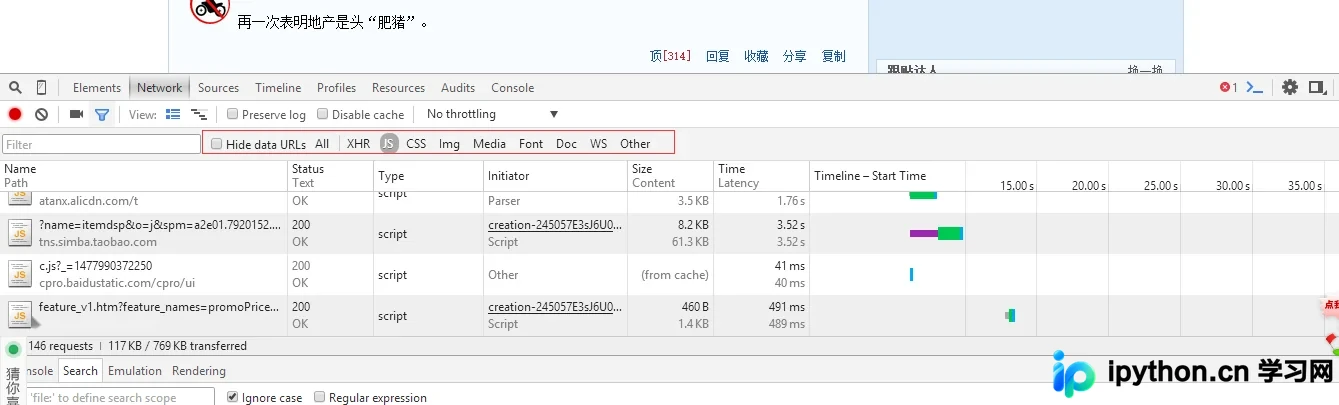
针对淘宝、京东等动态加载网站,直接请求无法获取完整数据。本文介绍如何在Scrapy框架中通过中间件集成Selenium,利用无头浏览器模拟滚动和交互,获取渲染后的完整HTML源码,并构造HtmlResponse对象直接返回,从而绕过传统下载器,实现高效的数据抓取。
2026-10-13
23

针对淘宝、京东等动态加载网站,直接请求无法获取完整数据。本文介绍如何在Scrapy框架中通过中间件集成Selenium,利用无头浏览器模拟滚动和交互,获取渲染后的完整HTML源码,并构造HtmlResponse对象直接返回,从而绕过传统下载器,实现高效的数据抓取。
在使用pip安装Django时,常因网络问题导致ReadTimeoutError或ProxyError而安装失败。本文提供通过指定国内镜像源(如豆瓣源)解决该问题的具体命令,帮助开发者快速完成Django环境的搭建。
本文详细解析Python中.join()与os.path.join()两个函数的具体用法。.join()用于将序列元素以指定分隔符连接为新字符串,支持列表、元组、字典及字符串;os.path.join()则用于组合多个路径段生成完整路径。文章通过代码示例展示了不同数据类型下的操作结果,帮助开发者掌握字符串与路径处理技巧。
本文介绍如何使用Python检测指定路径下所有文件占用的存储空间,并获取磁盘剩余空间大小。通过os.walk遍历文件计算容量,利用os.statvfs或ctypes库实现跨平台(Windows与Unix/Linux)的磁盘空间查询,适用于系统监控与资源管理场景。
本文深入解析Python中if-elif-else语句的使用,对比嵌套if与elif结构的优劣,强调条件判断的执行顺序对结果的影响,并通过分数判定案例演示如何编写清晰的条件逻辑。
本文介绍在Python中利用Pandas库的map函数,对DataFrame中百万级大规模数据进行高效批量映射赋值的方法。通过定义状态字典,将原始状态码如HUMAN_REFUSE等映射为中文结果,并创建新列存储,实现数据清洗与转换。
本文详细讲解 Python Pandas 库中 DataFrame 的行与列选取方法,涵盖 loc、iloc、ix 等常用索引方式。针对读取 CSV 时产生的未命名列问题,提供重命名删除与直接切片剔除两种解决方案,帮助开发者高效处理数据清洗中的边缘情况。
本文探讨在Python中处理包含字符与数值的混合类型NumPy数组(dtype为字符串)时,如何有效提取纯数值数据。由于math.isnan和np.isnan均无法直接处理此类数组,文章提供了两种解决方案:一是转换为列表后过滤但丢失索引;二是利用map生成布尔数组,结合pandas DataFrame保留原始索引信息,从而实现数据与索引的同步过滤。
本文介绍pandas中基于索引进行表连接的方法,涵盖单级与多级索引场景。通过left_on与right_index参数实现列与索引的匹配,并演示如何通过设置how='outer'执行外部连接,同时合并双方索引,确保数据完整性。
本文详解如何利用Python的python-pptx库创建PPT文件。内容涵盖环境安装、基础文字添加、图表插入以及使用预设模板生成报告的方法。通过具体代码示例,展示如何自动化生成包含数据表格和可视化图表的周期性汇报文档,适用于业务数据汇总及项目可视化场景。
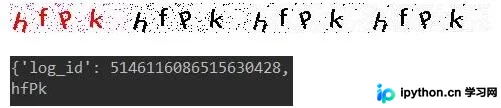
本文介绍利用Python进行验证码识别的完整流程。首先通过PIL库对图像进行灰度转换与二值化处理,去除干扰线及孤立噪点。随后结合百度AI开放平台的通用文字识别接口,获取识别结果并清洗空格与特殊字符,实现自动化验证码解析。
本文介绍使用Python爬取网易新闻评论的方法。针对动态加载的评论数据,通过开发者工具定位API接口,获取JSON格式数据。利用正则表达式剥离回调函数包裹,将JSON转换为Python字典后提取评论信息,并分别抓取热门与最新评论写入文件。