

Python Selenium 获取元素属性、内容及状态判定详解
本文详解在Python Selenium中如何获取DOM元素的属性值、文本内容及状态。通过get_attribute获取自定义属性,利用text属性获取可见文本,使用value_of_css_property读取CSS值。状态判定方面,介绍is_displayed判断可见性,is_selected判断选中状态,以及通过异常捕获或class属性判断元素是否存在与是否真正禁用。
2026-10-13
23

本文详解在Python Selenium中如何获取DOM元素的属性值、文本内容及状态。通过get_attribute获取自定义属性,利用text属性获取可见文本,使用value_of_css_property读取CSS值。状态判定方面,介绍is_displayed判断可见性,is_selected判断选中状态,以及通过异常捕获或class属性判断元素是否存在与是否真正禁用。
本文介绍如何利用Python内置的difflib库中的HtmlDiff类,快速比较两个文本文件的内容差异。通过读取指定文件内容,生成包含高亮差异的HTML格式报告,并自动保存至本地目录。代码包含完整的参数校验、文件读写及异常处理逻辑,适用于日常开发中的文件版本对比场景。
本文介绍如何使用Python实现TextRank算法进行关键词提取。通过结合jieba分词工具,构建词语共现窗口,利用PageRank思想计算节点权重,最终输出高频关键词。文中提供了完整的Python代码示例,包括分词、建图、矩阵计算及结果输出环节,适合NLP初学者参考学习。
本文介绍使用Python skimage库进行连通区域检测的方法。通过measure.label函数对灰度图像进行标记,指定连通性参数,生成包含区域标签的数组。随后利用color.label2rgb将标签转换为彩色图像以便可视化观察,帮助开发者快速实现图像分割效果的调试与展示。
本文基于Python3重构了个性签名生成工具,利用Tkinter构建GUI界面,结合requests获取网页数据,并通过PIL处理图像。代码针对特定网站接口进行了适配,展示了如何从输入文字到生成个性化签名图片的完整流程,适合Python初学者参考学习。
本文深入分析Python 3中整数不溢出的底层实现机制。基于CPython解释器源码,解析长整型(PyLongObject)如何利用动态数组存储任意大小整数。详细阐述以2的15次方为基数的存储策略、加法与乘法的竖式计算逻辑,以及Karatsuba算法的优化应用,揭示Python降低大数据运算门槛的技术基础。
本文详细介绍如何使用Python的Gensim和Jieba库进行文本相似度分析。通过中文分词、构建词袋模型、计算TF-IDF值及稀疏矩阵相似度,实现测试文档与目标文档的匹配度计算。文章包含完整代码示例及结果解读,适合初学者掌握NLP基础流程。
本文介绍NumPy中fromstring函数的使用方法,通过创建长度为16的字符串示例,演示如何将其转换为int8、int16、int32、int64、float32及float64等不同数据类型的矩阵。文章详细解析了ASCII码转换原理及默认数据宽度设置,为处理字符串到数值矩阵的转换提供实用参考。
本文总结Pandas读取CSV文件时常见的OSError错误,主要原因为文件路径包含中文导致无法正确加载。提供两种解决方案:修改为全英文路径或在文件名前添加u前缀,推荐优先使用第一种方案以彻底避免编码问题。
本文详细演示如何使用NumPy的savetxt函数和pandas的to_csv方法将数组数据保存为CSV文件。内容涵盖设置随机种子、生成含NaN值的3x4数组、指定格式与分隔符,以及处理DataFrame列名和缺失值字符串,提供完整的代码示例与参数说明。
本文介绍如何利用Python的scipy库进行最小二乘法曲线拟合。通过定义包含四个参数的逻辑函数,生成含噪声的测试数据,并使用optimize.leastsq函数优化参数。文章包含完整的代码示例及可视化结果,展示如何对比真实值与估计值,适合需要处理非线性数据拟合的开发者参考。
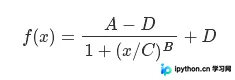
本文详解Python中实现多条件数据筛选的三种方法:内建filter函数、pandas库及普通循环。通过词性标注示例对比代码实现与运行结果,指出filter与pandas在速度上更具优势,适合高效处理结构化数据。