虚拟机中安装Python是否必须联网及下载步骤
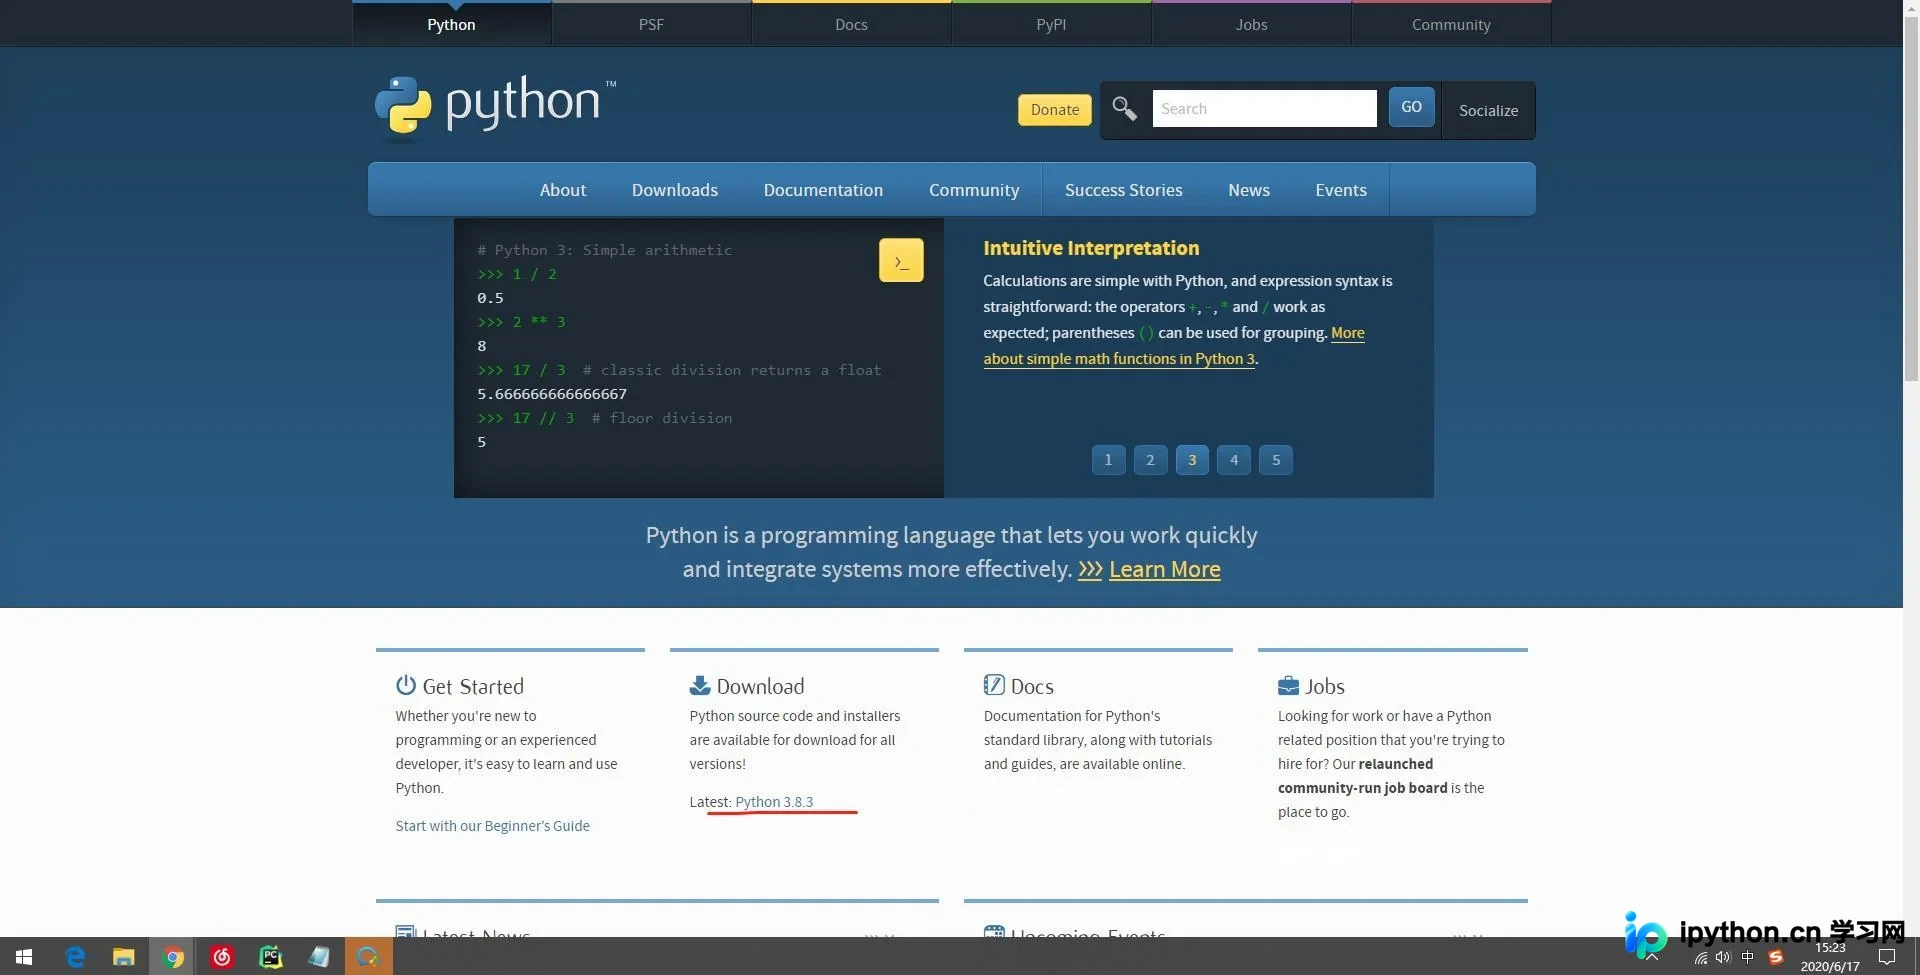
在虚拟机中安装Python通常需要联网,因为官方安装包托管于官网。本文简述了通过访问python.org官网,点击Download选择对应版本,并在页面底部找到并下载第一个推荐选项的方法。若需离线安装,建议提前在联网环境下载完整安装包及依赖。
2026-10-14
23

在虚拟机中安装Python通常需要联网,因为官方安装包托管于官网。本文简述了通过访问python.org官网,点击Download选择对应版本,并在页面底部找到并下载第一个推荐选项的方法。若需离线安装,建议提前在联网环境下载完整安装包及依赖。
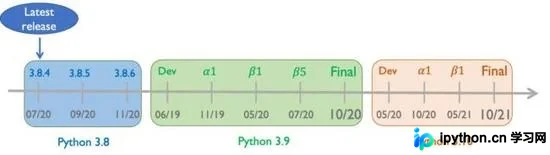
本文梳理了Python 3.8至3.10的开发时间线,重点解析Python 3.10的四大核心更新:引入返回二进制中1的个数的bit_count()方法;为zip函数添加strict参数以强制检查迭代器长度;赋予字典keys/values/items视图mapping属性以获取只读代理;以及移除collections模块中ABC的向后兼容别名。
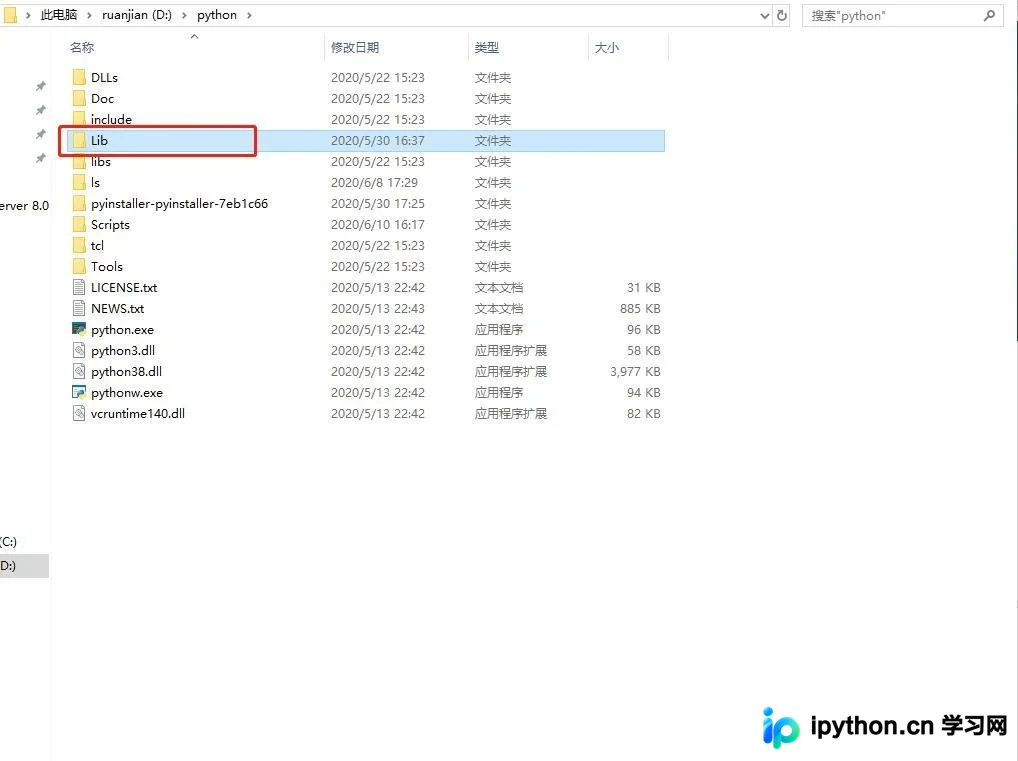
本文详细介绍Python下载库包的默认存放路径,即安装目录下的Lib\site-packages文件夹。同时深入讲解如何构建自定义依赖包,包括配置__init__.py文件、指定导入类以及在实际程序中调用自定义包的完整步骤,帮助开发者解决本地模块导入问题。
本文解析Python中利用Selenium获取浏览器窗口句柄的方法。通过driver.window_handles获取所有窗口标识列表,并使用driver.switch_to.window切换至指定索引窗口,实现多标签页下的页面爬取与交互。
本文详细介绍Python中获取数字绝对值的三种常用方法:通过条件判断手动实现、使用内置abs()函数以及调用math模块中的fabs()函数。文章包含完整的代码示例、语法说明及运行结果分析,帮助开发者根据实际需求选择最合适的实现方式。
本文介绍如何在Python中通过sys模块的exc_info()方法获取详细的异常信息。该方法返回包含异常类型、实例和回溯对象的元组,结合traceback模块可打印完整的错误堆栈,包括文件名、行号及具体代码,从而辅助程序调试与问题定位。
本文详解在Python中读取并执行SQL文件的完整步骤。首先利用内置open函数加载.sql文件内容,通过join方法转换为字符串;接着使用pymysql建立MySQL数据库连接;最后调用pandas的read_sql函数执行查询。文章提供代码示例,涵盖文件路径处理、字符集设置及连接关闭等关键细节,帮助开发者高效实现SQL脚本的自动化执行。
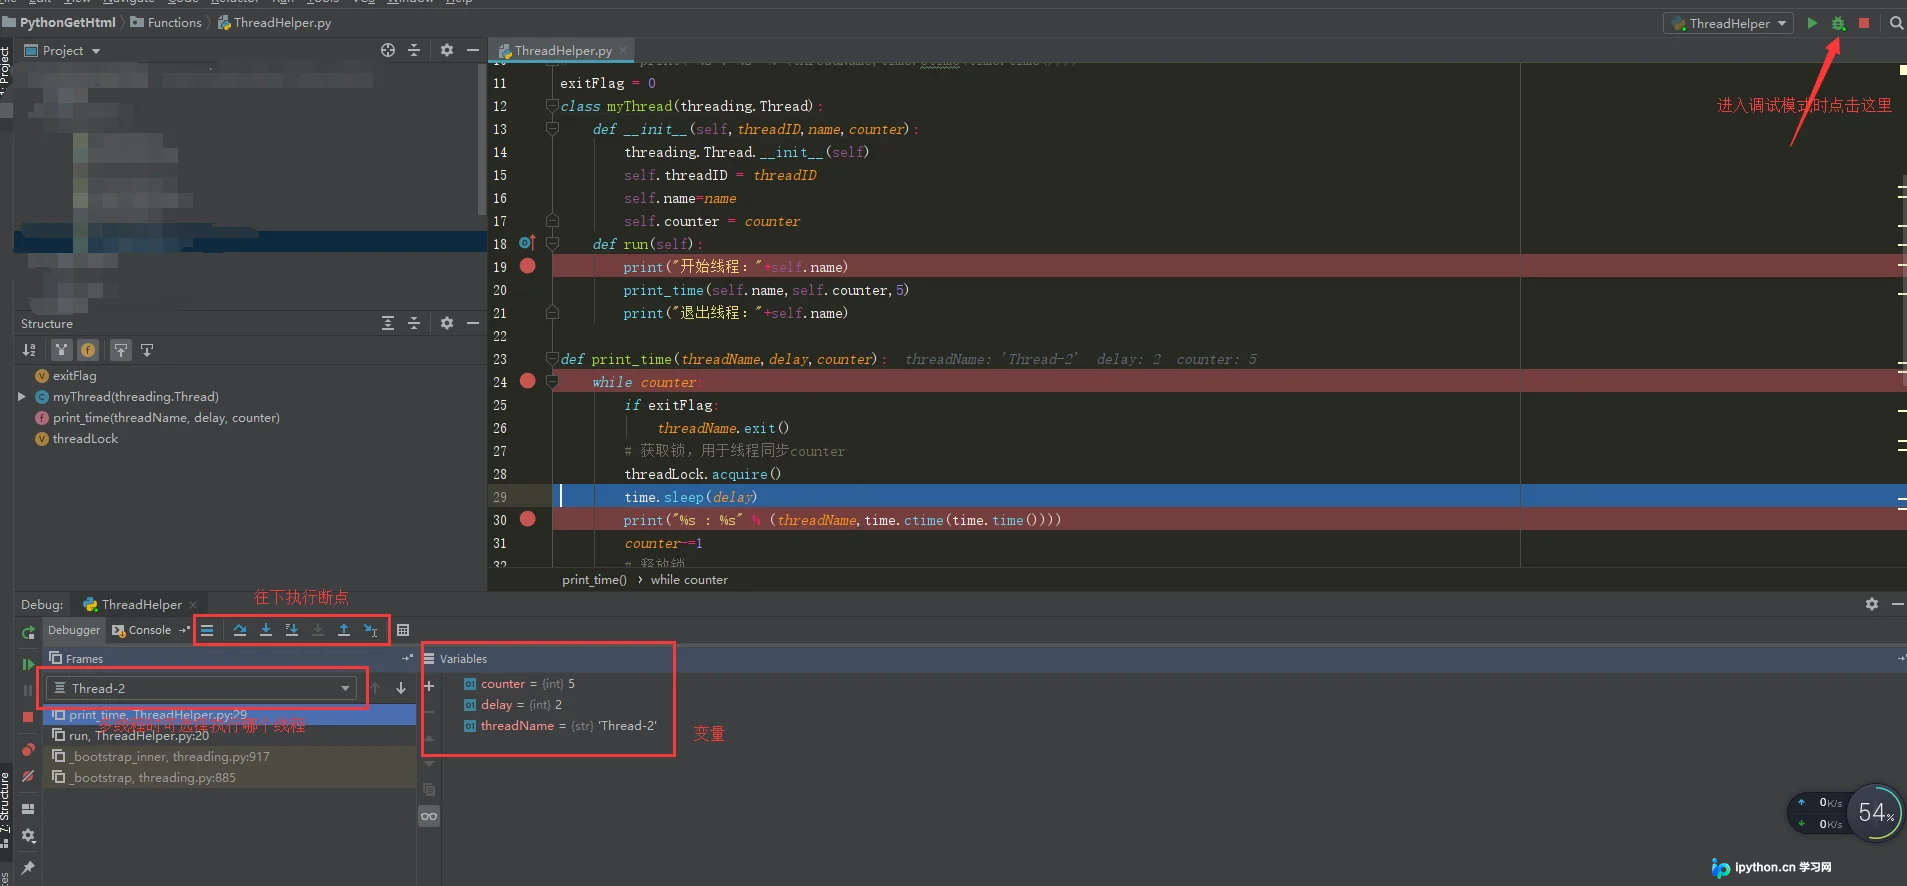
本文详细介绍 Python 3.7 的调试方法。首先演示如何在 PyCharm IDE 中设置断点、查看变量及使用表达式求值进行代码追踪。随后针对无法安装 IDE 的测试服务器场景,介绍三种命令行调试工具:内建的 pdb 模块、日志调试库 PySnooper 以及断点调试器 breakpoint()。通过具体代码示例,帮助开发者掌握本地与远程环境下的调试技巧。
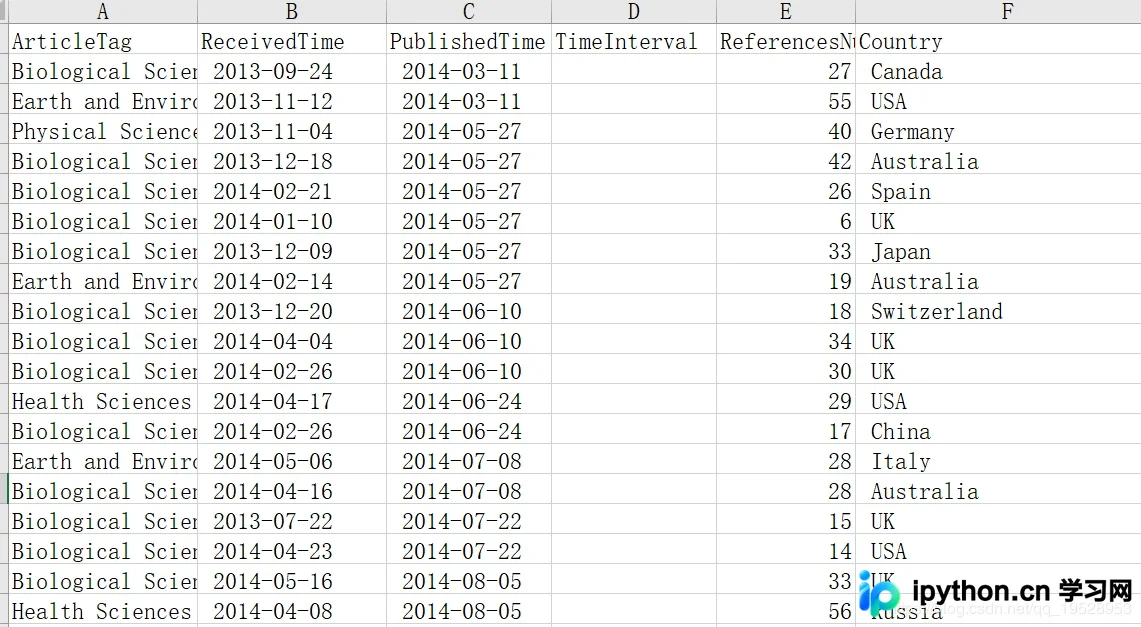
本文深入解析Pandas库中自由度最高的Apply函数。详细讲解如何通过axis参数控制遍历方向,利用自定义函数实现行级或列级数据计算。重点演示如何结合*args和**kwds向Apply传递额外参数,以灵活处理如日期差计算等复杂逻辑,提升数据清洗效率。
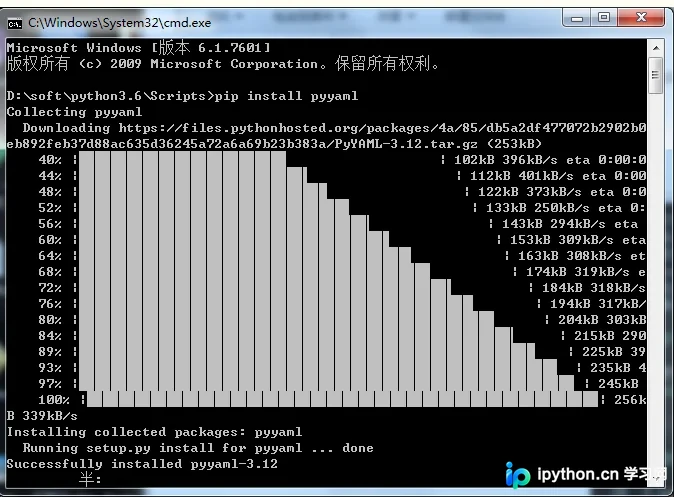
本文详细介绍Python中YAML文件的读写方法。涵盖YAML基础语法规则、字典与列表结构、纯量类型处理及数据类型强制转换。通过PyYAML库的安装步骤,结合嵌套数据读取与文件写入的完整代码示例,帮助开发者掌握自动化测试与配置管理中的YAML应用技巧。
本文详细介绍Python Pandas库中DataFrame的去重操作。通过duplicated方法识别重复行,利用drop_duplicates方法移除重复数据。重点解析keep、inplace、subset等关键参数的用法,涵盖完全去重与指定列去重两种场景,帮助开发者高效处理数据清洗任务。
本文介绍在Python中使用Pandas库删除DataFrame中指定列包含空值(NaN)行的多种实现方式。主要方法包括使用dropna函数的subset参数、布尔索引结合notnull()方法以及query函数。文章提供了具体的代码示例,并对三种方法在大规模数据下的执行效率进行了计时对比,帮助开发者选择最优的数据清洗方案。