

Python抓取网页源码的两种实现方式
本文介绍使用Python获取网页源码的两种方法。首先演示利用requests库直接获取指定页面的HTML文本,并处理编码问题;其次展示结合urllib2与BeautifulSoup进行全站链接扫描的复杂示例,包括遍历页面、解析锚点、检查链接状态码及计算耗时。
2026-10-14
23

本文介绍使用Python获取网页源码的两种方法。首先演示利用requests库直接获取指定页面的HTML文本,并处理编码问题;其次展示结合urllib2与BeautifulSoup进行全站链接扫描的复杂示例,包括遍历页面、解析锚点、检查链接状态码及计算耗时。
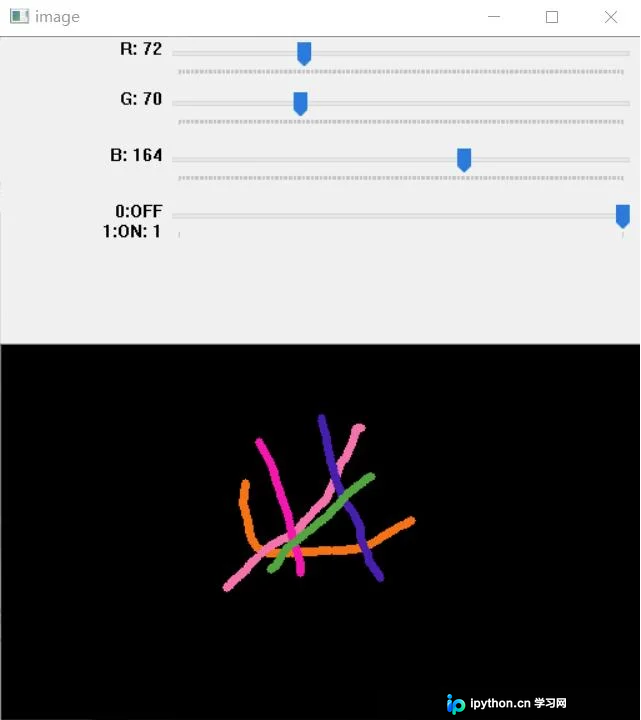
本文介绍如何使用OpenCV和Python构建一个简易画板程序。通过cv.createTrackbar实现RGB颜色调节,利用cv.setMouseCallback处理鼠标点击与移动事件,结合主循环完成图形绘制。文章详细解析了颜色滑块、鼠标回调及主函数逻辑,提供完整代码供参考学习。
本文介绍如何在Python中通过重新定义__str__()和__repr__()方法来改变实例的字符串显示。__repr__()用于生成代码可重建对象的表示,通常由repr()调用;__str__()用于生成用户友好的可读字符串,由print()和str()调用。合理实现这两个方法能显著提升调试效率和日志可读性。
本文深入解析Python中Django框架的核心机制,涵盖其“包含一切”的设计理念、MTV架构模式及完整请求处理流程。详细列举ORM、URL分发、缓存等核心组件,并客观分析其开发效率高、文档完善等优势,以及系统耦合度高、模板功能受限等缺点,帮助开发者全面评估Django在复杂网站开发中的适用性。
本文提供Django框架的自学路径与核心操作指南。内容涵盖Python基础、前端及Linux等前置技能,解析Django数据库、后台管理及模板系统等特点。详细列出项目创建、App开发、数据库迁移、超级管理员设置及数据导入导出等关键命令,帮助开发者快速掌握Django开发流程。
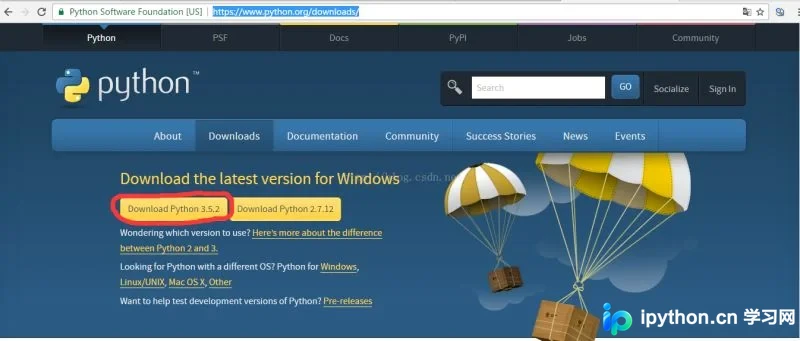
本文提供Python与PyCharm的完整安装教程。详细讲解从官网下载Python安装包、自定义安装路径及验证环境,到下载配置PyCharm集成开发环境的全过程。涵盖项目创建、解释器指定及首个Python文件编写步骤,帮助开发者快速搭建本地开发环境。
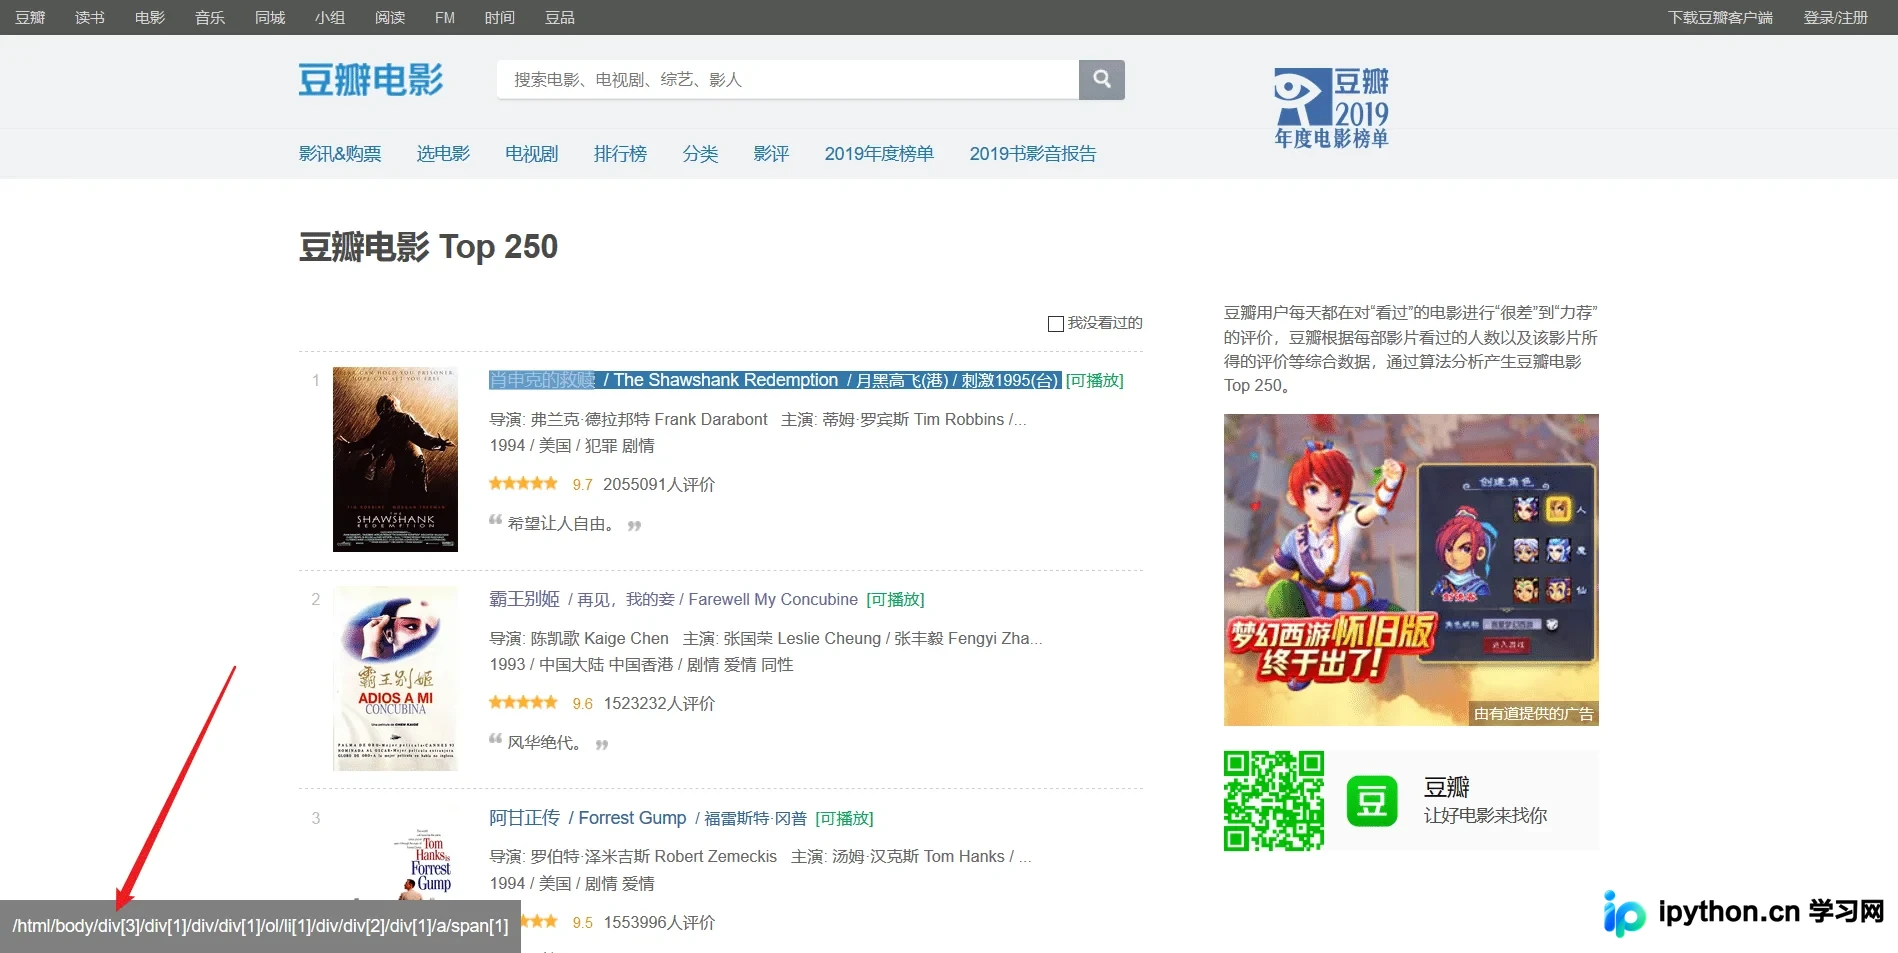
本文详解如何使用Python爬虫技术抓取豆瓣电影Top250榜单数据。通过requests库处理反爬机制,利用lxml进行XPath解析,并结合xlwt库将电影名称、评分及简介等信息批量写入Excel文件。文中包含完整的代码示例及异常处理方案,适合Python初学者参考学习。
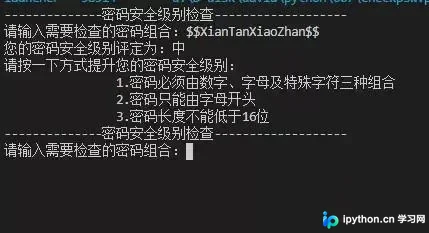
本文介绍如何使用Python编写一个密码强度校验程序。程序依据密码长度(低于8位、8-16位、16位以上)以及是否包含数字、字母和特殊字符进行综合评分,将密码分为低、中、高三个等级。代码实现了循环输入、空值检查及字符类型统计,并在最后给出针对低中等级密码的具体优化建议,如强制包含三种字符、字母开头及长度不低于16位。
本文详细介绍Python中进行程序性能测试的多种方法。涵盖使用Unix时间函数进行整体耗时测试,利用cProfile模块生成详细调用报告,以及通过自定义装饰器和上下文管理器针对特定函数或代码块进行精准计时。此外,还解析了timeit模块在微基准测试中的应用及参数配置,并对比了perf_counter与process_time的区别,帮助开发者选择合适的工具优化代码性能。
本文详解如何在Python中通过jpype1模块调用Java代码。涵盖jpype1的安装方法、JVM路径获取、startJVM关键参数配置(如-ea、-Djava.class.path),以及从编写Java类、导出JAR包到Python中加载调用并关闭虚拟机的完整流程,适用于MacOS及Windows环境。
本文详细解析使用Python编写网络爬虫的基础流程。通过介绍HTTP协议的基本工作原理,演示如何利用requests模块发起GET请求并处理响应头。随后,结合BeautifulSoup库的find与find_all方法,展示如何从HTML文档中精准提取目标标签信息,帮助初学者快速掌握爬虫核心技能。
本文详细介绍Python中如何使用内置csv模块高效读写CSV文件。内容涵盖基础读写、使用命名元组和字典简化字段访问、处理特殊分隔符及编码,以及手动类型转换和错误处理机制,最后推荐Pandas用于高级数据分析。