Python实现强制用户输入数字的三种方法
本文介绍了在Python中强制用户输入数字的三种实现方式。首先分析了使用eval函数的潜在风险,随后提供了基于try-except捕获异常、利用isdigit方法以及针对Python2.x版本的raw_input解决方案。内容涵盖Python3.0及Python2.x环境下的代码调试与注意事项,帮助开发者实现健壮的输入校验逻辑。
2026-10-13
24

本文介绍了在Python中强制用户输入数字的三种实现方式。首先分析了使用eval函数的潜在风险,随后提供了基于try-except捕获异常、利用isdigit方法以及针对Python2.x版本的raw_input解决方案。内容涵盖Python3.0及Python2.x环境下的代码调试与注意事项,帮助开发者实现健壮的输入校验逻辑。
本文深入探讨 Python 文件处理的三种进阶技巧。首先推荐使用 pathlib 模块简化路径操作并兼容旧接口;其次演示如何通过 iter 函数结合生成器实现大文件的高效分块读取,显著降低内存占用;最后讲解如何通过依赖“类文件对象”提升函数的可测试性与通用性,适用于 StringIO 和 subprocess 等多种场景。
本文介绍了在 Python 中利用 xlwt 和 xlsxwriter 库将数据导出为 Excel 文件的两种实现方式。通过 Django 框架示例,展示了如何从数据库查询数据并生成 .xls 或 .xlsx 格式文件,包含单元格样式设置及 HTTP 响应处理,适用于数据量较大或需要复杂格式的场景。
本文深入解析 Python 中 @classmethod 装饰器的使用场景。通过对比直接实例化与类方法工厂模式的差异,展示如何利用 @classmethod 接收当前类作为参数,实现字符串日期到对象初始化的优雅转换。该方法避免了构造函数逻辑冗余,提升了代码的可维护性与重构灵活性。
本文详解Python中修改文件的两种核心机制:全量加载内存后覆盖与逐行读取重写。通过对比全量处理与逐行处理的代码示例,解析如何利用临时文件配合os模块实现原文件替换,帮助开发者根据文件大小选择合适的修改策略。
本文深入解析Python中生成器的本质及其两种构建方式:生成器函数与生成器表达式。详细对比yield与return的执行逻辑,阐述生成器在内存占用上的优势。同时介绍列表推导式的循环与筛选模式,以及生成器表达式的简洁用法,帮助开发者掌握高效的数据处理技巧。
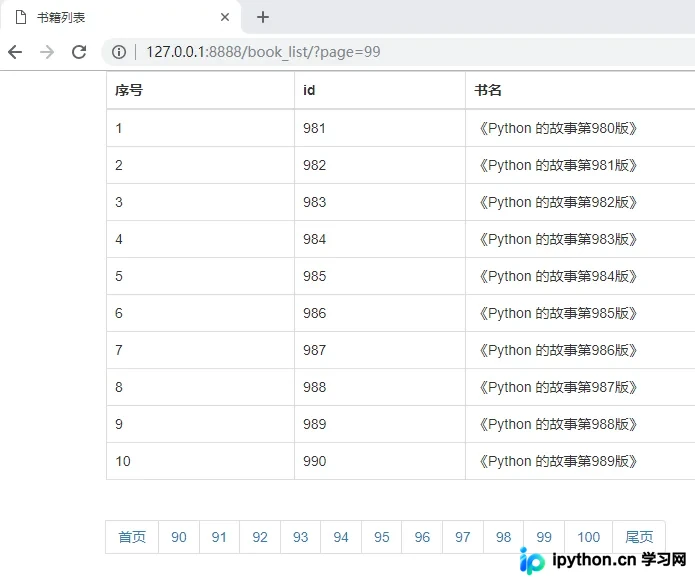
本文详细介绍如何在 Python Django 框架中实现高效的分页功能。通过修改 views.py 与 book_list.html,演示如何添加首页、尾页、上一页及下一页按钮。重点讲解如何处理 URL 中 page 参数的异常值(如非数字或负数),确保系统稳定运行。
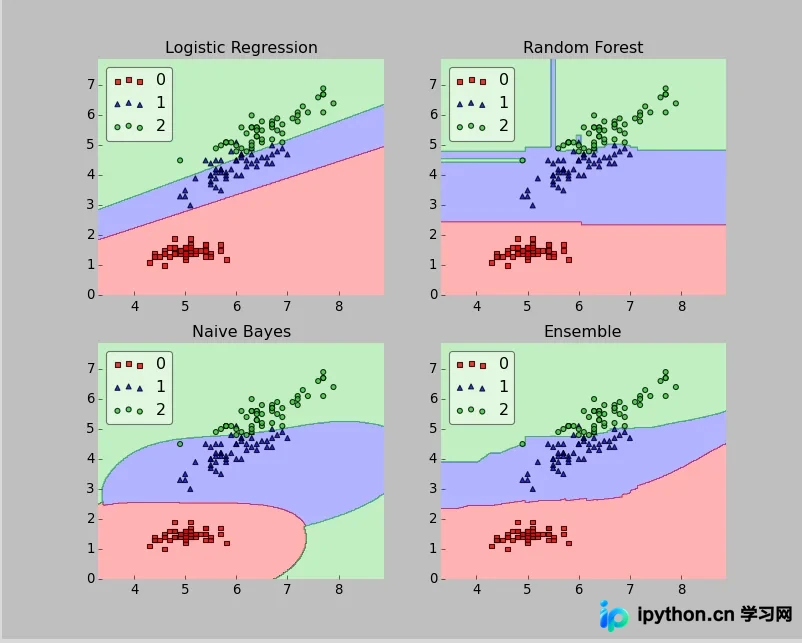
本文详细介绍Python机器学习库mlxtend的安装与配置过程。涵盖基础pip安装、Linux环境下matplotlib和scipy等核心依赖的apt-get解决方案,以及使用iris数据集运行集成分类器示例的完整代码。适合希望快速体验mlxtend内置数据与可视化功能的开发者参考。
本文详细介绍Django中URL配置的两种常见方式:通过GET参数传递数据和使用正则表达式捕获路径参数。重点讲解如何利用name属性结合reverse函数实现URL的动态获取与页面跳转,确保在URL规则变更时模板和视图无需硬编码修改,提升代码可维护性。
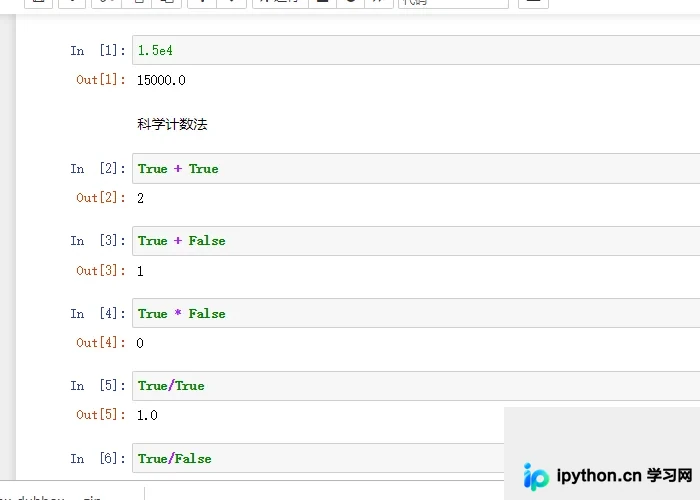
本文详解Python3中的整型、浮点型、字符串及布尔类型,重点解析布尔值的算术运算规则与除零错误。深入讲解int()、float()、str()内置函数的使用细节,包括浮点转整型的截断特性及变量名遮蔽风险,并附带Jupyter重启服务操作指南,帮助开发者掌握基础数据类型处理技巧。
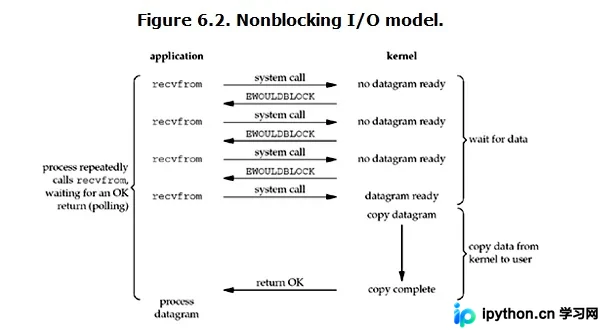
本文深入解析 Python 中非阻塞 IO 模型的工作原理,通过 Linux Socket 示例展示如何设置非阻塞模式及处理 BlockingIOError 异常。文章详细阐述了非阻塞 IO 在单线程并发中的应用,指出了 send 阻塞及 CPU 占用过高等缺陷,并引出 select 多路复用作为更优解决方案。
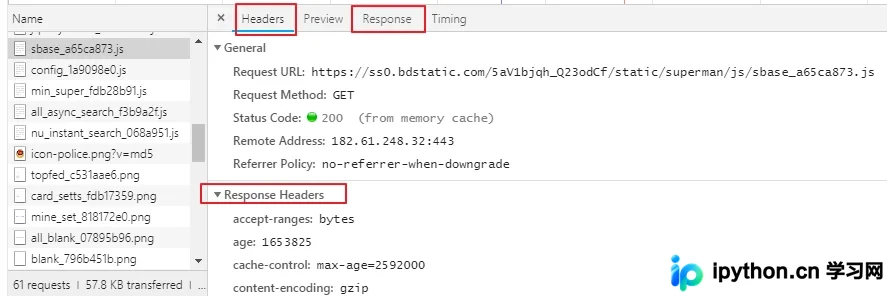
本文详解Python爬虫中User-Agent(UA)的作用及反爬原理。通过对比默认urlopen与自定义Request对象,演示如何获取浏览器UA并封装进headers字典,成功伪装爬虫身份以绕过网站检测。包含搜狗搜索抓包获取UA及完整代码示例,帮助开发者解决基础反爬问题。