Python类详解:成员、修饰符与特殊方法
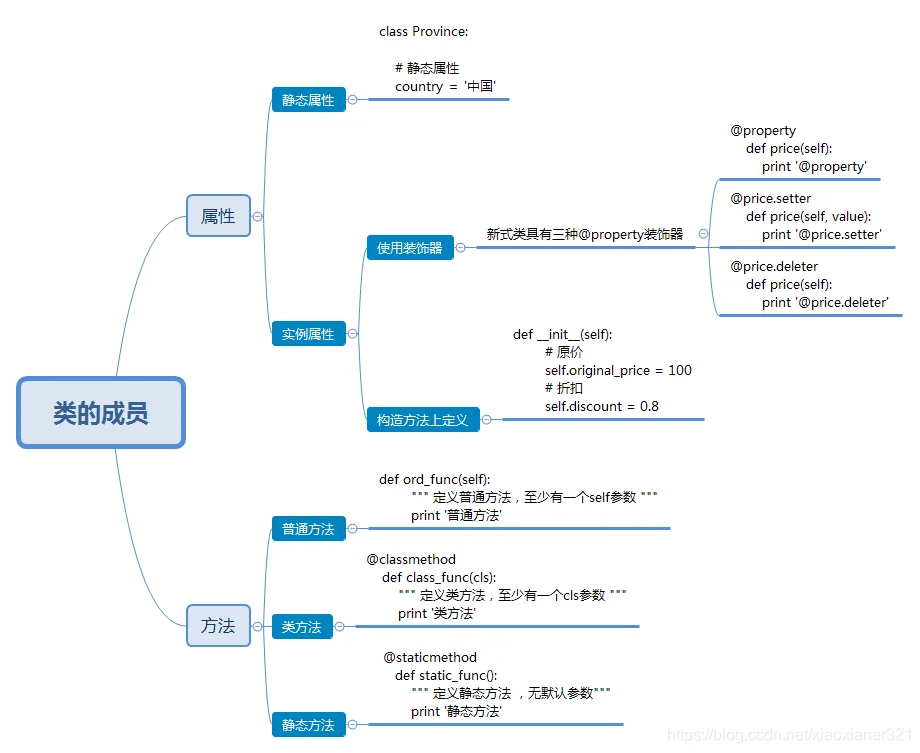
本文详细介绍Python中类的核心概念,涵盖静态与实例属性的区别及创建方式,解析普通、类与静态方法的调用机制,阐述公有与私有成员的访问规则,并系统梳理__init__、__str__等常用特殊成员的使用方法,帮助开发者深入理解面向对象编程。
2026-10-14
24

本文详细介绍Python中类的核心概念,涵盖静态与实例属性的区别及创建方式,解析普通、类与静态方法的调用机制,阐述公有与私有成员的访问规则,并系统梳理__init__、__str__等常用特殊成员的使用方法,帮助开发者深入理解面向对象编程。
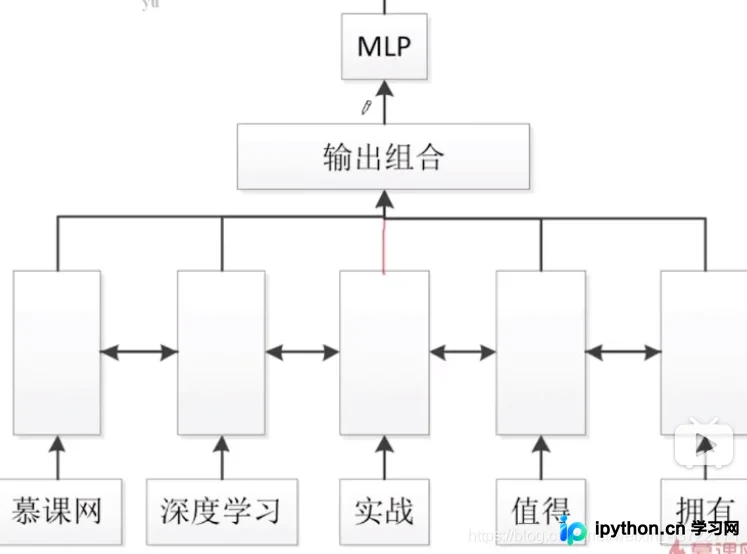
本文详细记录TensorFlow中处理不定长文本序列的读取与解析方法,包括CSV数据拼接策略。深入探讨RNN、双向LSTM在序列预测与标签预测中的输入输出格式差异,解析多任务输出划分、Zero Padding处理及get_shape与tf.shape的区别。重点解决双向LSTM的信息瓶颈问题,提供拼接、平均和池化三种输出处理方案,帮助开发者规避常见踩坑点。
本文介绍使用Python和BeautifulSoup4编写简易爬虫,分别抓取开心网和豆瓣的个人日记。教程涵盖获取浏览器Cookie、配置请求头、处理HTML解析及文件保存等核心步骤,并提供完整代码示例与注意事项。
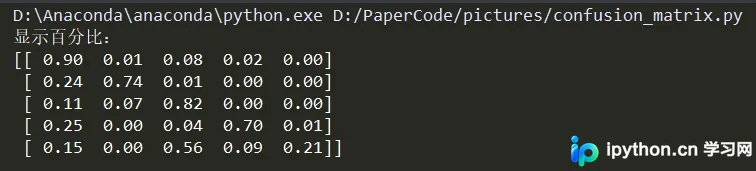
本文介绍如何使用Matplotlib绘制机器学习多分类模型的混淆矩阵,涵盖显示百分比和具体数值两种场景。通过示例代码展示如何配置参数以生成清晰的可视化图表,适用于论文撰写及模型评估分析。
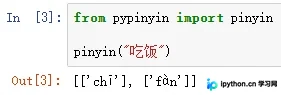
本文详细介绍Python第三方库pypinyin的安装与核心用法。涵盖智能匹配拼音、多音字与繁体字支持,详解Style类中的14种拼音风格(如声调、注音、俄语对照等)。通过示例演示如何处理非汉字字符,并利用load_phrases_dict方法自定义词典以修正特定词汇的拼音标注,实现精准的中文转拼音功能。
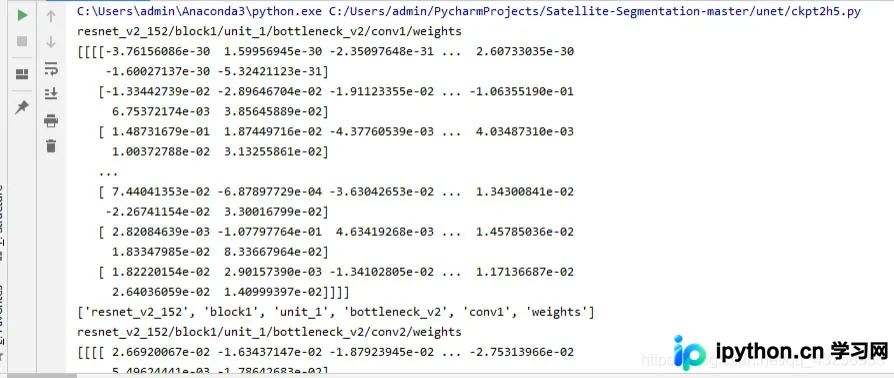
本文详细介绍如何利用TensorFlow的tf.train.NewCheckpointReader函数解读权重文件。通过get_variable_to_shape_map和get_tensor方法获取张量名称及数值,并深入解析ResNet_v2_152模型中tensor name的命名规则,包括block、unit及层类型。同时补充了TensorFlow模型调用过程中checkpoint、graph及model文件的生成机制与查看方法,适用于模型调试与部署参考。
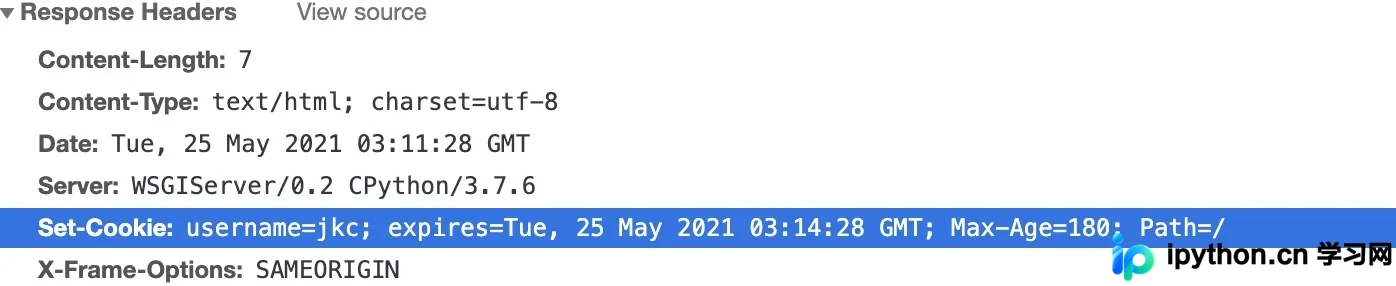
本文详细讲解Django中Cookie的操作方法。Cookie用于解决HTTP无状态问题,存储于客户端且受域名安全限制。文章涵盖Cookie的特点、不可跨域名性原理,并深入解析Django中response.set_cookie()的参数配置,包括max_age、expires、path等。通过实战案例演示如何设置、获取及删除Cookie,并剖析delete_cookie()源码实现机制,帮助开发者掌握Web会话管理核心技能。
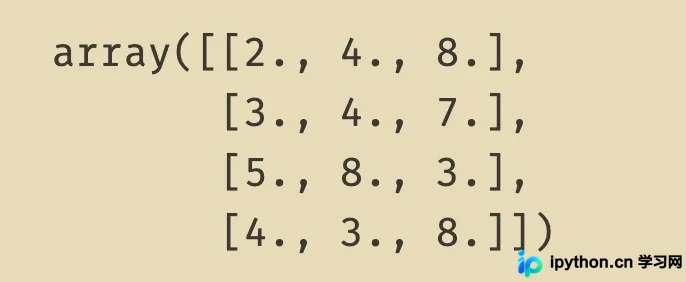
本文介绍如何利用 Python 的 SciPy 库计算定积分与二重积分,重点解析 dblquad 函数的使用及区间参数传递方式。同时结合蒙特卡洛采样与接受-拒绝法,通过数值模拟求解复杂函数期望与积分值,提供完整代码示例与注意事项。
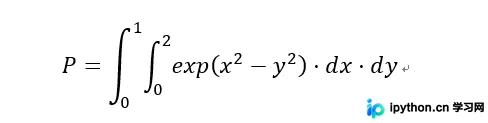
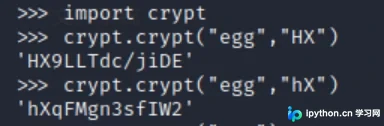
本文详细介绍如何使用Python脚本结合crypt模块对Linux系统进行密码破解测试。通过解析/etc/shadow文件中的加密格式,提取盐值(salt)与哈希算法ID,利用字典文件进行暴力匹配。文章涵盖Python字符串split()方法的深入应用及代码实现细节,旨在帮助安全研究人员理解口令验证机制。
本文介绍如何利用 scikit-learn 0.22 版本新增的 KNNImputer 类,通过 KNN 算法原理对数据集中的缺失值进行高效插补。文章通过简单示例和 Kaggle 皮马印第安人糖尿病数据集的实际案例,详细演示了从导入库、处理零值缺失、设置邻居数到最终填充的全过程,并指出该方法仅支持数值型特征。
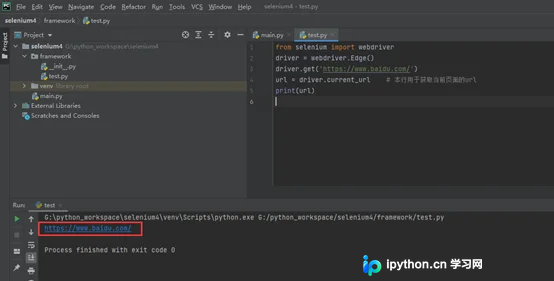
本文详解Python3结合Selenium4进行自动化测试时的浏览器基础操作。涵盖访问指定URL、获取当前页面URL与标题、模拟返回与前进按钮、刷新页面以及窗口大小、最大化、最小化和全屏等常用功能。通过具体代码示例,帮助开发者掌握Selenium4中driver对象的常用方法,提升测试脚本的稳定性与兼容性。
本文详细介绍如何解决 Jupyter Notebook 启动后不自动弹出网页的问题。通过生成配置文件、修改浏览器路径设置,即可实现自动打开指定浏览器。