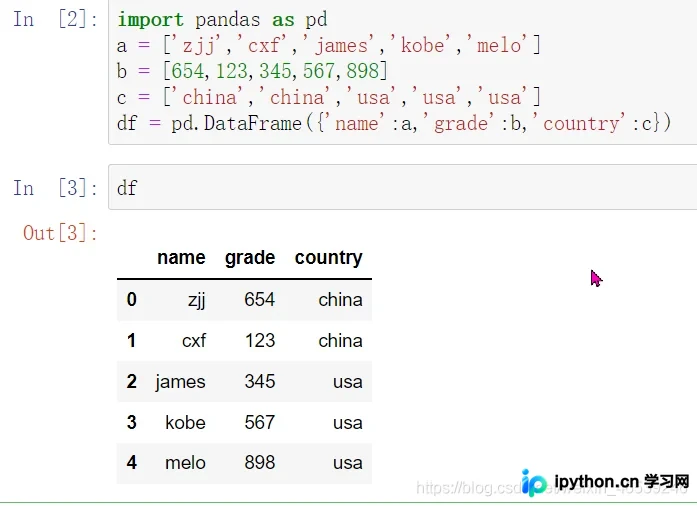
Pandas DataFrame索引排序与重排详解:sort_index与reindex用法
本文详细介绍Pandas中df.sort_index()函数的使用方法,包括默认的升序排列及通过ascending=False实现降序排序。同时讲解df.reindex()如何自定义行和列的索引顺序,涵盖axis参数及具体代码示例,帮助开发者高效管理DataFrame数据顺序。
2026-10-15
24

本文详细介绍Pandas中df.sort_index()函数的使用方法,包括默认的升序排列及通过ascending=False实现降序排序。同时讲解df.reindex()如何自定义行和列的索引顺序,涵盖axis参数及具体代码示例,帮助开发者高效管理DataFrame数据顺序。
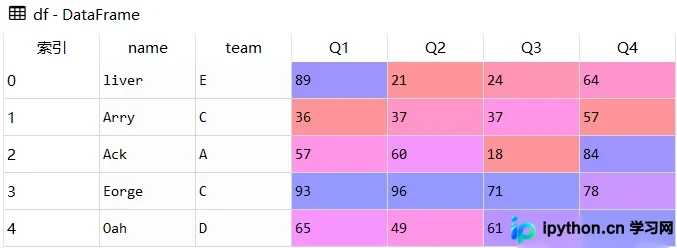
本文深入对比Python中列表与集合的性能差异。通过大O渐进表示法解析时间复杂度,实测发现集合在大数据量查找上远快于列表,但需以更高的内存空间为代价。文章提供具体代码示例与getsizeof测试结果,帮助开发者根据数据规模合理选择数据结构。
本文详细介绍Python中turtle库的基础用法,包括如何安装该库、理解画布坐标系以及掌握画笔控制和图形绘制方法。通过蓝色螺旋正方形和彩色螺旋正方形的具体代码示例,展示如何利用循环和颜色设置绘制出直观的动态图形,适合Python初学者快速入门图形编程。
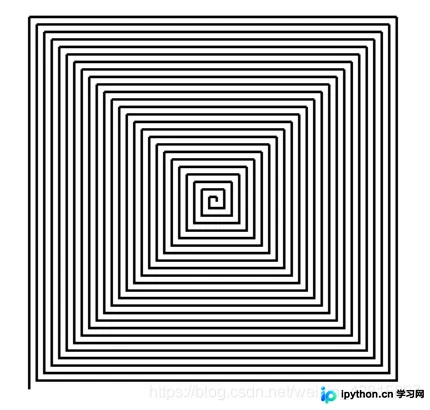
本文介绍Python中利用random模块的random()函数生成[0,1)区间随机数的方法,并通过模拟抛硬币实验展示其实际应用。代码包含统计正反面次数及绘制概率分布图,帮助理解随机数在概率模拟中的使用。
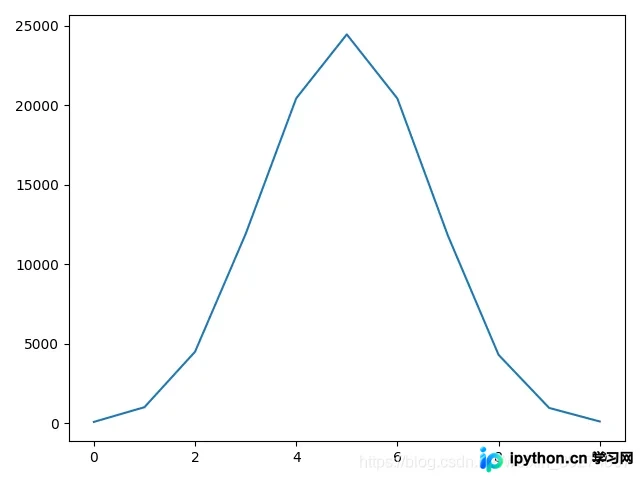
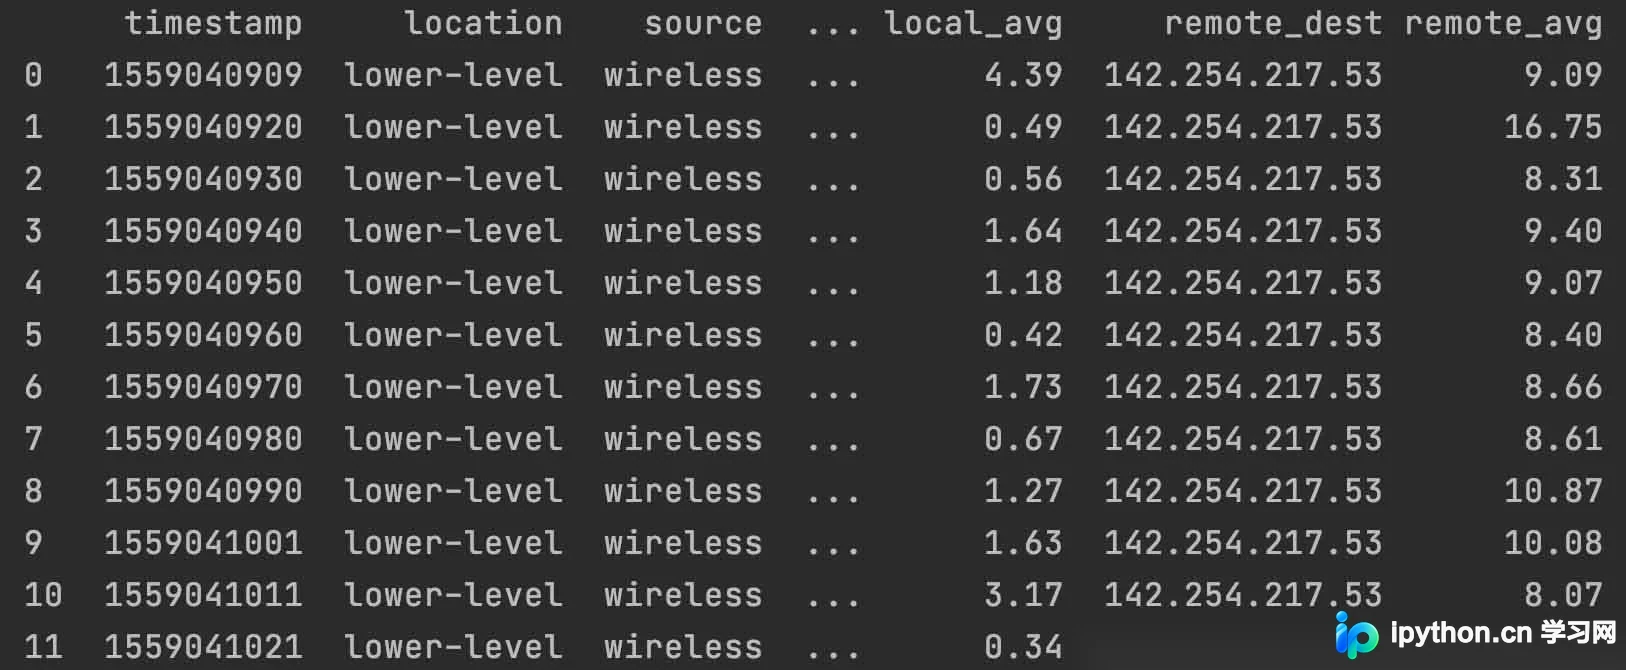
本文详解pandas库中to_datetime()函数的核心用法,重点讲解如何将CSV数据中的Unix时间戳(timestamp)通过指定unit='s'参数转换为标准的datetime格式,并附带代码示例与运行结果分析,帮助开发者高效处理时间序列数据。
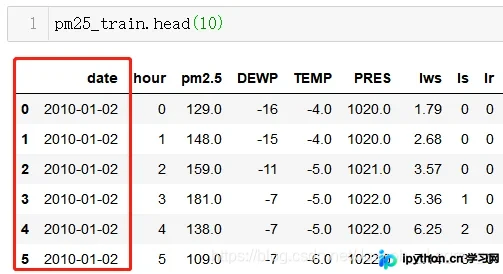
本文介绍如何在pandas中提取Timestamp对象的日期部分,以及处理非数值日期属性的方法。通过调用.date()获取纯日期,或将字符串类型的日期列拆分为年、月、日单独列,以便直接输入机器学习模型进行数据挖掘。
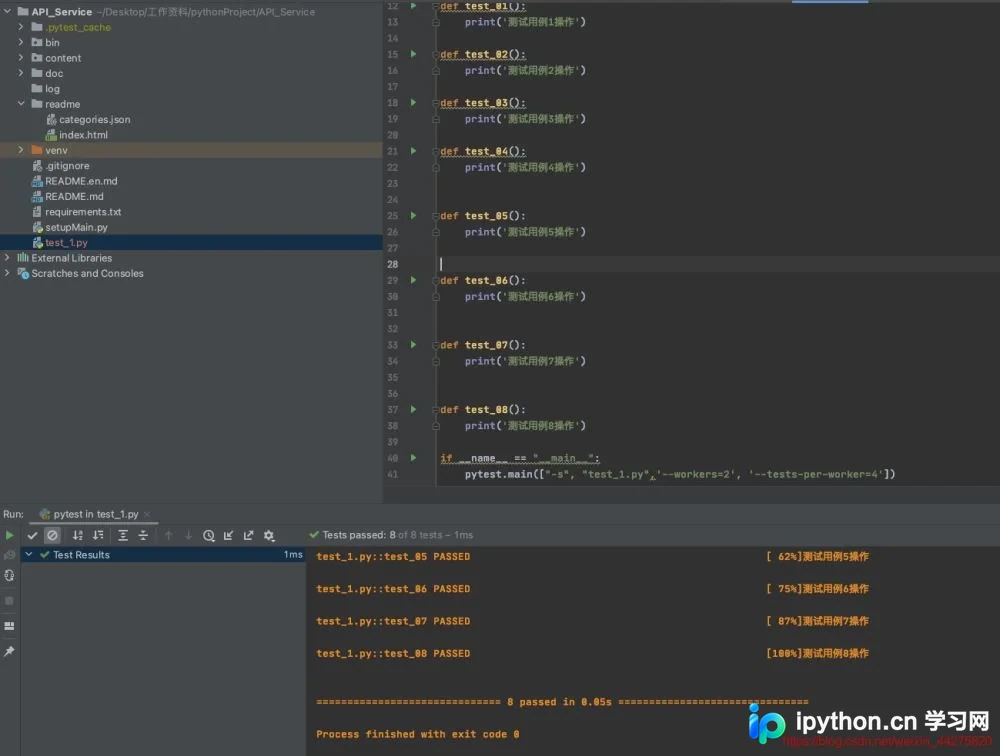
本文详细介绍pytest实现并发测试的两种主流插件:pytest-parallel与pytest-xdist。重点解析pytest-parallel的多进程与多线程混合配置参数(--workers与--tests-per-worker),对比其与pytest-xdist在跨平台支持及功能上的差异,并针对Windows系统限制给出选型建议。
本文介绍如何使用Python将MATLAB数据文件(.mat)转换为PNG图片,以及将图片保存为mat格式。通过调用mat73库读取数据,利用PIL和numpy进行矩阵到图像的转换,并提供完整代码示例,涵盖路径配置、文件夹创建及异常处理,解决常见转换错误。
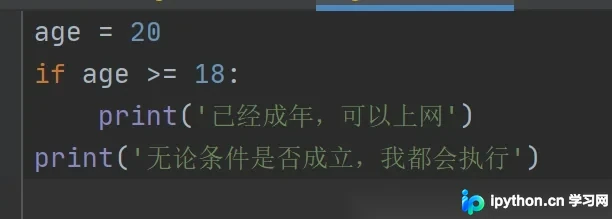
本文解析Python中if语句使用or时的常见误区,指出`if i == 1 or 5`并非判断i是否等于1或5,而是判断表达式真假。详细讲解了正确的多重条件判断写法,包括使用in关键字或重复比较,并补充了if、if-else、if-elif-else、嵌套if及三目运算符的基础用法。
本文介绍如何在 Python 中利用 io 模块的 StringIO 和 BytesIO 类,将内存中的字符串或二进制数据直接作为文件对象上传至 OSS 或 API。通过避免写入硬盘,减少 I/O 开销,提升处理效率。
本文介绍如何利用Python的PyPDF2和pdfminer库,通过少量代码实现PDF文件的永久免费编辑。内容涵盖安装步骤、页面删除与合并、旋转与水印添加、文档加密以及文本提取等核心功能,提供具体代码示例与解析,帮助开发者快速构建自定义PDF处理工具。
本文详细总结了Python Pandas库中增加行列数据的多种常用方法。内容涵盖使用直接赋值、eval计算、insert函数插入指定列,以及利用loc、iloc、append和concat处理行数据。此外,还介绍了通过apply函数结合自定义逻辑新增衍生列的技巧,适用于数据清洗与特征工程场景。