JavaScript事件循环:宏任务微任务执行顺序
从浏览器事件循环的基本模型出发,结合代码执行过程,厘清同步代码、宏任务与微任务的先后关系,并通过可运行示例验证执行顺序,同时总结常见误区与实际开发中的避坑方法。
2026-09-10
13

从浏览器事件循环的基本模型出发,结合代码执行过程,厘清同步代码、宏任务与微任务的先后关系,并通过可运行示例验证执行顺序,同时总结常见误区与实际开发中的避坑方法。
介绍如何使用Sphinx与autodoc将Python源码中的模块、类、函数和文档字符串自动生成结构化文档,覆盖项目配置、自动提取、构建验证以及常见问题排查。
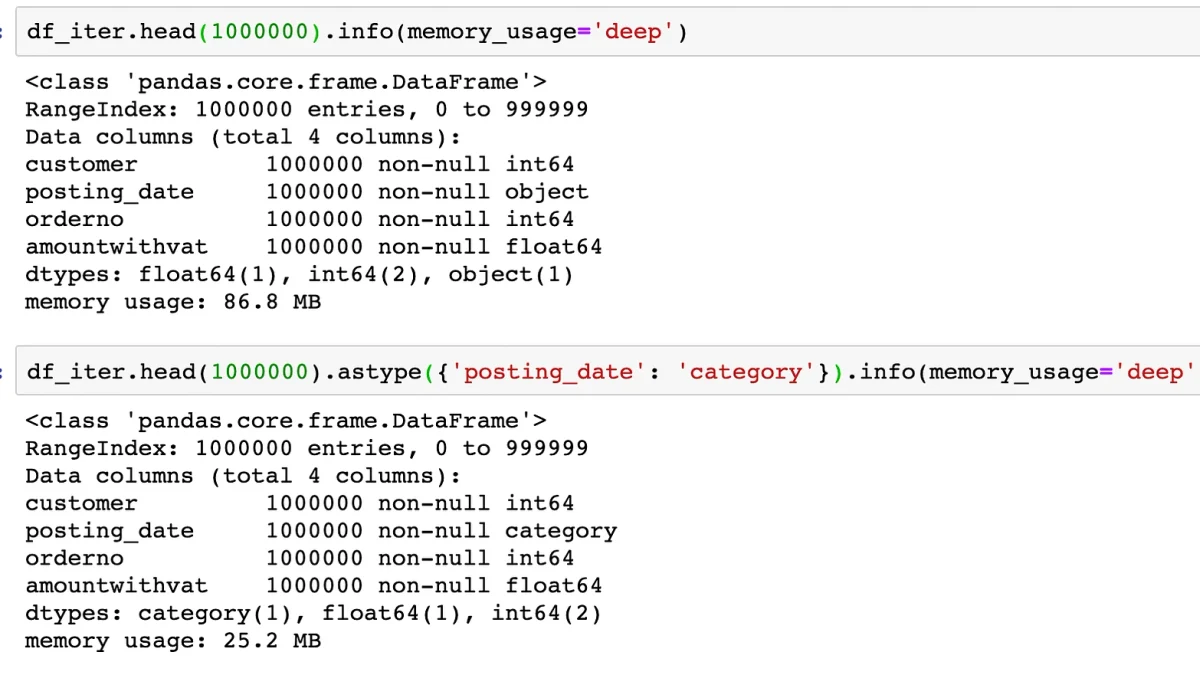
系统介绍 Pandas 处理大规模数据时的内存占用分析、数据类型优化、分块读取与结果验证,帮助读者降低峰值内存并避免常见的数据类型和处理陷阱。
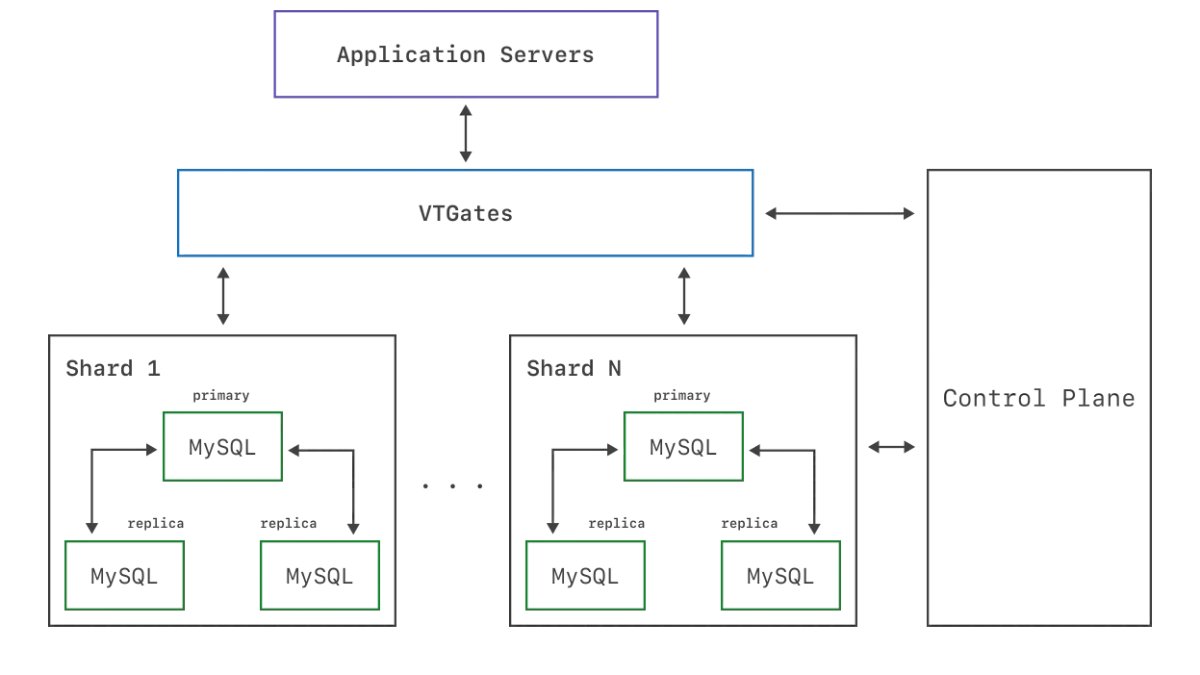
从分库分表的核心概念出发,对比 ShardingSphere 与 Vitess 的架构、分片路由、部署接入、扩容迁移与适用场景,帮助读者完成技术选型并规避常见坑。
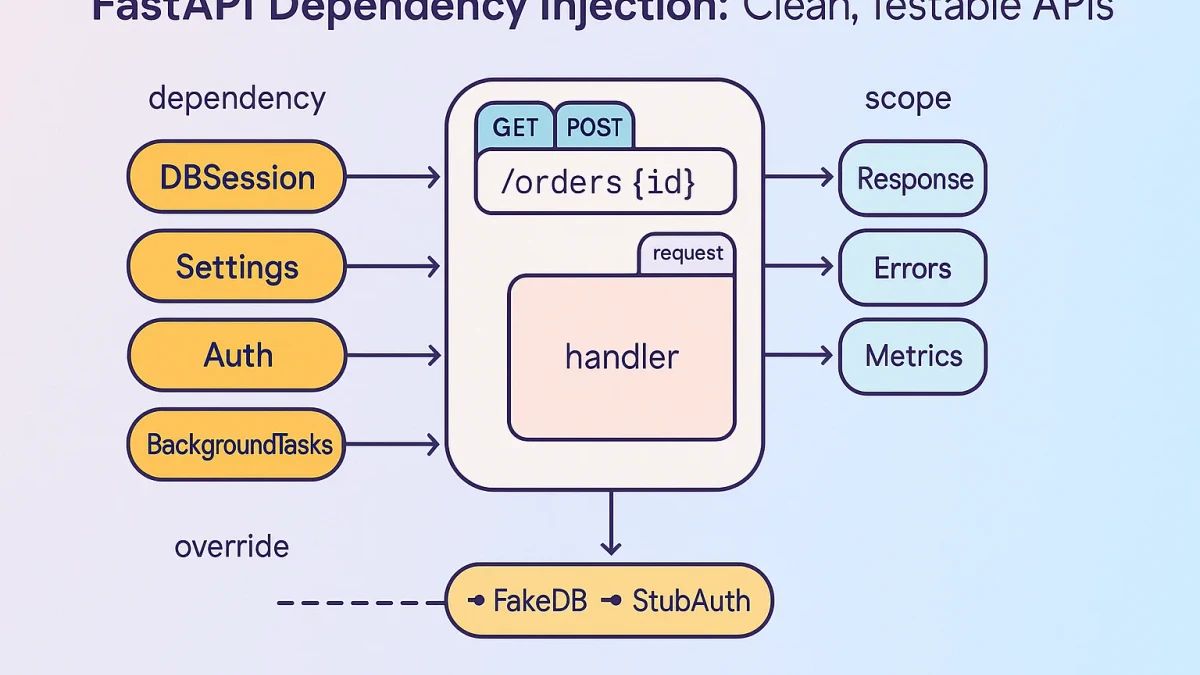
从依赖注入的核心概念入手,掌握 FastAPI 中 Depends 的声明、依赖复用、嵌套依赖与资源管理,并通过实际接口验证执行流程,同时覆盖常见配置与设计误区。
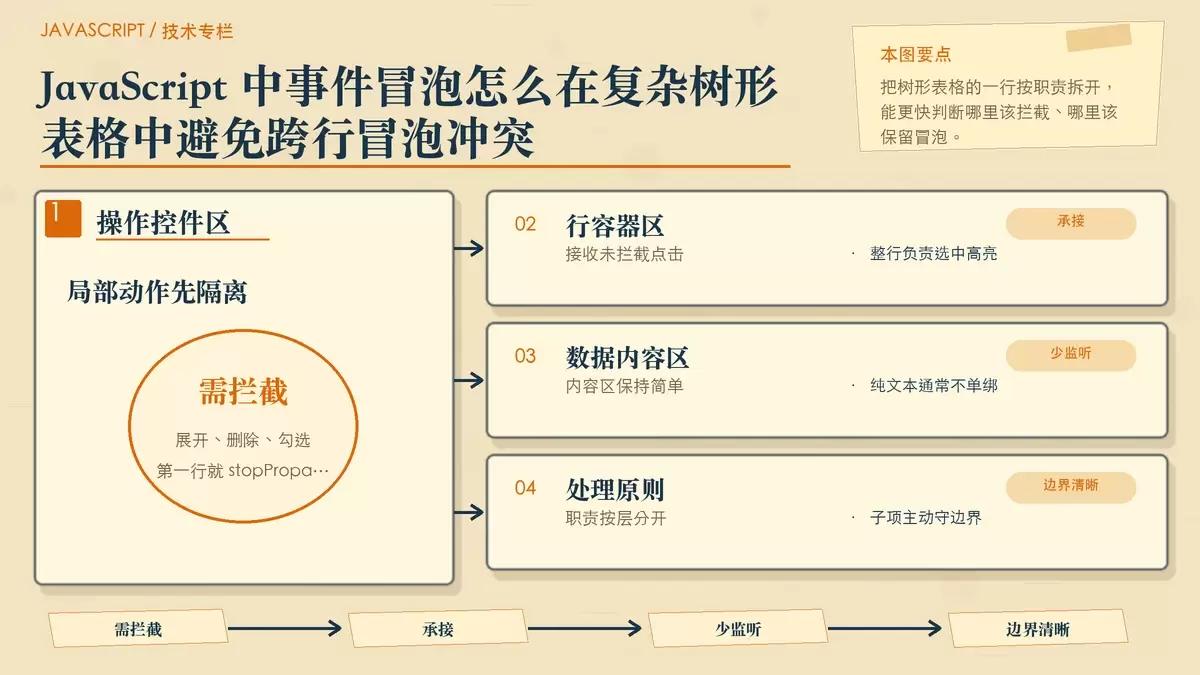
复杂树形表格里的点击冲突,通常不是事件冒泡机制失灵,而是行级交互和局部控件的边界没有划清。处理这类问题的核心是:只在展开按钮、复选框、操作按钮等局部控件上精准调用 e.stopPropagation(),让整行监听继续承担选中、高亮或跳转职责。
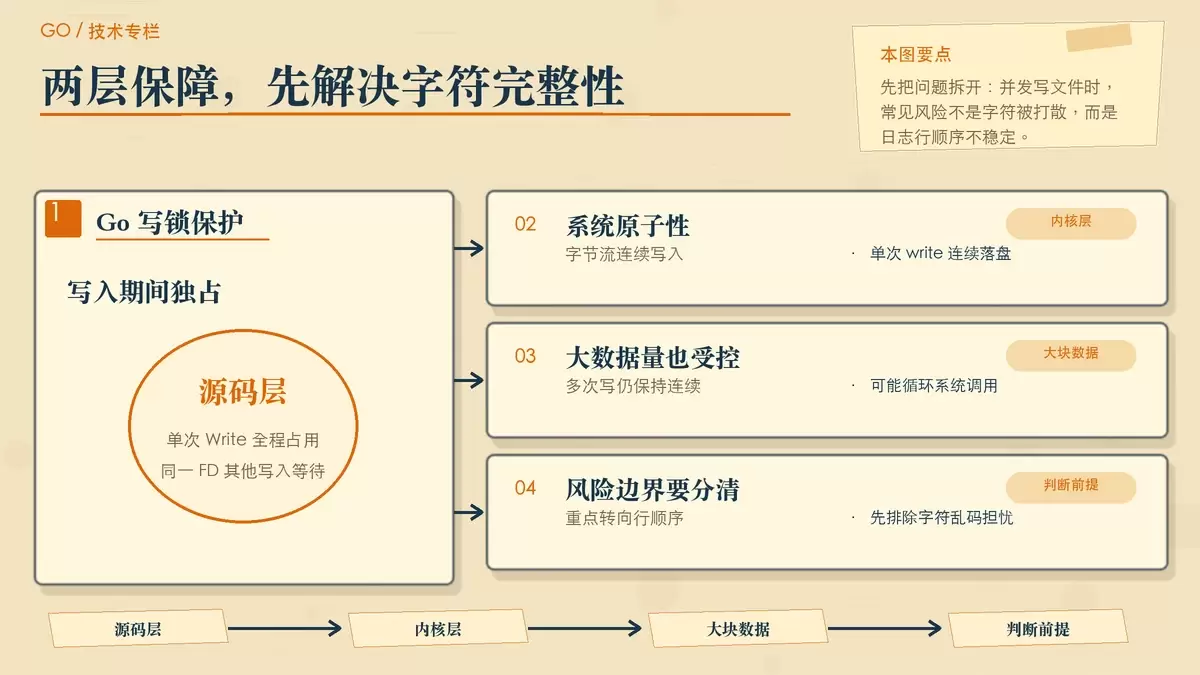
Go 并发写日志到文件时,真正要分清的是“会不会写乱字符”和“要不要保证行顺序”这两件事。底层机制通常能保证单次写入内容完整,但并不能自动保证多 goroutine 的日志顺序。文章结合源码、系统行为和实际场景,梳理什么时候不用加锁、什么时候必须串行化。
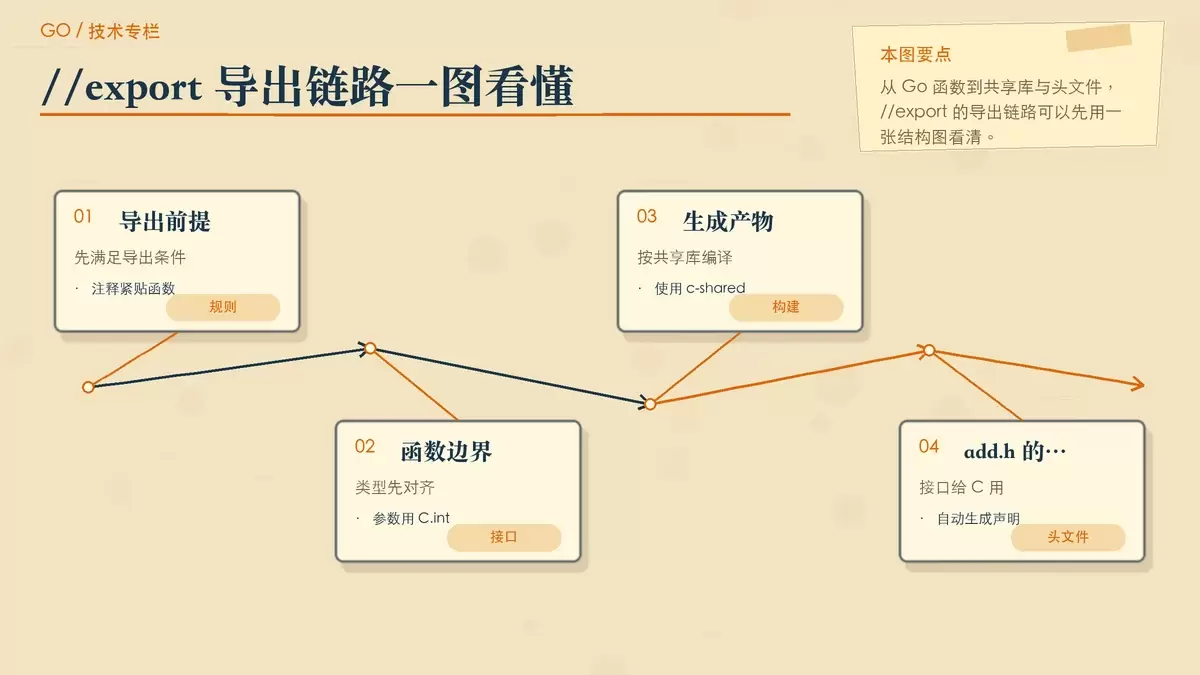
`//export` 是 Go 提供给 C 调用 Go 函数的一条关键通道,但它并不是写个注释就结束。本文用一个最小可运行示例,说明它的语法要求、编译方式、C 侧调用方法,以及内存、类型和平台相关的几个边界条件。
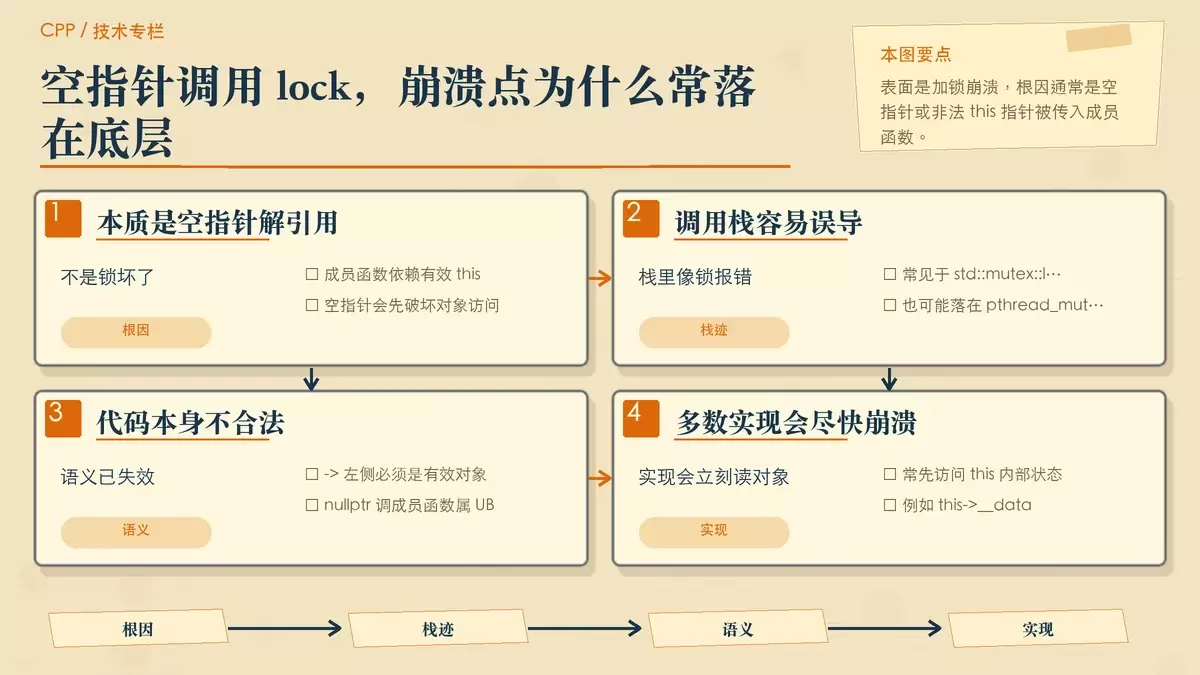
`std::mutex*` 为空时调用 `lock()` 属于未定义行为,表面看像“加锁崩溃”,实际通常是空指针解引用。本文结合典型场景、GDB 与 AddressSanitizer 的排查方法,以及对象生命周期管理的做法,说明这类问题该怎么判断和规避。
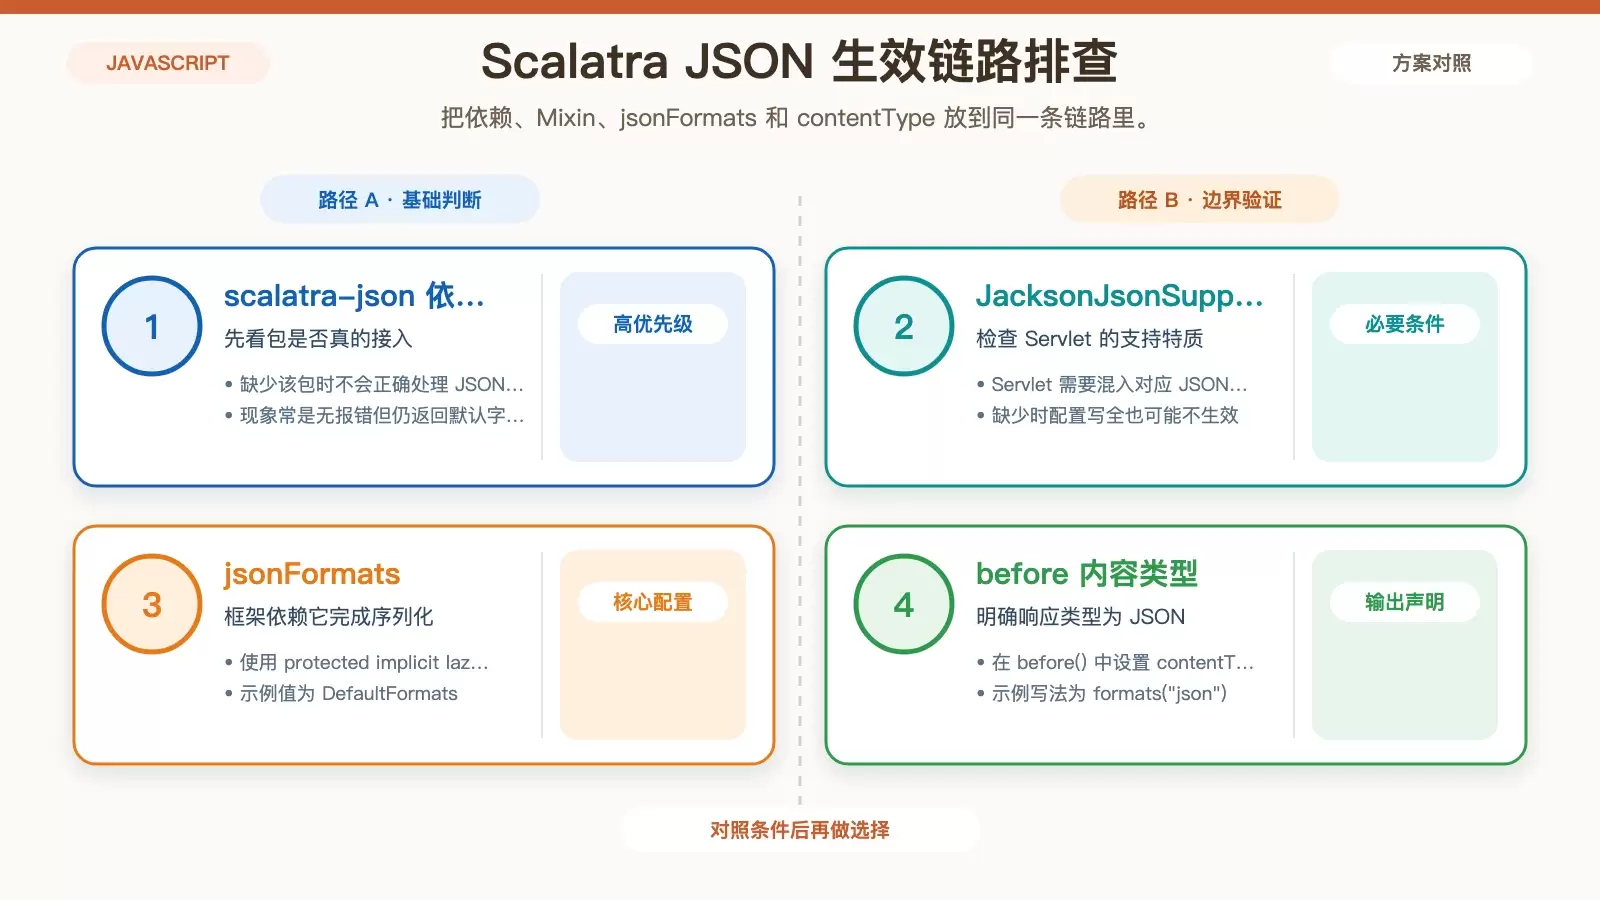
这篇文章围绕 Scalatra 返回 JSON 时最常见的几个问题展开:为什么配置后仍然输出默认字符串、普通类为何不会自动序列化、动态字段和 JSONP 又该怎么处理。文中按实际排错顺序梳理依赖、Mixin、序列化方式与组织建议,便于快速对照落地。
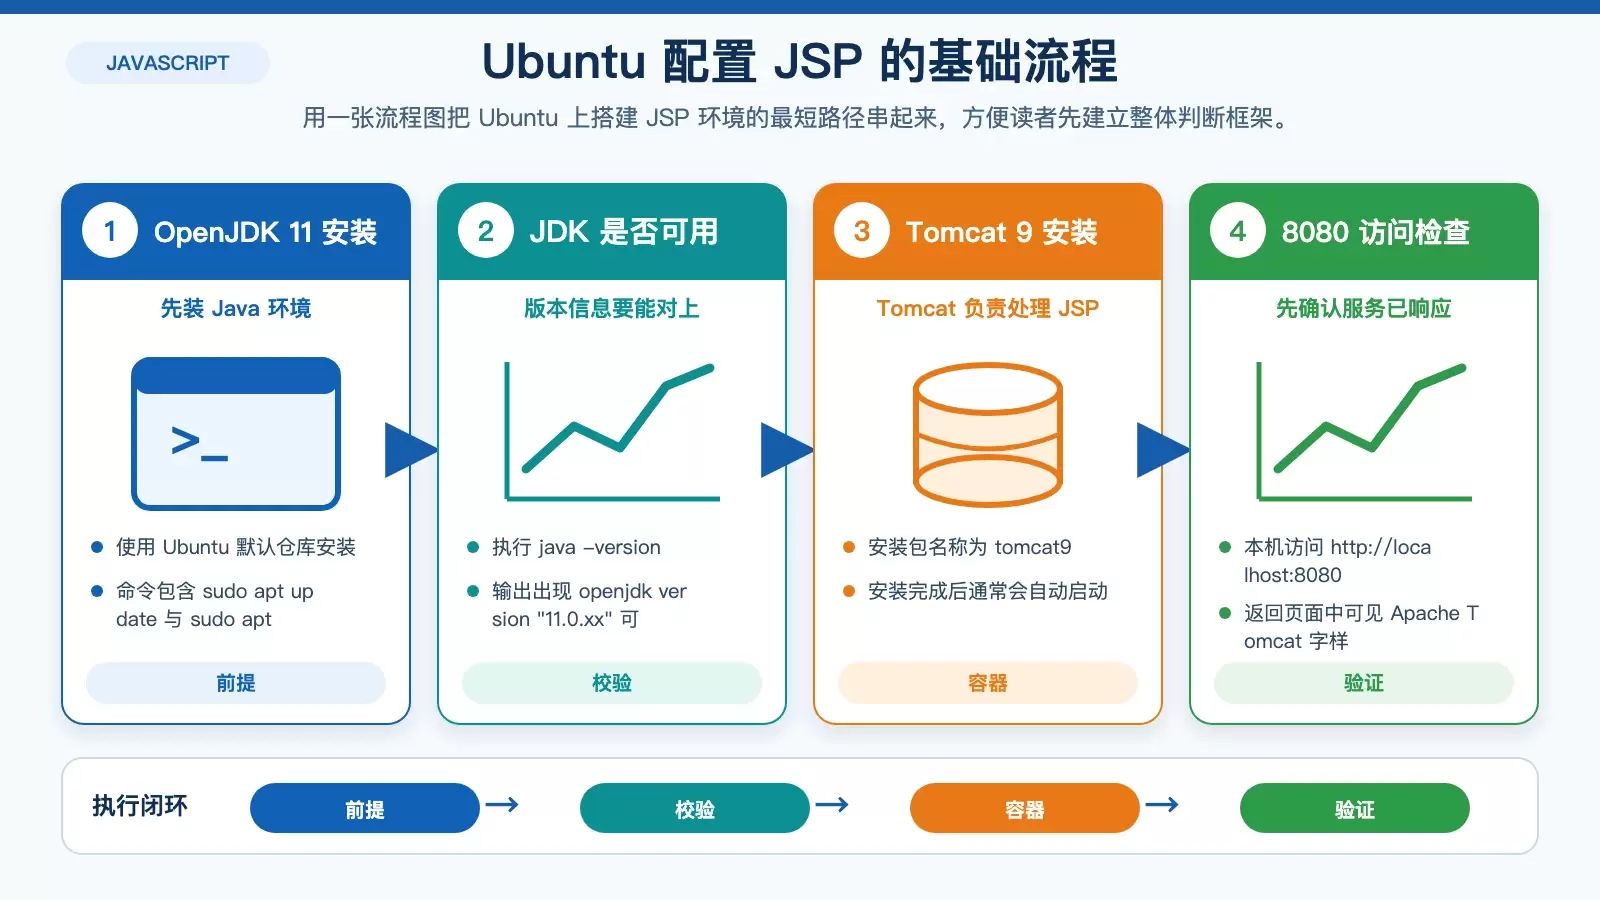
这篇文章把 Ubuntu 上配置 JSP 运行环境的过程拆成安装、验证、部署和排错四步,覆盖 OpenJDK 11、Tomcat 9、关键目录与访问路径。照着执行后,你可以快速判断 JSP 环境是否已经可用,以及问题更可能出在配置、部署还是网络访问。
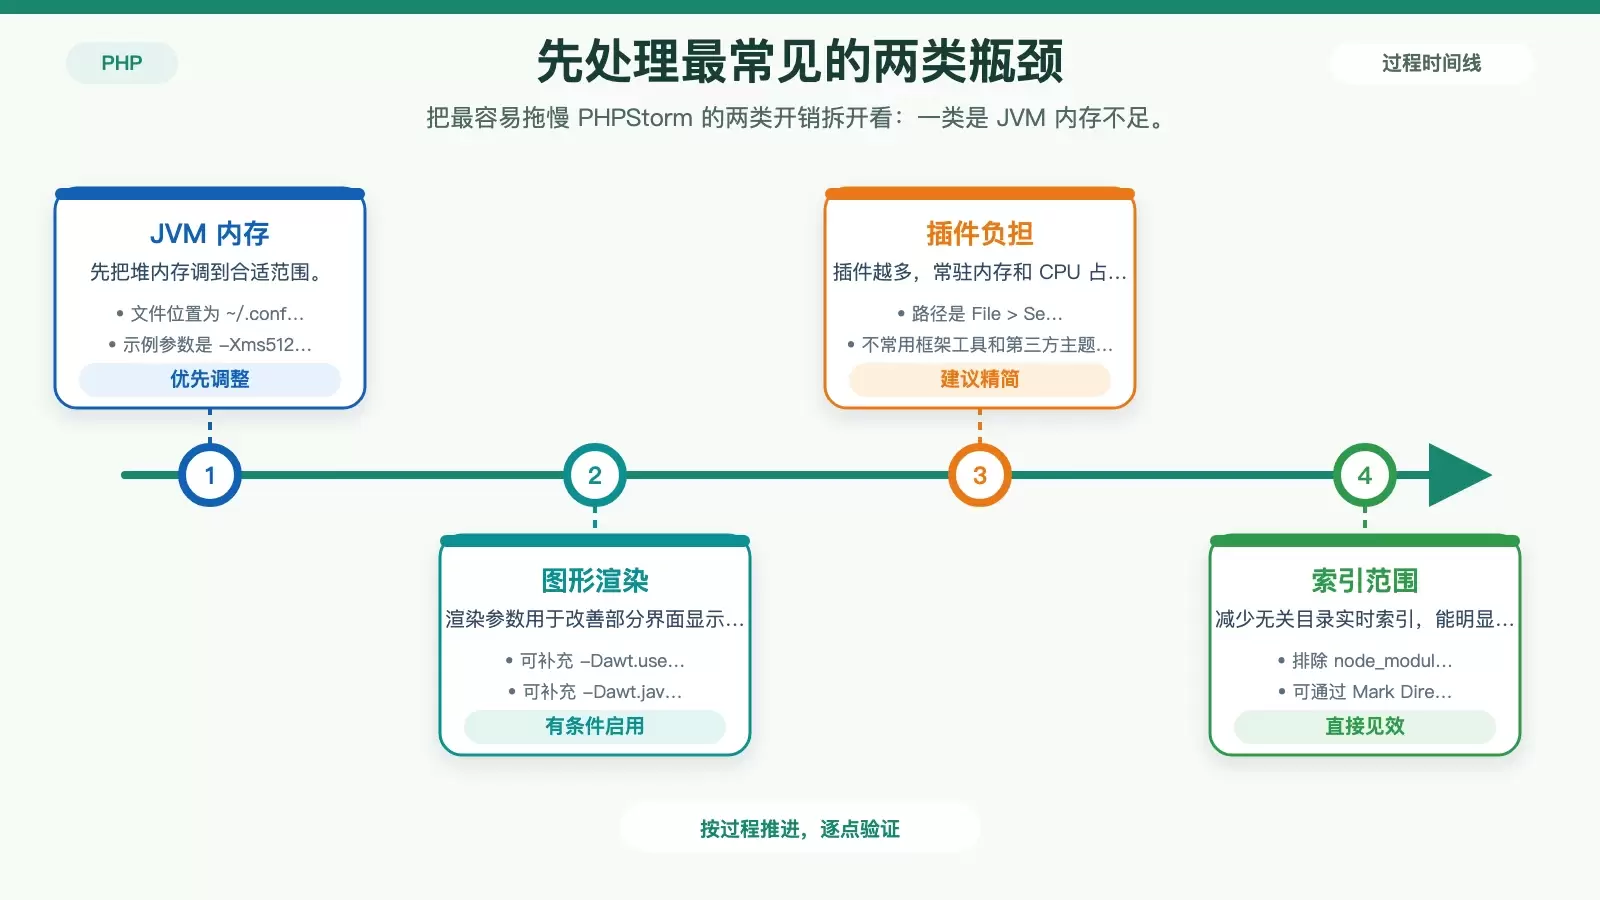
在 Linux 上优化 PHPStorm,优先看内存、索引和插件三类高频瓶颈。本文按“先调 IDE、再查系统、最后看硬件”的顺序整理可直接执行的设置项,并保留关键路径、命令和参数,方便你快速判断该从哪里下手。