

Python与JavaScript核心差异详解:语法、输入输出与内存模型
本文深入对比Python与JavaScript在动态类型、输入输出函数、注释方式、代码块定义及除法运算上的核心差异。重点解析变量赋值时的内存引用机制,通过具体代码示例展示两者在处理数值指向时的不同行为,帮助开发者快速掌握两种语言的关键区别。
2026-10-11
23

本文深入对比Python与JavaScript在动态类型、输入输出函数、注释方式、代码块定义及除法运算上的核心差异。重点解析变量赋值时的内存引用机制,通过具体代码示例展示两者在处理数值指向时的不同行为,帮助开发者快速掌握两种语言的关键区别。
本文介绍Python操作MySQL数据库的三个实用技巧:如何在commit前获取插入数据的自增主键ID,利用MySQL特性自动维护创建和更新时间字段,以及使用pymysql.escape_string处理含引号的字符串以避免报错。
本文详解Python爬取动态网页的两种主流方案:Dryscrape与Selenium。重点讲解Selenium在Ubuntu下的安装步骤,包括geckodriver的下载与路径配置,以及解决Firefox版本兼容性问题。通过代码示例演示如何调用浏览器引擎获取JS执行后的页面源码,并解决常见报错,如模块调用错误及元素定位方法。
本文详解Python爬虫中BeautifulSoup库的数据解析流程。从环境安装、对象实例化到标签定位(find/select)、文本提取及属性获取,结合三国演义小说爬取案例,演示如何解析列表页与详情页,实现指定内容的持久化存储。
本文介绍如何利用Python构建一个可视化的大数据预测集成工具。通过整合sklearn进行多元回归模型训练,结合Tkinter开发GUI界面,实现了从数据读取、模型拟合到预测结果可视化的完整流程。工具支持手动输入与文件批量预测,旨在简化大数据预测的应用门槛,提供直观的决策辅助。
本文分享 Python 编程中的三个实用技巧。首先,通过重写 __repr__ 方法或使用 __dict__ 属性,将默认的对象内存地址输出转化为更易读的字符串形式。其次,利用 json 模块的 dumps 方法结合对象的 __dict__,快速将自定义类实例序列化为格式化的 JSON 字符串。最后,演示如何使用 lambda 表达式对包含自定义对象的列表进行多级排序,支持按单一字段或组合字段(如先名字后键值)进行升序排列,提升数据处理效率。
本文分享Python编程中的三个实用技巧:如何高效创建指定长度的列表,避免使用加号频繁连接字符串,以及在不修改源字典的前提下合并字典。通过对比推荐与不推荐的写法,帮助开发者写出更简洁、高效的Python代码。
本文介绍如何使用 Python 的 multiprocessing 库实现简单的远程过程调用 (RPC)。通过 pickle 序列化函数名与参数,利用 Listener 和 Client 建立连接,配合 RPCHandler 和 RPCProxy 类完成远程函数注册与调用。文章同时深入分析了 pickle 的安全风险,并提供了基于 JSON 的替代方案,确保在内部网络环境中安全使用 RPC 服务。
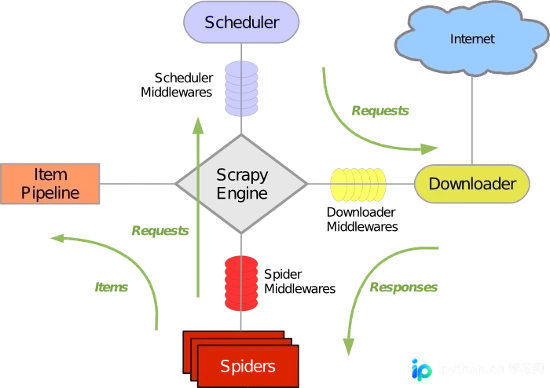
本文详细解析Python爬虫框架Scrapy的核心架构与运行机制。文章系统介绍了Scrapy Engine、Scheduler、Downloader、Spiders及Item Pipeline等关键组件的功能,并梳理了从URL请求到数据存储的完整数据处理流程。同时探讨了基于Twisted的事件驱动模型及各类中间件的作用,帮助开发者深入理解Scrapy的高效抓取原理。
本文探讨学习Python爬虫的实际应用价值,涵盖大数据分析与机器学习的数据源获取。解析网络爬虫工作原理,对比浏览器与爬虫的数据交互差异,并深入分析Python作为爬虫首选语言的技术优势,包括其丰富的标准库、胶水语言特性及高效的执行机制。
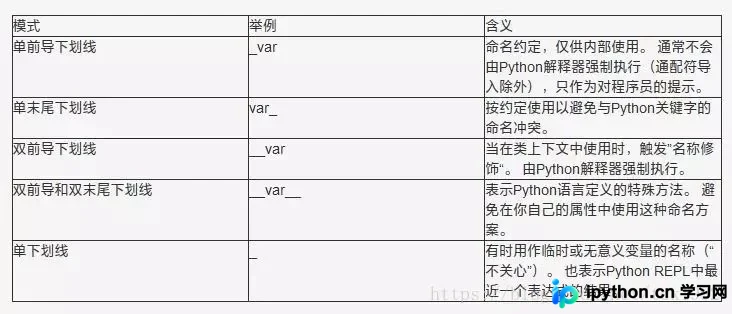
本文详细解析Python中下划线的5种核心含义。涵盖单前导下划线的内部使用约定、单末尾下划线的关键字冲突规避、双前导下划线的名称修饰机制、双端双下划线的特殊方法定义,以及独立单下划线在交互环境和解包中的占位作用。通过具体代码实例,帮助开发者规范命名并理解Python的设计哲学。
本文详细解析Python Mock模块的原理与使用方法。Mock库主要用于模拟对象行为,替代指定Python对象以支持单元测试。从Python 3.3起,Mock已合并至标准库unittest.mock中,无需额外安装。文章通过具体代码示例,展示了如何创建Mock对象、设置返回值以及在实际测试中替换网络请求等外部依赖,帮助开发者高效进行单元测试。