

Python批量读取图像并保存至指定目录的完整实现
本文介绍如何使用Python批量读取包含绝对路径的图像列表,依次进行图像处理,并将结果保存至指定目录。通过读取txt文件获取图像路径,利用Caffe加载图像,处理后使用matplotlib保存至预设文件夹,并统计处理耗时与平均时间,适用于需要批量处理图像的场景。
2026-10-13
22

本文介绍如何使用Python批量读取包含绝对路径的图像列表,依次进行图像处理,并将结果保存至指定目录。通过读取txt文件获取图像路径,利用Caffe加载图像,处理后使用matplotlib保存至预设文件夹,并统计处理耗时与平均时间,适用于需要批量处理图像的场景。
本文介绍如何使用Python的pydub库解决音频格式兼容问题。针对百度语音识别API仅支持pcm、wav等格式,而设备常输出mp3的情况,通过安装pydub及ffmpeg依赖,可轻松实现mp3到wav的转换,从而满足API调用要求。
本文详细对比了Python中两种提取MFCC特征的常用库:Librosa与python_speech_features。重点解析了两者返回数组的形状差异,即Librosa返回(13, None),而python_speech_features返回(None, 13)需转置。通过代码示例与可视化结果,展示了两者在mfcc[0]和mfcc[1]上的具体区别,帮助开发者根据需求选择合适的工具。
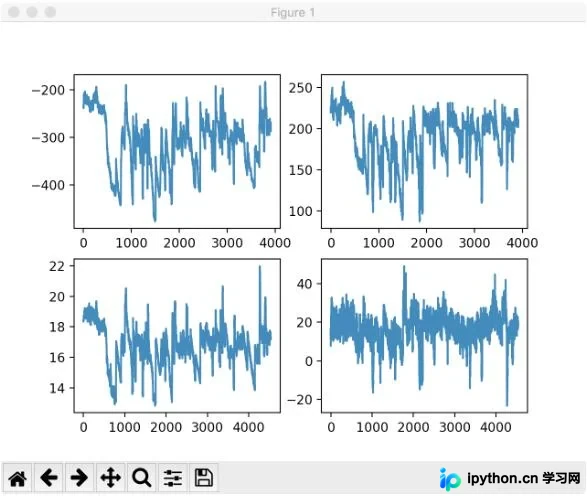
本文介绍Python中查找最小K个数的两种解法。解法1利用Partition函数,平均时间复杂度为O(N),但会改变原数组顺序。解法2采用最大堆维护K个元素,时间复杂度为N*O(logK),适合处理海量数据且保持原数组不变。通过代码示例对比了两种方法的运行时间与内存占用,解法2在性能上更优。
本文介绍在Python中如何使用with语句同时打开多个文件。通过对比嵌套写法、逗号分隔写法以及contextlib.nested方法,详细解析了不同实现方式的优劣。重点强调了在Python 3中推荐使用的逗号分隔多文件打开方式,并指出Python 2中nested函数的使用限制,帮助开发者写出更简洁、安全的文件处理代码。
本文介绍使用Python进行批量文件重命名的两种常见场景。第一种方案通过遍历目录并按序号重新命名文件,需注意os.listdir返回顺序可能不固定;第二种方案针对特定目录结构,将图片与XML文件按对应关系同步重命名为连续序号。代码示例展示了路径处理、文件名拆分及重命名逻辑,适用于日常文件整理需求。
本文介绍如何使用Python将Shapefile(.shp)文件转换为GeoJSON格式。通过shapefile库读取数据,处理字段编码(如gb2312),并将几何对象与属性映射为FeatureCollection。提供完整代码示例,适用于GIS数据格式转换场景。
本文详细介绍在Apache服务器中部署Python WSGI应用的完整流程。涵盖mod_wsgi模块的编译安装、Apache配置加载、Hello World及Flask应用测试,并深入讲解Python虚拟环境的集成方法及.egg包解压权限问题的解决方案,帮助开发者高效完成生产环境部署。
本文介绍如何使用Python的lxml库解析HTML字符串,并通过XPath语法提取元素属性、文本内容及特定节点。通过示例演示了从字符串解析HTML、遍历元素列表、提取文本以及定位特定属性节点的具体实现步骤。
本文介绍如何利用Python的BeautifulSoup库批量从城市美食及景点介绍等HTML页面中提取body标签内的具体内容。通过遍历目录结构并解析文件,实现自动化数据抓取与存储,为后续数据处理提供基础。
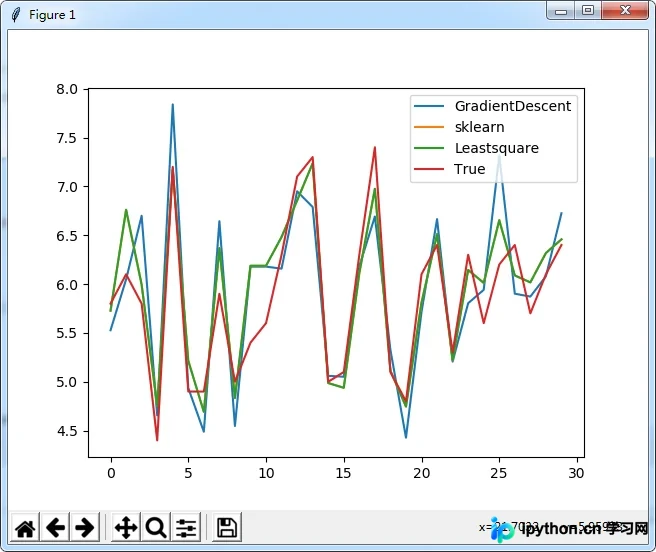
本文通过Python代码实例演示线性回归的三种实现方式:最小二乘法、梯度下降法以及sklearn库。文章详细展示了基于iris.csv数据的模型训练过程,对比了各算法在系数估计上的差异,并提供了完整的代码逻辑与可视化结果,帮助读者深入理解线性回归原理及不同优化策略的效果。
本文介绍在Python3中如何利用urllib库携带Cookie信息访问受保护网页。通过构建包含Cookie字段的headers字典,并创建Request对象,可实现模拟登录后的数据抓取。文章提供了完整的代码示例,展示如何设置请求头、发起HTTP请求并将响应内容保存至本地文件,适用于需要身份验证的爬虫场景。