

Python读取TXT文档中的图片URL并执行数据增强
本文详细说明如何通过Python脚本读取包含图片URL的TXT文本,并提供三种实现路径:轻量级URL扩展、基于Pillow的基础几何与像素变换,以及调用imgaug的高级批量增强流程。内含完整可运行代码、依赖配置步骤、输出目录校验方法及版权合规提示,适用于计算机视觉模型训练前的样本扩充任务。
2026-10-11
27

本文详细说明如何通过Python脚本读取包含图片URL的TXT文本,并提供三种实现路径:轻量级URL扩展、基于Pillow的基础几何与像素变换,以及调用imgaug的高级批量增强流程。内含完整可运行代码、依赖配置步骤、输出目录校验方法及版权合规提示,适用于计算机视觉模型训练前的样本扩充任务。
本文详解如何利用 Python 第三方库 python-docx 实现 Microsoft Word 文档的自动化读写、样式修改、页面排版、批量合并拆分及表格图像处理。提供完整可运行的代码示例与防错指南,助力开发者快速搭建办公提效脚本。
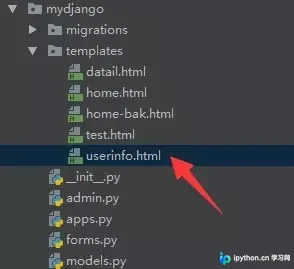
本文详细解析Django中ForeignKey外键关联的实现方法。通过定义Usergroup与Userinfo模型,演示如何使用makemigrations和migrate命令同步数据库结构。结合views.py与模板文件,展示如何在前端表单提交数据时自动关联外键,并将内容持久化至数据库。
Python 中的 re 模块提供了完整的正则表达式工具链,涵盖模式匹配、文本提取、条件替换及多行处理等核心场景。本文梳理从基础导入到高级断言、分组及编译优化的完整工作流,配合可运行的代码示例,帮助开发者高效解决复杂的字符串解析与数据清洗任务,提升代码健壮性与执行效率。
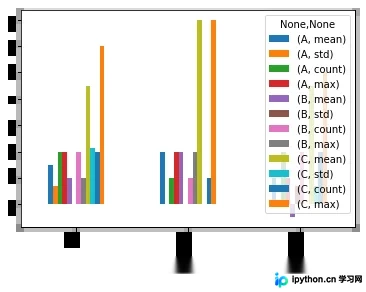
本文详解 Pandas 中 groupby() 函数的核心用法,涵盖按字典或列分组、apply 与 agg 的区别、多函数聚合及可视化。重点解析多级索引(MultiIndex)的透视表形式、使用 xs() 选取特定索引以及通过 reset_index() 恢复常规 DataFrame 结构的完整操作流程。
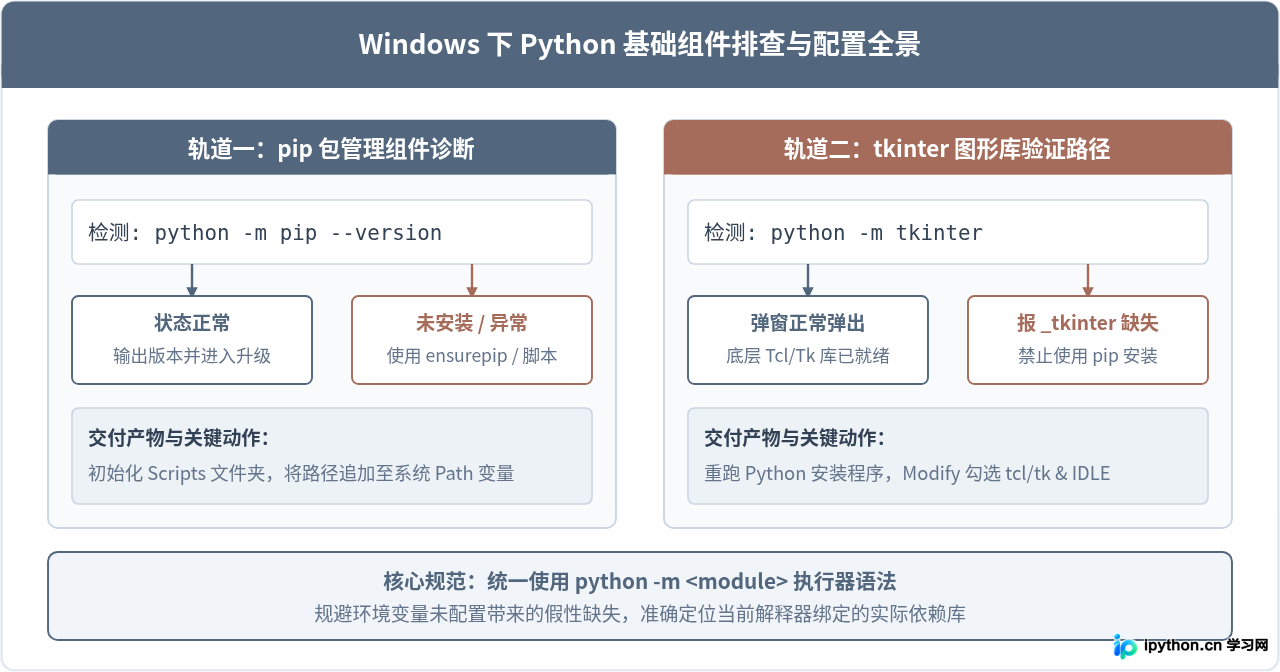
详细介绍在Windows操作系统下安装与修复Python包管理器pip、排查环境变量Path,以及正确验证与补全图形库tkinter可用性的具体操作步骤与排错方法。
本文总结了在 Python 中使用 pexpect 模块进行交互自动化时的三种日志记录方式。通过设置 child.logfile 属性、重定向 sys.stdout 对象以及直接打印输出到文件,可以实现对子进程交互过程的完整记录。文章提供了具体的代码示例,详细解析了文件打开模式(二进制与文本)的选择依据及注意事项,帮助开发者根据实际需求选择最合适的日志记录方案。
本文详解 NumPy 中用于数组合并的 np.vstack() 与 np.hstack() 方法。两者分别实现竖直堆叠与水平拼接,核心差异在于目标轴与维度匹配规则。文章提供完整代码示例,梳理常见报错原因与参数传递技巧,帮助开发者准确重组数据矩阵。
本文详细记录了在Linux环境下安装Django框架及配置MySQLdb接口的完整流程。涵盖Django版本指定安装、环境验证,以及解决MySQL-python编译时遇到的mysql_config缺失问题。通过具体命令演示如何获取依赖、构建并测试数据库连接,为Python Web开发提供基础环境配置参考。
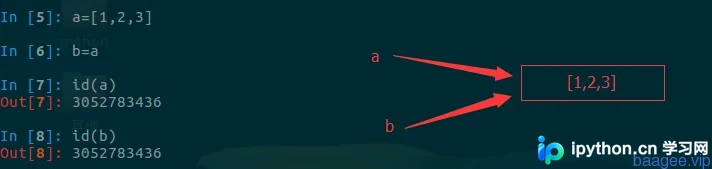
本文深入解析 Python 中深浅拷贝的底层机制。通过对比可变与不可变类型在 copy 和 deepcopy 下的表现,阐明内存地址(id)的分配逻辑。文章结合具体代码示例,展示列表与元组在拷贝过程中的行为差异,帮助开发者避免引用共享导致的意外数据修改。
本文介绍在Python中统计代码运行时长的两种方法。首先演示使用datetime模块计算时间差并格式化为HH:MM:SS字符串的基础实现;随后通过封装TimeDuration类,提供start()和stop()方法,简化重复调用的过程,提升代码复用性。
本文详解如何使用Python实现24点游戏。通过itertools模块进行数字全排列与运算符组合,利用zip_longest和chain拼接表达式,并结合eval与math.isclose处理浮点精度。文章涵盖基础排列、运算符组合及括号优先级处理,提供完整代码逻辑与测试案例。