

Python实现CSDN自动登录及文章列表抓取实战
本文详解使用Python登录CSDN并抓取博客文章列表的完整流程。通过Fiddler分析登录接口,解决参数错误、JS跳转及正则匹配等常见问题,提供可直接运行的代码实例,帮助开发者掌握Web自动登录与数据抓取技巧。
2026-10-13
21

本文详解使用Python登录CSDN并抓取博客文章列表的完整流程。通过Fiddler分析登录接口,解决参数错误、JS跳转及正则匹配等常见问题,提供可直接运行的代码实例,帮助开发者掌握Web自动登录与数据抓取技巧。
本文详细解析Python解决N阶台阶走法问题的两种核心思路。针对兔子每次可跳1、2或3阶的场景,文章指出该问题属于排列而非组合,并分别提供了递归与非递归(递推)的代码实现。通过对比两种方法的逻辑与执行效率,帮助开发者深入理解基础算法在Python中的应用。
本文深入解析Python中多种优化算法的应用,涵盖随机搜索、爬山法、模拟退火及遗传算法。通过航班调度、宿舍分配及关系图绘制三个实际案例,演示如何将问题转化为数字序列并定义成本函数。文章提供完整代码实现,帮助开发者掌握寻找最优解的核心技巧。
本文深入解析Python中K最近邻(KNN)算法的实现。从基础分类原理出发,详细讲解欧几里得距离计算、K值选择及加权平均策略(反函数、减法、高斯函数)。通过白酒价格预测案例,演示数据预处理、交叉验证评估、属性缩放优化及概率分布分析,帮助开发者掌握KNN在实际项目中的应用与调优技巧。
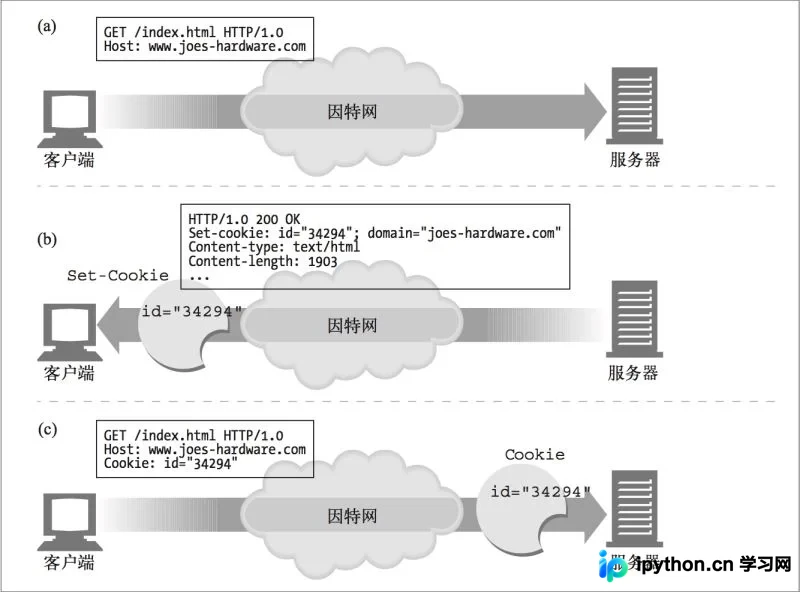
本文详解Python爬虫中如何利用Urllib库保存和复用Cookie实现网站自动登录。通过解析urlopen参数、构造Request对象及设置Headers,结合POST/GET请求示例,展示从抓包分析到代码实现的完整流程,帮助开发者突破登录限制。
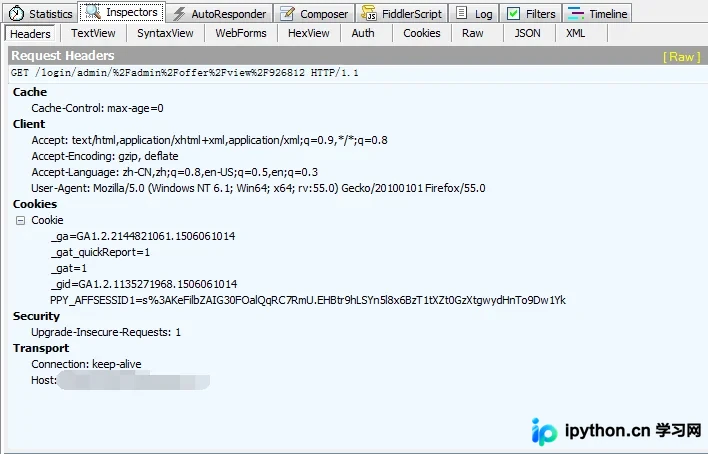
本文深入解析Python爬虫中Cookie与Session的核心机制。详细阐述Cookie作为客户端存储的身份标识,涵盖Version0与Version1的属性差异及过期策略;解析Session如何通过唯一ID减少数据传输并保障服务器性能。对比两者在安全性、存储位置及适用场景上的区别,帮助开发者优化爬虫策略与Web交互逻辑。
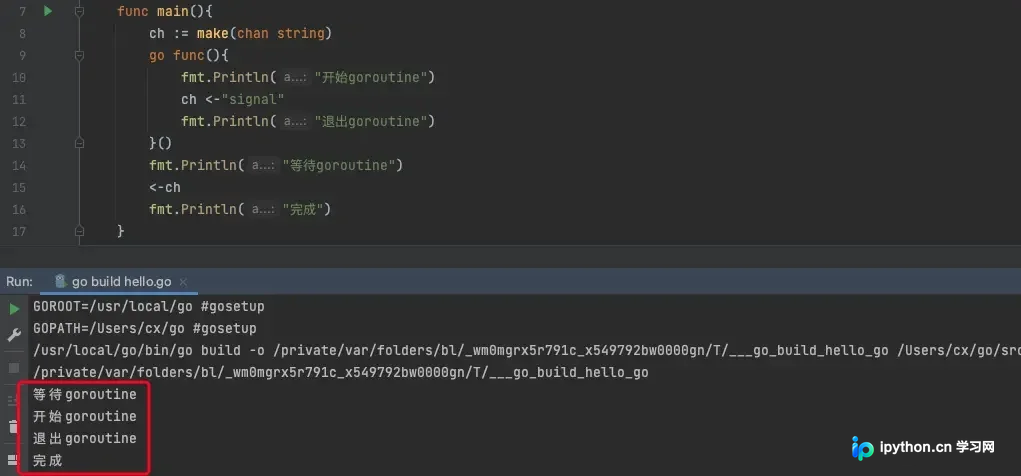
本文详细解析Go语言中通道(Channel)接收数据的四种方式:阻塞接收、非阻塞接收、丢弃数据实现同步以及循环遍历。通过具体代码示例与原理说明,帮助开发者掌握在不同并发场景下正确使用通道接收数据的方法,避免死锁并提高代码效率。
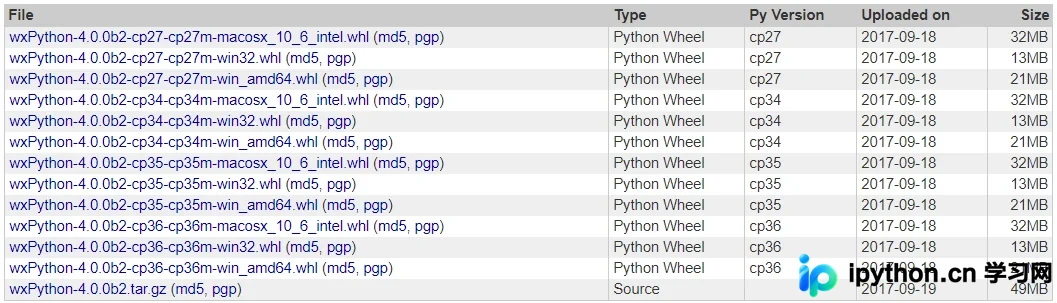
本文详细介绍在Windows环境下安装wxPython的步骤。从官方下载对应Python版本和系统架构的.whl文件,到将其放入Scripts目录并通过pip命令完成安装,最后提供一段简单的GUI测试代码以验证安装是否成功。适用于Python 3.6及以上版本的Windows用户。
本文介绍使用Python计算数组元素平均值的方法。通过定义列表、获取长度并遍历求和,最后除以长度得到均值。附带相关在线计算工具链接,适合Python初学者参考学习。
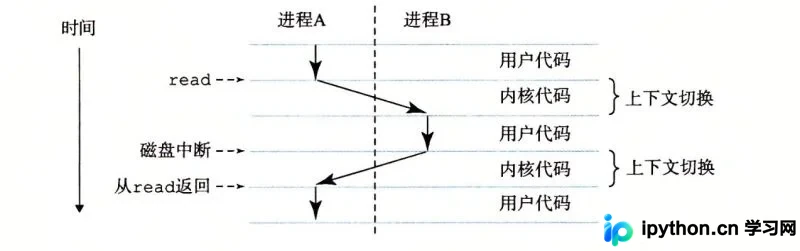
本文深入解析Python中的Gevent库,阐述协程与进程、线程的区别,详解Greenlet的工作机制及Gevent的猴子补丁特性。通过对比代码示例,揭示Gevent队列在IO调度中的潜在问题,并探讨其局限性及asyncio的替代优势,帮助开发者掌握高效异步I/O编程技巧。
本文介绍如何利用Python轻量级Bottle框架快速构建Web服务,适用于RESTful API性能测试场景。内容涵盖框架安装、服务启动配置、动态路由实现及客户端调用示例,帮助开发者快速掌握使用Bottle提供简单Web接口的核心步骤。
本文介绍 Go 语言中实用的内存优化技巧,包括预先分配切片的容量以规避底层数组重分配开销,利用 struct alignment 减少字段内存间隙,以及使用 map[string]struct{} 替代 bool 类型节省存储空间。这些方法能有效降低资源占用与基础设施成本。