

在Scrapy中集成PhantomJS实现异步AJAX爬取
本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。
2026-10-13
27

本文介绍如何在Scrapy中集成PhantomJS以实现异步AJ数据爬取。通过重写Downloader并引入Semaphore控制并发,解决传统同步集成的性能瓶颈。代码展示了如何配置PhantomJSDownloadHandler,利用线程池和队列管理浏览器实例,从而在保持Scrapy高效并发能力的同时,处理需要JavaScript渲染的网页内容。
在PHP中处理GB级日志或数据文件时,直接全量读取会导致内存溢出。利用fseek函数从文件末尾向前移动指针是高效解决方案。本文对比了逐行扫描与批量块读取两种实现方式,通过控制参数调整读写步长,大幅降低I/O开销并提升执行效率,适用于需要快速获取文件最后N行数据的场景。
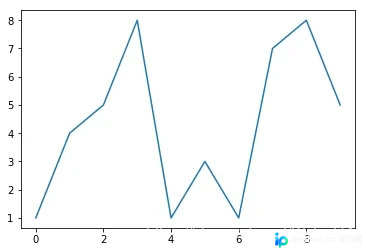
本文介绍利用Python的scipy库通过插值法绘制平滑曲线的方法。通过示例展示如何对原始数据进行平滑处理,并指出该方法的效果取决于数据本身的规律性。对于杂乱无章的数据,平滑后结果可能与原图差异较大,因此建议谨慎使用,并非适用于所有场景。
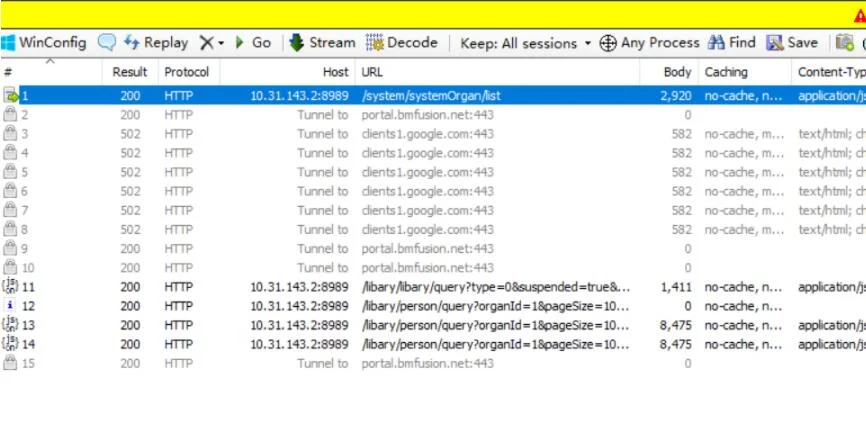
本文详细介绍如何使用Python的requests库编写POST接口测试脚本。通过Fiddler工具获取目标URL及参数,利用requests.post方法发送包含访问令牌和分页信息的JSON负载,并获取接口返回的状态码。该示例涵盖了从抓包到代码实现的完整流程,适用于基础的接口功能验证。
本文介绍了一种在Python中直接获取API返回参数的简化方法。通过移除不必要的传参步骤,仅保留核心的HTTP连接与请求代码,即可高效获取接口数据。该方法经过多次测试,被验证为最简单且有效的实现方式,适合初学者参考。
本文介绍了在Python中如何通过requests库实现接口间的数据传递与调用。以登录接口获取的taxid参数为例,演示了如何将前一个接口的响应数据作为参数传递给后续接口,并通过unittest框架进行自动化测试。
本文详解Python unittest框架中跳过用例的三种装饰器用法,结合sys.argv实现命令行参数传递。通过自动化测试实例,展示如何配置一套代码支持多环境运行,并根据传入的环境URL动态跳过特定用例,提升测试脚本的复用性与灵活性。
本文介绍如何使用Python标准库urllib2模块发起URL请求并获取返回信息。通过urllib.urlencode处理参数,利用Request构建请求对象,最后调用urlopen读取响应内容。示例展示了如何向指定URL发送POST数据并打印返回结果,适用于基础的网络交互场景。
本文深入解析C语言核心概念。从静态与动态数据的区别入手,阐述比特与字节的存储换算标准。详细列出整型、浮点等基本数据类型及占位符(如%d、%f)。对比常量分类与变量定义的规范,并通过完整代码示例演示变量初始化、内存管理及两种交换算法的实际应用。
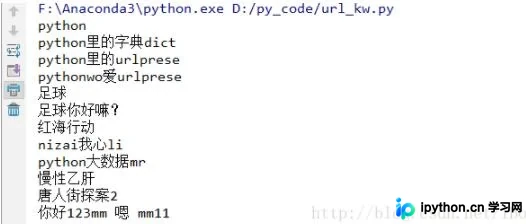
本文详细介绍如何利用Python解析URL并提取关键字。通过对比Python2与Python3的urlparse模块差异,结合正则表达式匹配query和path中的关键参数。文章提供了针对百度、搜狗等主流网站及特殊域名如weibo.com的字典映射规则,并附带完整代码与测试案例,帮助开发者高效处理各类URL解析需求。
本文介绍如何在Python自制Web框架中实现类似Django的Request对象,用于接收前端表单及URL传递的数据。通过定义Request类并初始化属性,结合全局变量刷新机制,解析HTTP请求报文以提取请求方法、路径及参数,为轻量级Web开发提供基础支持。
本文介绍如何使用Python的numpy、scipy和matplotlib库绘制平滑曲线。重点讲解interp1d函数的nearest、zero、slinear、quadratic及cubic等插值方法,并区分插值与拟合的概念。通过完整代码示例,展示如何生成xnew数组并计算ynew,同时强调xnew范围需覆盖原数据且间距要小于原数据精度,以确保曲线平滑。