

Python实现基于最大概率法的汉语分词算法
本文介绍使用Python实现基于最大概率法的汉语分词方法。核心思路包括预处理语料库、按标点分割长句、生成候选词集,并利用2-gram语言模型结合加一平滑计算切分概率。通过取对数将乘法转为加法,并优化词数阈值以提高效率,最终输出概率最大的分词结果。
2026-10-13
23

本文介绍使用Python实现基于最大概率法的汉语分词方法。核心思路包括预处理语料库、按标点分割长句、生成候选词集,并利用2-gram语言模型结合加一平滑计算切分概率。通过取对数将乘法转为加法,并优化词数阈值以提高效率,最终输出概率最大的分词结果。
本文详细介绍 Django ORM 中通过 related_name 属性进行反向查询的方法。以用户与等级模型为例,对比正向查询与反向查询的代码实现,展示如何从关联模型获取主模型数据,帮助开发者高效处理数据库关系。
整理 JavaScript 开发中常用的字符串验证功能,涵盖 IP 地址、手机号、邮箱、日期、金额及证券代码等场景。通过封装标准正则表达式与自定义逻辑函数,提供可直接复用的校验工具,解决前端表单输入合法性检查需求,提升数据准确性与用户体验。
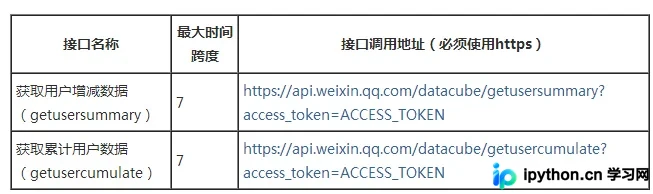
本文详解如何在 PHP 中调用微信公众平台新增的数据统计接口。内容涵盖接口调用前提、参数结构,以及如何修改现有微信高级接口类以支持 datacube 数据模块,并提供 POST 请求示例及关键代码片段,帮助开发者获取并存储用户分析数据。
本文通过实际测试对比Django中ForeignKey反向查询的两种常用方式:使用_set.all()与objects.filter()。实验结果显示,在10000次查询下,filter方法耗时略少,效率更高。文章提供了完整的模型定义、数据构造及timeit测试代码,帮助开发者在SEO和性能敏感场景下做出更优选择。
本文介绍了Django中通过外键实现Model间数据互相读取的方法。以Entry、Blog和Author为例,展示了如何在Entry中获取关联的Blog和Author信息,以及如何在Blog和Author中反向查询关联的Entry集合,帮助开发者理解Django ORM的外键操作。
本文介绍如何使用Python在嵌入式开发中分割二进制文件。通过读取源文件并转换为字节数组,利用切片操作提取指定地址区间的数据(如0x0至0x4000等),并将结果写入指定目录。代码包含目录创建、文件读写及数组转换逻辑,适用于需要将Binary文件按区域拆分的场景。
本文详解Django中Model外键的两种特殊用法:自关联与引用未定义Model。针对部门上下级关系,通过设置ForeignKey参数为'self'实现自引用;针对用户与部门的相互引用,通过将目标Model名改为字符串形式解决定义顺序依赖问题。
本文详解Python中同一文件夹下不同.py文件交叉引用时出现的AttributeError错误。通过分析执行流程与sys.modules机制,指出直接import导致的问题,并提供通过__name__判断解决循环导入的有效方案。
本文介绍如何在 MySQL 数据库中通过单条 SQL 语句一次性向表中插入多条记录。主要讲解 INSERT INTO 语句的多值语法,对比单行插入的区别,并提供创建表结构与执行批量插入的完整代码示例及结果验证。
本文介绍如何在Python中利用JPype库调用Java编写的JAR包。通过获取默认JVM路径并配置类路径,启动JVM后实例化Java类并调用其方法。示例展示了从环境配置到执行Java方法的全过程,适用于需要Python与Java交互的场景。
本文详解 Python 模块导入机制,指出模块需置于 sys.path 指定目录方可被识别。针对运行脚本时常见的文件句柄找不到问题,提供了两种解决方案:使用绝对路径或调整执行目录。建议采用绝对路径以确保路径引用的稳定性,避免环境变动导致的引用失效。