MySQL MyISAM存储引擎的非聚簇索引详解
解析MySQL中MyISAM存储引擎的非聚簇索引机制,对比InnoDB聚簇索引差异,说明数据与索引分离、回表过程及地址偏移量的优势。
2026-10-16
7

解析MySQL中MyISAM存储引擎的非聚簇索引机制,对比InnoDB聚簇索引差异,说明数据与索引分离、回表过程及地址偏移量的优势。
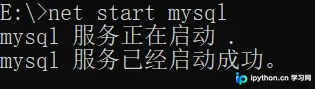
本文详细记录 MySQL 常用基础命令,涵盖以管理员身份启动服务、使用命令行连接数据库,以及查看、创建和切换数据库的操作。同时整理了表的创建、结构查看及定义查询等高频 SQL 指令,适合初学者快速掌握数据库核心管理技能。
在C++中,直接传递一级指针无法修改实参本身的地址。本文详细解析了如何利用二级指针(double pointer)和指针引用(reference to pointer)作为函数形参,实现对外部实参指针指向对象的修改。包含具体代码示例、内存原理分析及两种方式的对比总结,帮助开发者深入理解C++参数传递机制。
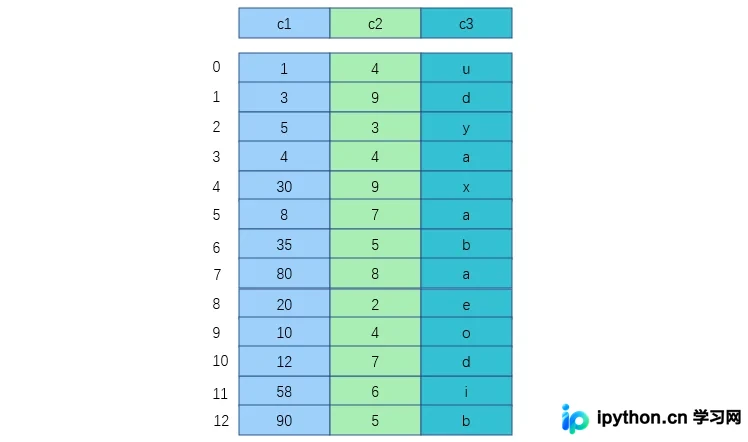
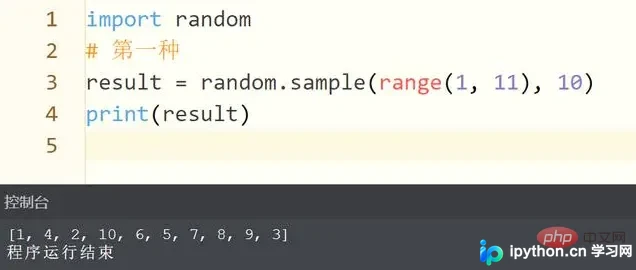
本文介绍在Python中生成10个不同随机数的三种常用方法:利用random.sample从序列抽取、通过循环与列表判断去重、以及使用shuffle打乱序列后截取。此外,文章还提供了生成指定范围随机数并计算总和的完整代码示例与优化方案,帮助开发者快速掌握相关编程技巧。
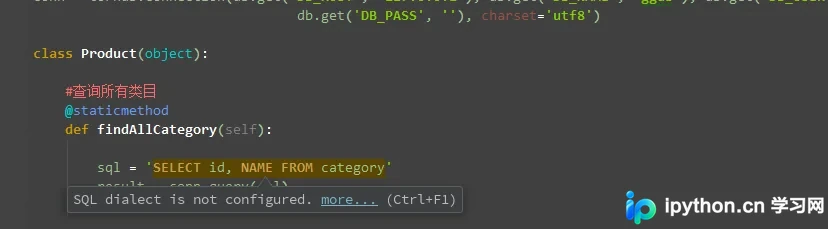
本文介绍如何在PyCharm中解决SQL语句提示“SQL Dialect is Not Configured”的问题。通过进入File > Settings > Languages & Frameworks > SQL Dialects配置对应数据库类型,或添加具体数据源连接,即可消除该提示并启用SQL语法高亮与智能提示功能。
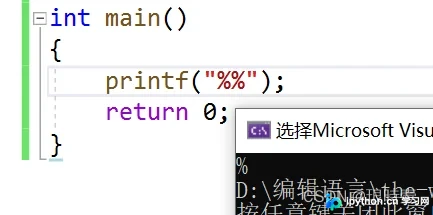
总结C语言中容易忽略的基础知识点。整数相除自动舍弃小数,使用%获取余数;负数除法结果依赖编译器实现;double类型必须使用%lf读取且不支持%运算;不同数据类型混合运算时会发生自动类型提升。掌握这些细节可避免常见的逻辑与输出错误。
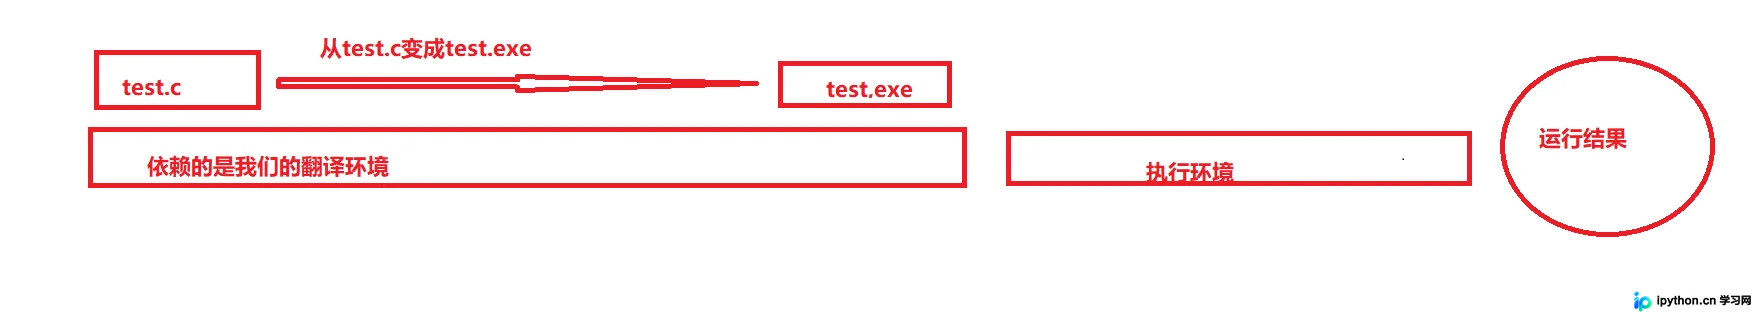
本文详细解析C语言的翻译环境与运行环境,阐述源代码到可执行文件的编译、链接步骤。重点讲解预处理阶段的特性,包括预定义符号、宏定义及其副作用风险、#与##运算符的使用、命令行定义、条件编译逻辑及头文件的嵌套保护机制。
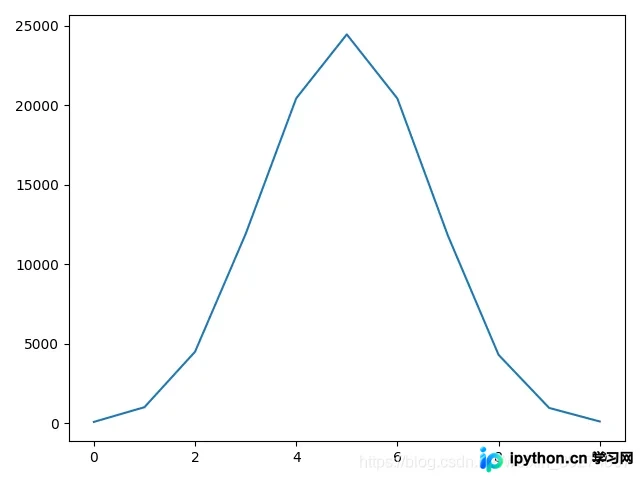
本文介绍Python中利用random模块的random()函数生成[0,1)区间随机数的方法,并通过模拟抛硬币实验展示其实际应用。代码包含统计正反面次数及绘制概率分布图,帮助理解随机数在概率模拟中的使用。
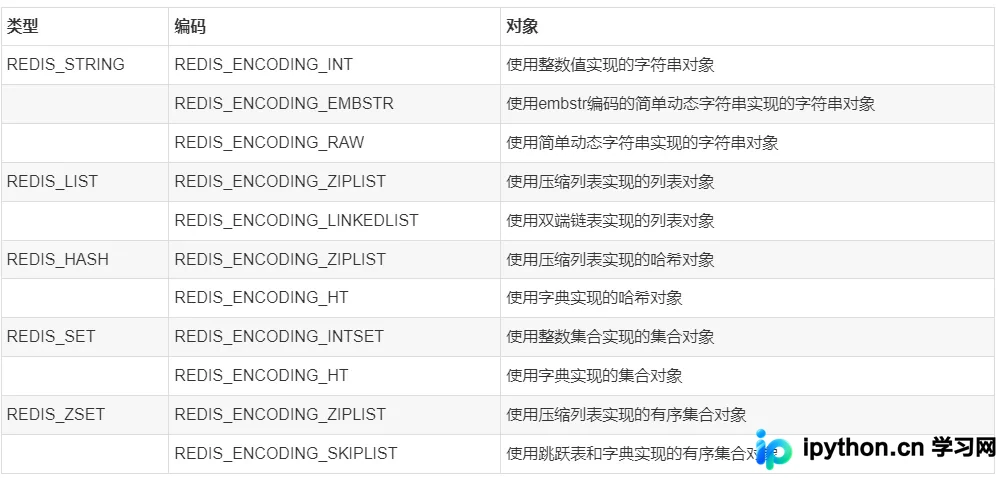
本文详细解析Redis底层存储机制,重点介绍redisObject的结构组成(type、encoding、ptr)。阐述字符串、哈希、列表、集合、有序集合五种基本类型及其对应的多种内部编码方式(如SDS、压缩列表、跳跃表等),帮助理解Redis如何通过灵活编码提升数据处理的效率与内存利用率。
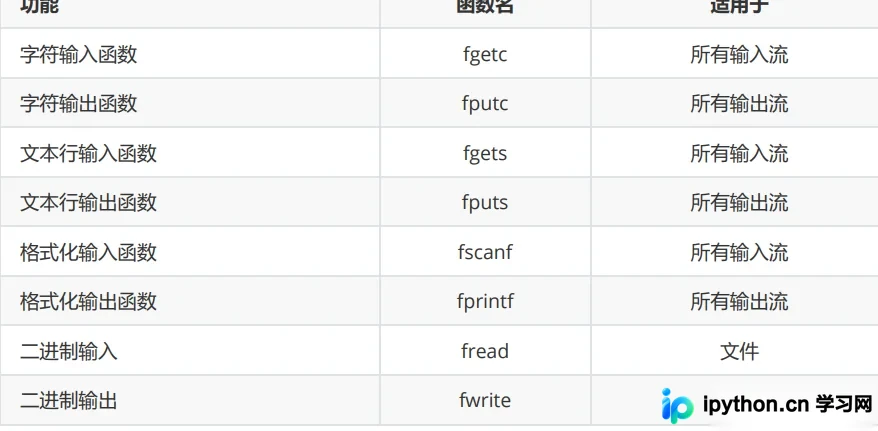
本文系统讲解C语言文件的顺序读写与随机定位技术。涵盖使用fprintf/fscanf进行结构化数据格式化存储,利用fwrite/fread实现二进制高效读写;详解fseek/ftell/rewind函数的偏移计算与应用场景;并纠正feof在判断文件结束时的误用陷阱,提供完整的代码示例与避坑指南。
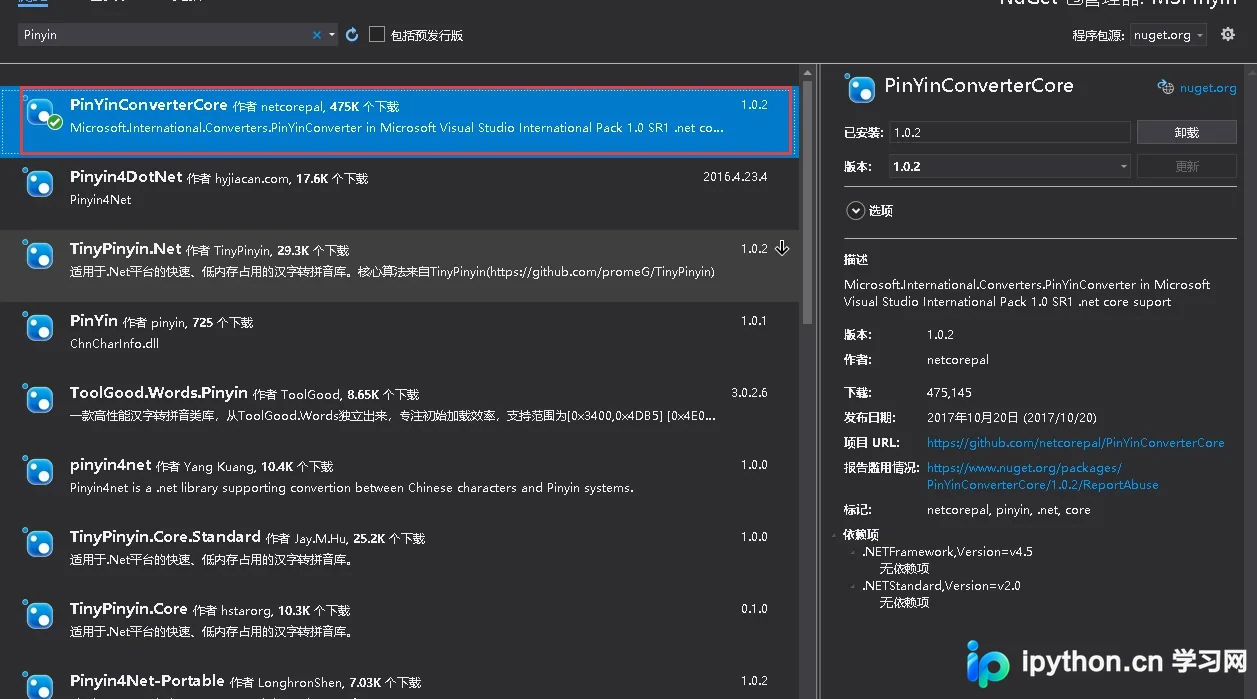
在C#开发中,通过Nuget安装PinYinConverterCore库可解决.NET Framework与.NET Core的兼容性差异。本文提供一个包含全拼和首字母转换的工具扩展类,有效处理多音字问题,并结合LINQ实现基于拼音缩写的模糊筛选功能,适用于搜索组件等场景。
本文详解在pandas中将整数类型的时间戳转换为datetime格式的正确步骤。指出直接转换导致的1970年错误,并演示先转为字符串再使用to_datetime()的修正方案。同时介绍DatetimeIndex、date_range生成时间序列,以及利用dt属性提取时间分量和Timedelta计算时间差的高级用法。