

C语言程序环境与预处理详解:从翻译执行到宏与条件编译

任何C语言程序的构建都经历翻译和运行两个截然不同的环境。本文将从这两个环境切入,深入剖析代码如何转化为机器指令,并系统讲解预处理阶段的核心机制,涵盖宏定义的陷阱处理、字符串化与连接操作、条件编译控制以及防重复包含的头文件标准写法。
一、程序的翻译环境和运行环境
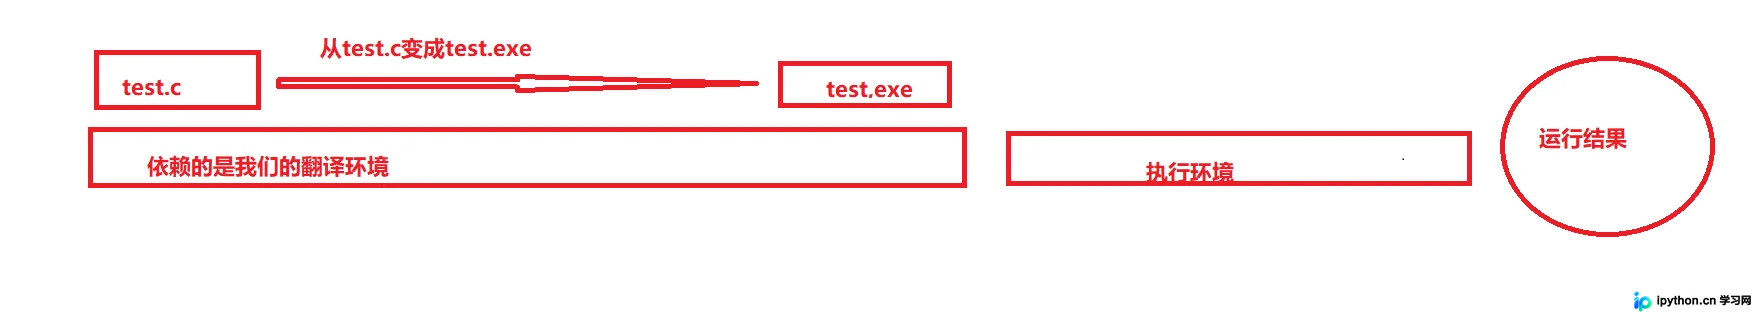
根据ANSI C标准,一个C程序的实现过程存在两种不同的环境:
- 翻译环境(Translation Environment):在此环境中,源代码被转换为可执行的机器指令。
- 执行环境(Execution Environment):用于实际执行编译生成的程序代码。
1. 程序的翻译环境
翻译环境主要包含编译和链接两个核心动作。一个.c源文件需要经过以下处理流程才能成为最终的可执行文件:
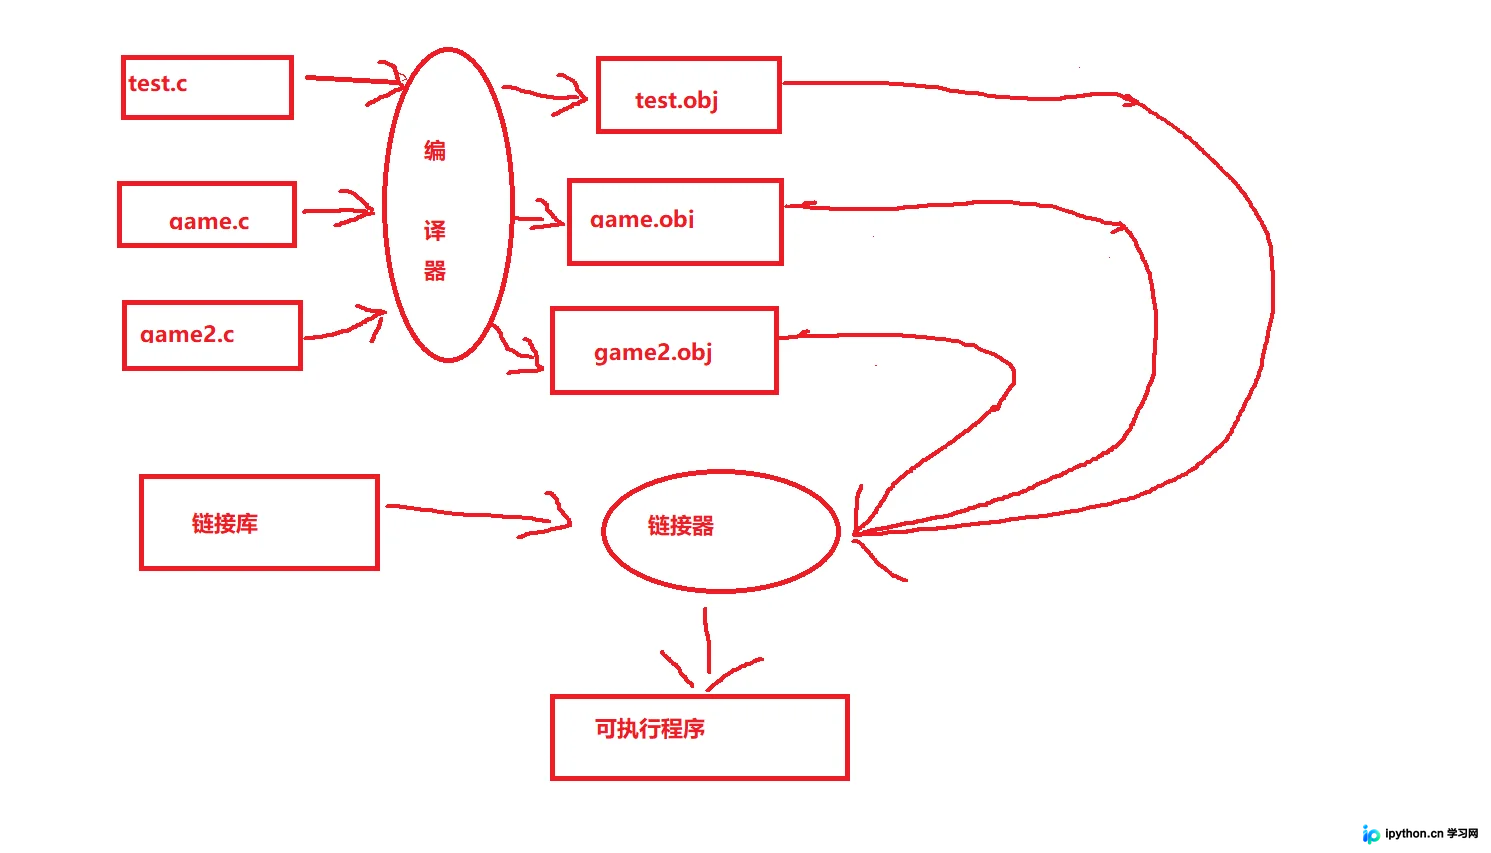
- 编译(Compilation):每个.c文件独立经过编译器处理,生成目标文件(Windows下为.obj,Linux下为.o)。
- 链接(Linking):由链接器(linker)将各个目标文件捆绑在一起,形成一个单一完整的可执行程序,同时引入标准C函数库中所需的函数以及程序员个人程序库中的函数。
其中,编译过程又可细分为三个阶段:
- 预编译(预处理):如
gcc test.c -E > test.i。主要进行文本操作,包括展开头文件(#include)、替换#define符号和宏、删除注释等。 - 编译:如
gcc test.i -S。将C语言代码转换为汇编代码(.s文件)。此阶段涉及词法分析、语法分析、语义分析及符号汇总。 - 汇编:如
gcc test.s -c。将汇编代码转换为机器指令(二进制),生成目标文件(test.o),并建立符号表。
2. 链接阶段细节
在链接阶段,主要完成以下工作:
- 合并段表。
- 符号表的合并和重定位,解决不同文件中同名变量或函数的冲突及地址指向问题。
3. 执行环境(运行环境)
程序进入执行环境后的基本过程如下:
- 载入内存:在有操作系统的环境中,由操作系统负责加载;在独立环境中可能需手工安排或通过只读内存置入。
- 调用main函数:程序入口开始执行。
- 执行代码:使用运行时堆栈(stack)存储局部变量和返回地址,同时可能使用静态内存(static)保存全局变量和静态变量,这些值在程序全程保留。
- 终止程序:正常退出main函数或因意外导致终止。
二、预处理详解
预处理是编译前的最后一步,以文本方式处理源代码,不包含语法检查,因此极易出现隐蔽错误。
1. 预定义符号
C语言提供了一些内置的预定义符号,常用于调试和日志记录:
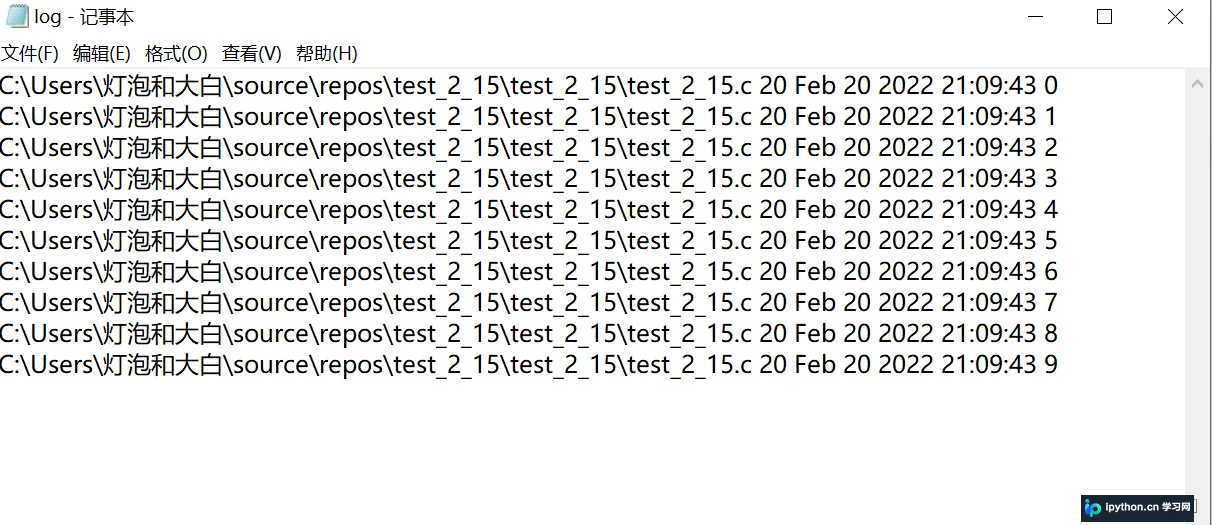
__FILE__:当前进行编译的源文件名。__LINE__:当前文件的行号。__DATE__:文件被编译的日期。__TIME__:文件被编译的时间。__STDC__:如果编译器遵循ANSI C标准,其值为1,否则未定义。
例如,利用这些符号编写一个简单的日志输出程序:
#define _CRT_SECURE_NO_WARNINGS 1
#include<stdio.h>

int main()
{
	int i = 0;
	FILE* pf = fopen("log.txt", "a+");
	if (NULL == pf)
	{
		perror("fopen\n");
		return 1;
	}
	for (i = 0; i < 10; i++)
	{
		fprintf(pf, "%s %d %s %s %d\n", __FILE__, __LINE__, __DATE__, __TIME__, i);
	}
	return 0;
}
2. #define定义标识符与宏
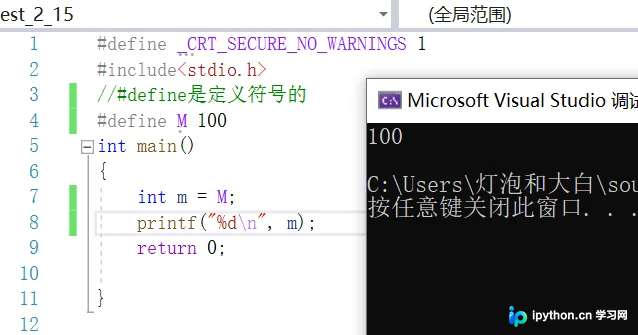
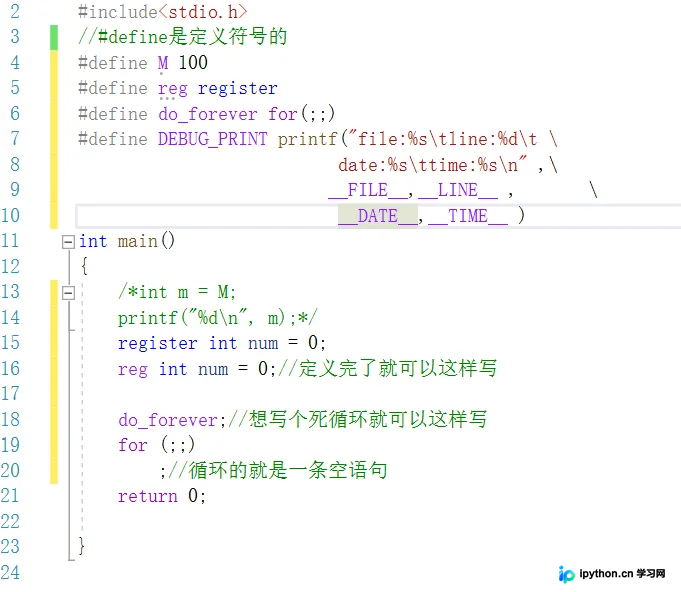
#define不仅可以定义常量标识符,还可以定义宏(Macro)。宏允许在文本中插入参数,实现类似函数的功能,但本质仍是文本替换。
3. 宏定义的替换规则
宏展开涉及以下步骤:
- 调用宏时,首先检查参数是否包含其他已定义的符号,若有则先替换。
- 将替换后的文本插入原位置。
- 对结果再次扫描,若还有宏定义,则重复上述过程。
注意:宏参数和定义中可以出现其他#define符号,但#define不能递归定义宏。且预处理器搜索#define时不搜索字符串常量内部的内容。
4. #和##预处理工具
这两个运算符在处理复杂宏时非常有用:
#(字符串化):将宏参数转换为字符串常量。
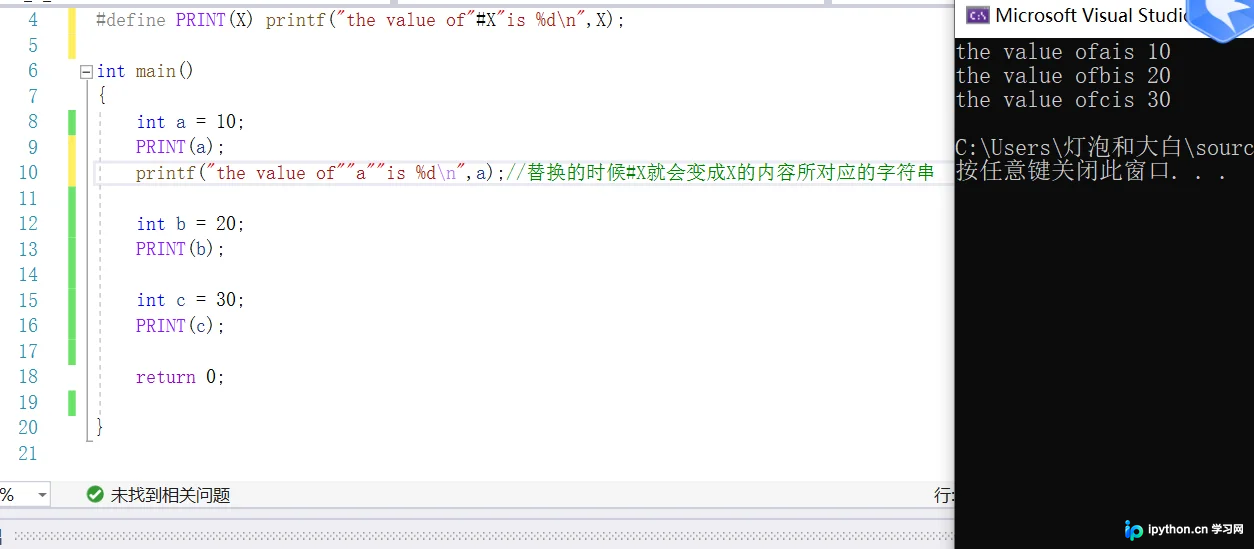
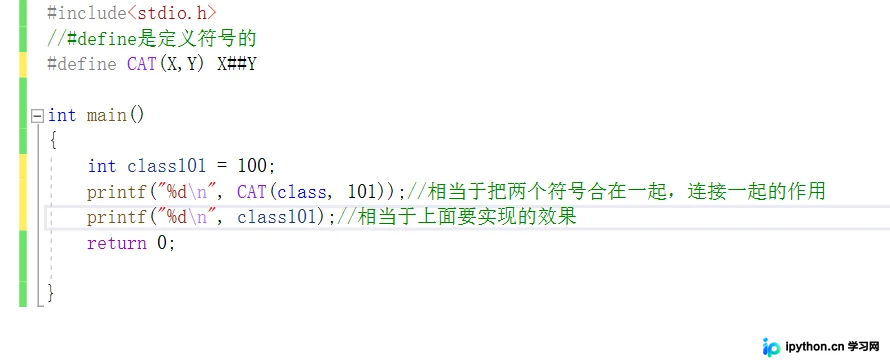
##(连接):将位于其两边的符号连接成一个独立的标识符。
5. 带副作用的宏参数
当宏参数在定义中出现多次且带有副作用(如自增x++)时,可能导致不可预测的结果。
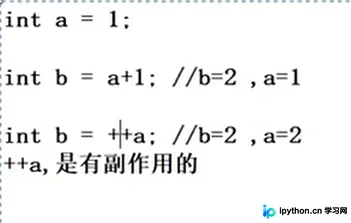
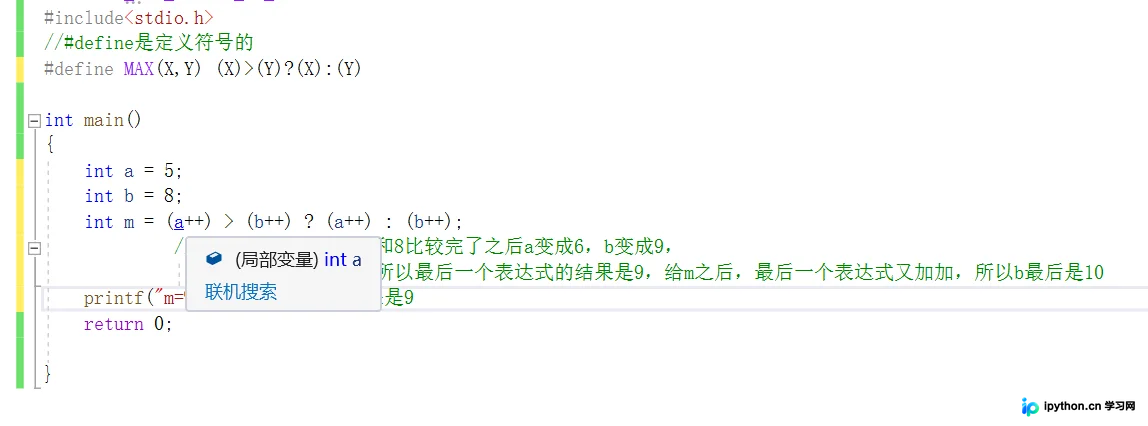
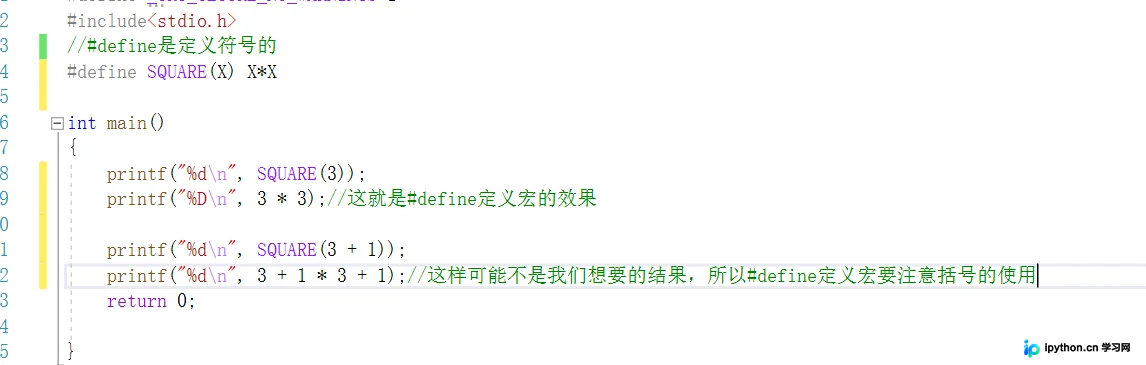
例如宏 #define DOUBLE(x) ((x)+(x)),若传入a++,则会被替换为(a++)+(a++),导致变量累加两次而非期望的一次加倍。因此,数值表达式求值的宏定义必须加括号,且尽量避免使用有副作用的参数。
6. 宏与函数的对比
虽然两者都能实现特定功能,但存在显著差异:
- 宏的优势:
① 无调用开销,速度和规模更优。
② 类型无关,适用于多种数据类型。 - 宏的劣势:
① 代码膨胀:每次使用都会插入代码,短小宏除外。
② 无法调试:预处理器直接替换,调试器难以介入。
③ 缺乏严谨性:类型检查不如函数严格。
④ 优先级问题:易因操作符优先级产生逻辑错误(故需多加括号)。
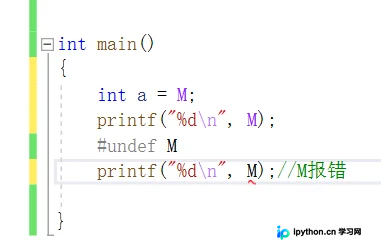
7. #undef移除宏
如果需要重新定义一个宏,应先使用#undef NAME移除旧定义,以避免混淆。
8. 命令行定义
许多编译器支持在命令行通过-D参数定义符号,便于针对同一源码编译不同版本(如不同内存限制下的数组大小):
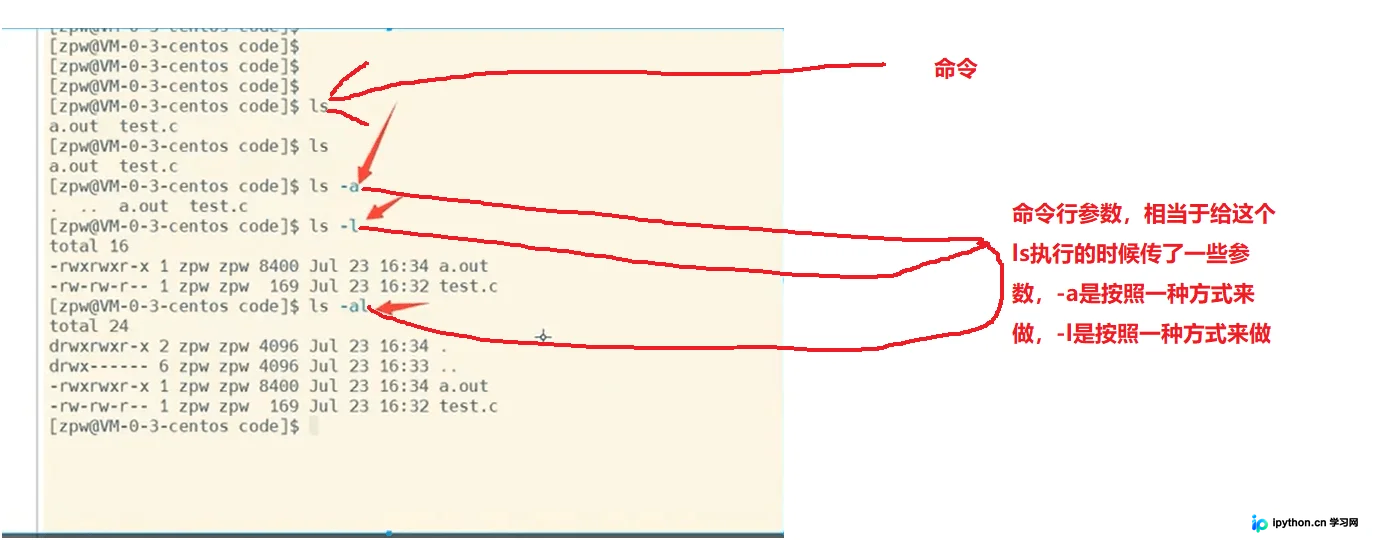
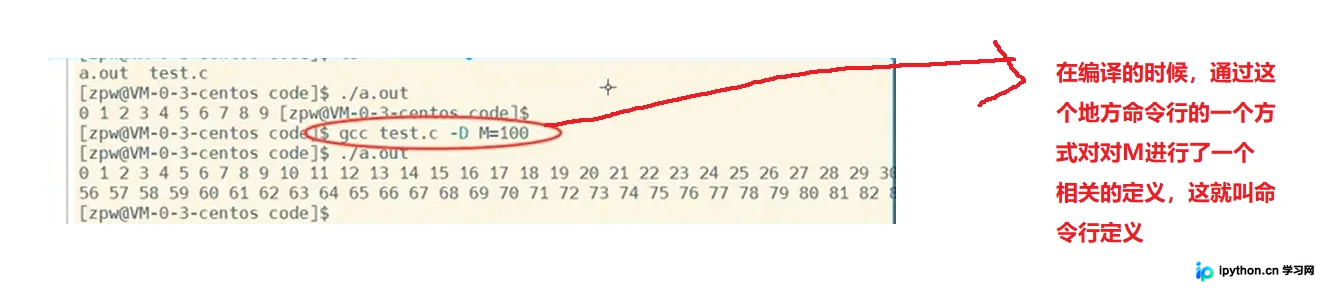
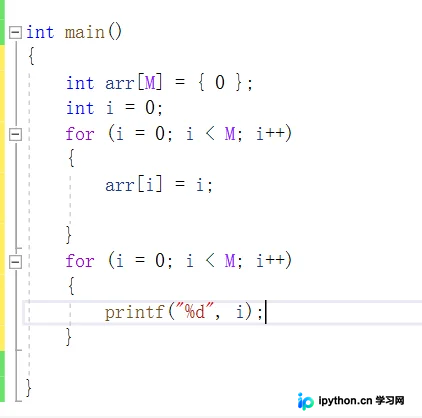
在Linux下使用命令 gcc test.c -D M=100,可在编译时直接定义常量M:
9. 条件编译
通过条件指令控制部分代码是否参与编译:
#ifdef / #ifndef / #endif:判断宏是否定义或未定义。#if / #elif / #else / #endif:判断常量表达式的值(0为假,非0为真)。
示例:
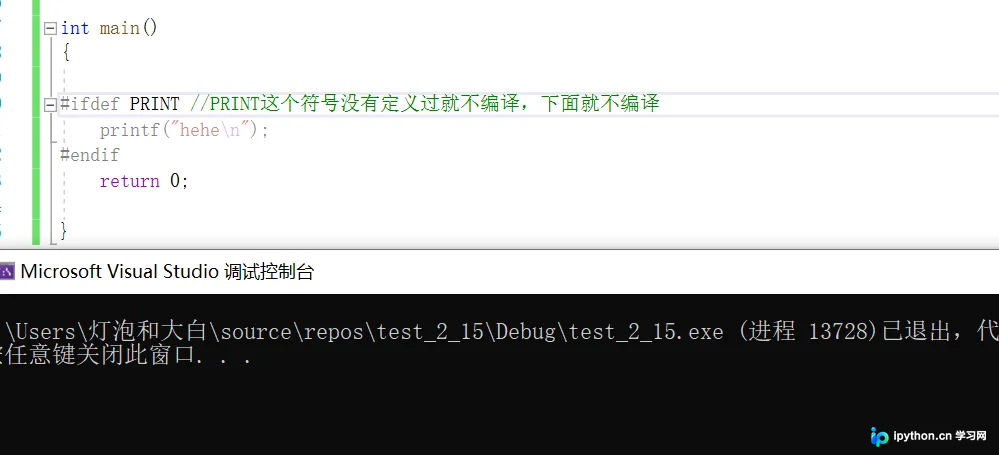
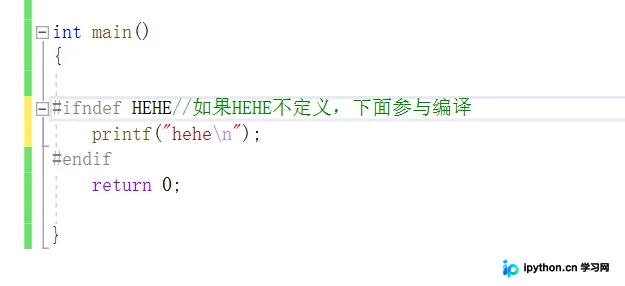
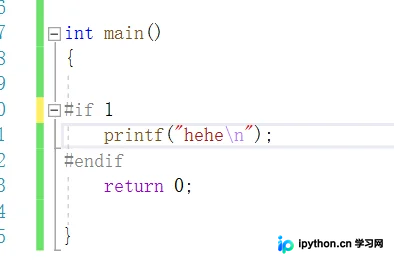
若使用#if 1,后续代码块参与编译;若为0则跳过。
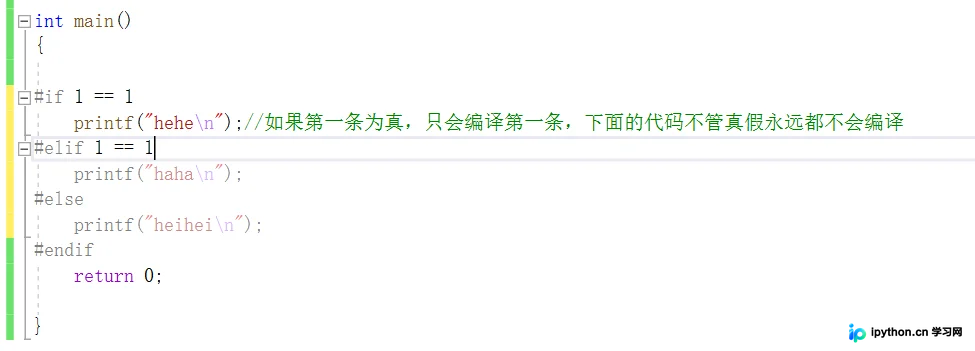
10. 头文件包含与嵌套保护
头文件包含有两种形式:
#include "file.h":先在源文件目录查找,再找标准库路径。#include <file.h>:直接在标准库路径查找。
为避免多次包含导致重复定义错误,必须使用“头文件卫士”(Header Guard):
方法一(传统):
#ifndef __TEST_H__
#define __TEST_H__
// 内容
#endif
方法二(现代编译器支持):
#pragma once
这两种方式均可有效防止头文件的重复引入。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









