

MySQL MyISAM存储引擎的非聚簇索引详解

MyISAM 是 MySQL 一种经典且高效的存储引擎,其核心特征在于采用非聚簇索引结构。与 InnoDB “索引即数据”不同,MyISAM 将数据文件与索引文件分离,通过主键或二级索引查找后需进行“回表”操作获取完整记录。这种基于行号(地址偏移量)的访问方式在特定场景下具有极高的读取速度。
MyISAM的数据与索引分离
在 MySQL 中,不同的存储引擎采用不同的索引组织方式。以 InnoDB 为例,其聚簇索引的 B+树叶子节点直接存储了完整的用户记录(Row)。而 MyISAM 则采用了完全不同的策略:它将表中的实际数据和索引信息分开存储在独立的文件中。
当我们使用 MyISAM 创建表时,系统会为每一条记录分配一个唯一的行号。这些记录按照插入顺序紧密地存储在一个数据文件中,该文件通常不被划分为传统意义上的数据页,而是以字节流的形式存在。通过行号,我们可以快速定位并访问到任意一条记录。
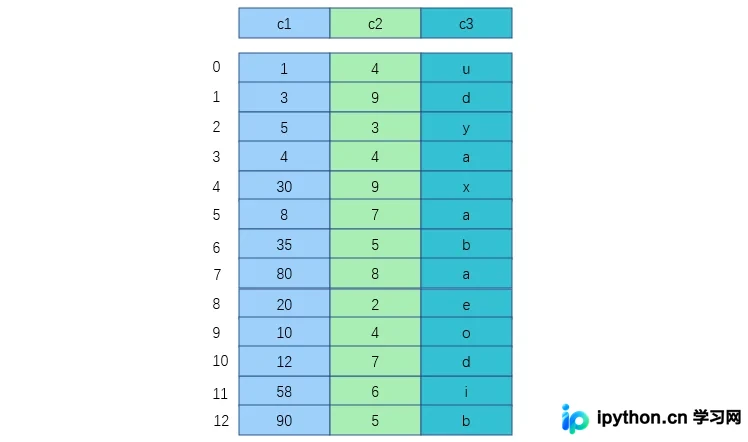
由于数据记录是按照插入顺序而非主键大小排序存放的,我们无法直接在数据文件中利用二分法高效查找。因此,MyISAM 会额外维护一个索引文件来解决这一问题。
非聚簇索引的工作原理
MyISAM 会为表的列建立索引(无论是主键还是普通索引),但其索引结构与 InnoDB 有本质区别。在 MyISAM 的索引文件中,B+树的叶子节点并不包含完整的数据行,而是存储着 “索引键值 + 行号(文件偏移量)” 的组合。
create table index_demo(
	c1 int,
	c2 int,
	c3 char(1),
	primary key(c1)
) ROW_FORMAT=COMPACT;
查询流程分为两个阶段:
- 查找索引:首先在索引文件中通过键值定位到对应的行号。
- 回表获取数据:利用获取到的行号(地址偏移量),直接去数据文件中读取完整的记录。
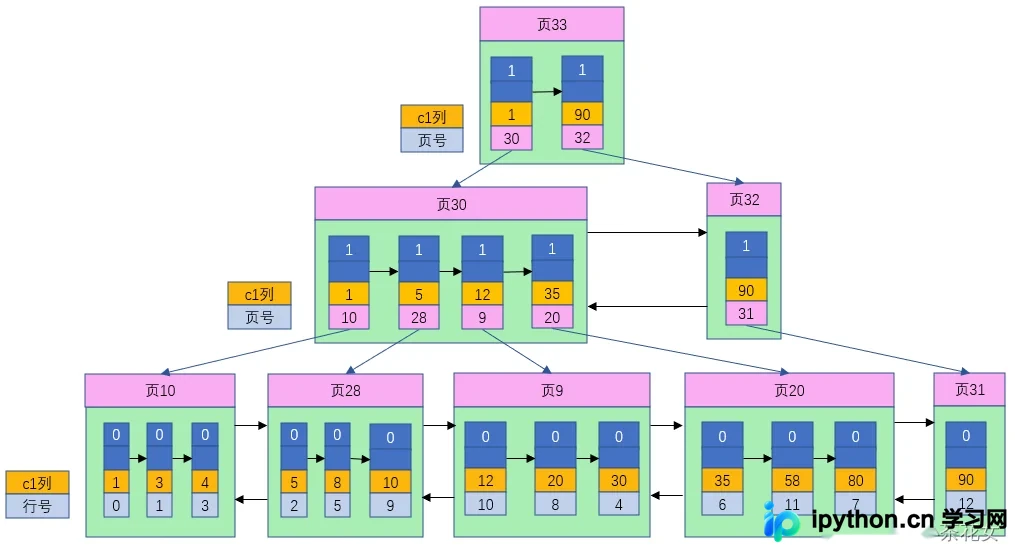
这意味着,在 MyISAM 存储引擎中,所有建立的索引在逻辑上都等同于 InnoDB 中的“二级索引”,都需要经历一次回表操作才能拿到最终数据。
回表的高效性
尽管需要两次寻址,但 MyISAM 的回表操作通常非常迅速。这是因为 MyISAM 的叶子节点直接存储的是该行在数据文件中的物理地址偏移量。
MyISAM 会直接在索引叶子节点处存储该条记录在数据文件中的地址偏移量。由此可以看出 MyISAM 的回表操作是十分快速的,因为它是拿着地址偏移量直接到文件中取数据;而 InnoDB 需要通过主键再次进入聚簇索引树去寻找记录,虽然也不慢,但在纯指针跳转的效率上略逊于直接使用地址访问。
多级索引与通用结构
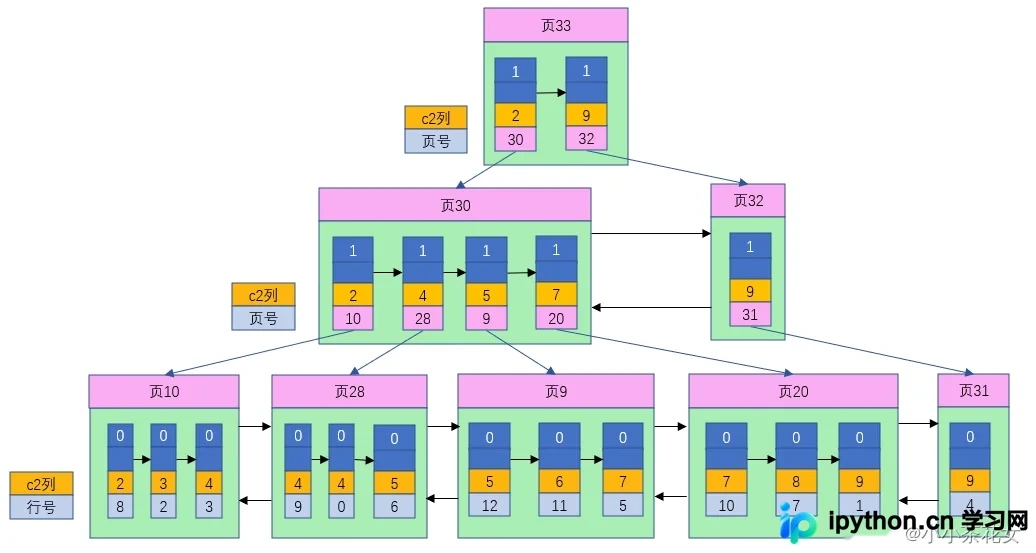
如果业务需要对非主键字段进行加速查询,可以为其他列单独建立索引或联合索引。其底层原理与上述主键索引一致,叶子节点同样存储“相应列的值 + 行号”。无论是以主键还是非主键为排序规则,MyISAM 的索引结构始终保持一致:即叶子节点存放的都是相应的列值加上行号。
总结
本文详细分析了 MySQL MyISAM 存储引擎的非聚簇索引机制。与 InnoDB 相比,MyISAM 通过分离数据与索引,利用行号进行快速回表,简化了索引存储结构,并在某些特定查询场景下提供了优越的性能表现。以上就是 MySQL 之 MyISAM 存储引擎的非聚簇索引详解的详细内容,更多关于 MySQL 存储引擎和索引优化的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









