使用PHP将360浏览器导出数据转换为HTML书签文件
本文提供一段PHP代码,用于处理360浏览器导出的书签数据(JSON格式),并将其转换为标准的NetSCAPE-Bookmark-file-1格式的HTML文件。代码通过解析JSON中的记录列表,提取URL、标题和时间戳等字段,拼接符合规范的HTML标签序列完成转换。该方法适用于需要将特定格式书签导入支持标准HTML书签文件的浏览器的场景。
2026-10-14
21

本文提供一段PHP代码,用于处理360浏览器导出的书签数据(JSON格式),并将其转换为标准的NetSCAPE-Bookmark-file-1格式的HTML文件。代码通过解析JSON中的记录列表,提取URL、标题和时间戳等字段,拼接符合规范的HTML标签序列完成转换。该方法适用于需要将特定格式书签导入支持标准HTML书签文件的浏览器的场景。
本文详细解析Python中经典类与新式类的区别,重点阐述多重继承下的深度优先与C3算法差异,以及实例类型判断的不同。指出Python 3中所有类均为新式类,统一了类与类型的关系,并提供了相关代码验证。
本文详解Python中小整数对象池(范围[-5, 256])的预创建机制,以及大整数在不同执行环境(如终端与PyCharm)下的复用规则。通过代码示例解析is运算符在整数比较中的表现,帮助开发者理解Python的内存优化策略及潜在陷阱。
本文介绍如何使用Python Tkinter库实现Text输入框内容在界面中的实时显示。通过创建Label和Entry组件,利用StringVar变量绑定机制,将用户输入的内容同步更新到标签显示区域,提供简洁高效的GUI交互示例。
本文总结了Python中实现脚本暂停的三种常用方法:使用time.sleep()指定精确秒数、通过raw_input()等待用户输入,以及利用os.system或subprocess模块执行系统命令。文章详细解析了各方法的原理、参数特性及潜在的时间偏差问题,并推荐在Python 2.4及以上版本使用subprocess模块替代os.system以获得更优的控制能力。
本文介绍利用Python、Keras和TensorFlow构建垃圾分类模型的思路。通过卷积神经网络(CNN)对干垃圾、湿垃圾、有害垃圾及可回收物进行图像分类,详细解析了数据预处理、模型架构搭建及训练流程,为智能垃圾分类提供技术参考。
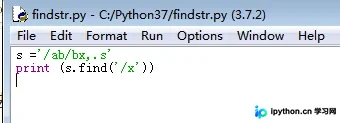
本文详细解析Python中字符串查找函数的使用方法,重点介绍find、rfind、index及rindex四个核心函数。通过具体代码示例演示如何从左至右或从右至左查找子字符串,并对比find返回-1与index抛出异常的区别。文章涵盖查找范围设置、索引值含义及常见错误排查,帮助开发者准确掌握字符串定位技巧。
本文探讨在CT等医学影像处理中,如何将12位至16位的高位深数据映射到仅支持8位显示的终端。文章分析了直接线性映射的局限性,指出其易放大噪声的问题,并提供基于Python和Numpy的具体实现代码,包括基础映射函数及预处理流程,帮助开发者优化图像对比度与关键组织显示效果。
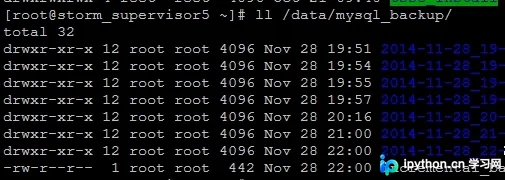
本文介绍如何在Linux环境中配置并部署XtraBackup,通过Shell脚本实现MySQL数据库每天凌晨的全量备份及每小时一次的增量备份。详细涵盖软件安装、依赖处理、脚本逻辑解析(含基准目录管理及自动降级策略)以及备份恢复操作步骤,确保数据安全可靠。
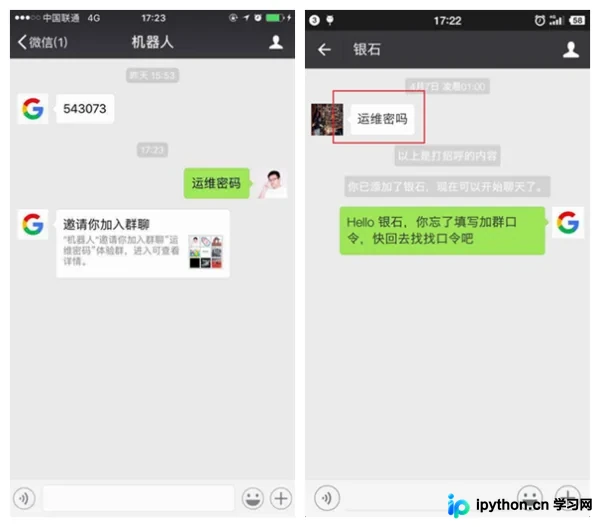
本文详细介绍如何利用Python的wxpy库开发微信自动拉群机器人,解决群满100人后无法扫码加群的痛点。内容涵盖核心代码实现、好友验证逻辑处理,以及在UCloud CentOS 7.2云主机上配置Python 3环境并部署运行的完整步骤,帮助开发者自动化管理微信群。
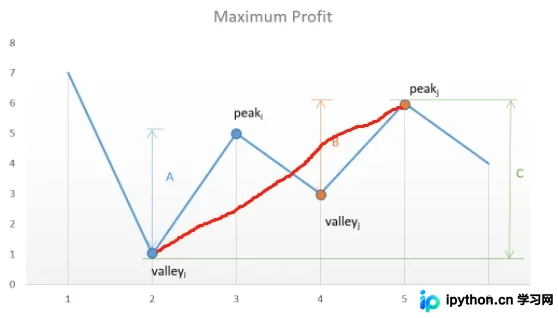
本文详细解析LeetCode中“买卖股票的最佳时机”问题。首先介绍基于双重循环的暴力求解法,分析其时间复杂度高的缺陷;随后引入贪心算法,通过局部最优推导全局最优,实现O(n)时间复杂度的高效解法。文章包含Python代码示例及原理图解,帮助读者理解算法优化思路。
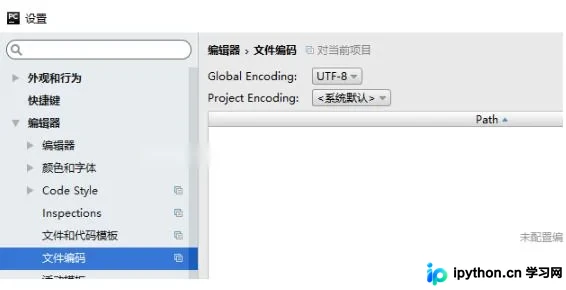
本文介绍在PyCharm中使用os.system调用外部命令时出现中文乱码的解决方法。通过修改Global Encoding为GBK,使IDE控制台编码与Windows保持一致,从而正常显示命令执行结果。