Python Faker库:高效生成高质量测试假数据指南
本文详细介绍Python中Faker库的安装与使用方法。通过配置locale参数,可生成符合特定语言环境的姓名、地址、身份证号等逼真假数据。文章列举了地理、基础信息、网络、时间等9大类常用函数,并演示了如何自定义Provider扩展功能,帮助开发者在软件需求、开发及测试阶段高效获取高质量测试数据。
2026-10-14
18

本文详细介绍Python中Faker库的安装与使用方法。通过配置locale参数,可生成符合特定语言环境的姓名、地址、身份证号等逼真假数据。文章列举了地理、基础信息、网络、时间等9大类常用函数,并演示了如何自定义Provider扩展功能,帮助开发者在软件需求、开发及测试阶段高效获取高质量测试数据。
本文详细介绍在Python3中实现数组逆序输出的两种常见方法。第一种通过首尾元素交换逻辑反转列表,第二种演示如何将文件内容读取至列表后逆序写入新文件。文章包含完整代码示例与结果展示,帮助开发者掌握基础的数据处理技巧。
本文详细介绍如何在PyCharm中快速创建Scrapy爬虫项目。主要步骤包括:新建Python项目、通过Settings配置并安装Scrapy库(建议更换下载源以防超时),最后利用Terminal终端执行scrapy startproject命令完成项目初始化。文章涵盖环境配置与命令行操作,帮助开发者高效搭建爬虫开发环境。
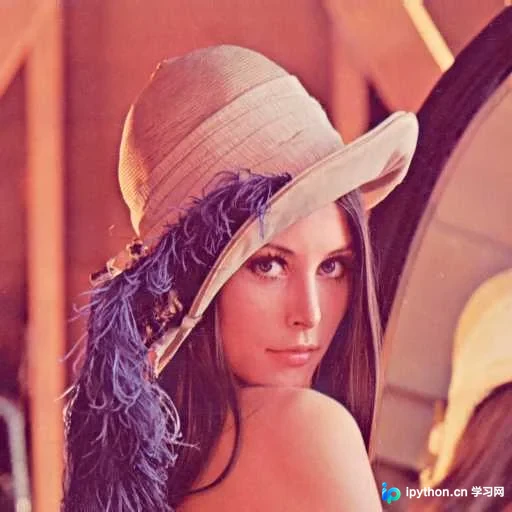
本文介绍如何在Python中利用OpenCV读取图像并通过Matplotlib显示。重点解析OpenCV的BGR通道与Matplotlib RGB通道的差异导致的色差问题,并提供调换通道顺序的解决方案。同时讲解基于加权公式的图像灰度化算法及正确显示灰度图的方法,确保输出结果符合预期。
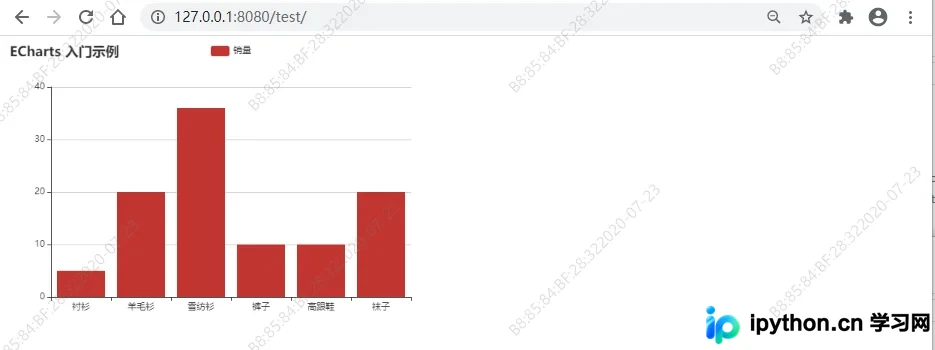
本文详解如何在Django项目中集成ECharts库。通过配置静态文件与模板,实现基础静态图表展示;进一步演示如何从数据库获取数据并渲染至前端。此外,文章提供了基于jQuery的异步请求方案,实现ECharts数据的实时动态刷新,为Web应用提供高效的数据可视化解决方案。
本文介绍在JavaScript中利用split方法将逗号分隔的字符串转换为数组,并提取前两个元素。通过prompt获取用户输入,演示如何将结果输出至控制台并在HTML页面中显示格式化文本,帮助初学者掌握基础DOM操作与字符串处理方法。
在使用OpenCV读取并显示图片时,常因BGR通道顺序导致颜色异常(如变绿)。此外,将彩色图转为灰度图后直接通过matplotlib显示,若未指定cmap参数,仍可能以三通道方式渲染,导致图像显示为绿色而非预期的灰度效果。本文详解从读取、转换到正确显示的完整流程,重点讲解plt.imshow()中cmap参数的关键作用。
本文深入解析MySQL索引创建的四个核心判断标准。首先明确索引能降低IO与排序成本,但并非所有字段都适合建立索引。文章详细说明了为何频繁查询的字段应建立索引,而唯一性差(如状态位)、更新频繁或非WHERE条件的字段则不宜建立,以避免增加IO负担和索引维护开销,帮助开发者精准优化数据库性能。
本文详细讲解如何使用Python爬虫获取百度指数数据。针对百度指数接口变更的情况,提供了包含请求头设置、Cookie处理及数据解密逻辑的完整代码示例。通过解析API返回的加密数据,实现关键词搜索量的获取,适用于数据分析及股票趋势观察等场景。
本文讲解C语言中带头结点的单链表核心操作。通过结构体定义与动态内存分配,实现链表的初始化创建;演示基于索引的节点查找算法;重点解析头插法与尾插法的逻辑差异,以及在指定位置插入和删除节点的指针操作技巧,提供完整且注释详细的代码示例供参考。
本文介绍一款Python工具,可将Bilibili网页端下载的m4s视频与音频缓存文件批量合成为标准MP4格式。版本2.5新增按UP主分类存放及新标题格式功能。使用前需确保系统已安装并配置FFmpeg环境变量。
本文提供基于Python的猜拳游戏完整代码,支持用户登录与注册功能,并将用户信息、注册数据及猜拳胜率记录持久化保存至TXT文件。代码详细演示了如何读取、解析并更新本地文本数据,适合Python初学者参考学习文件操作与基础逻辑实现。