

Python遍历元组时怎么同时获取索引和值

在 Python 中遍历元组并同时获取元素的索引和值,最直接且推荐的做法是使用内置函数 enumerate()。该函数能够在每次迭代时自动将当前位置的索引编号与元素本身组合为一个二元组产出,开发者通过直接解包即可分别拿到这两个变量。这种方式既不需要额外定义计数器,也无需通过下标进行二次查表,能够有效保持代码简洁与运行高效。
一、核心推荐方案:使用 enumerate() 函数
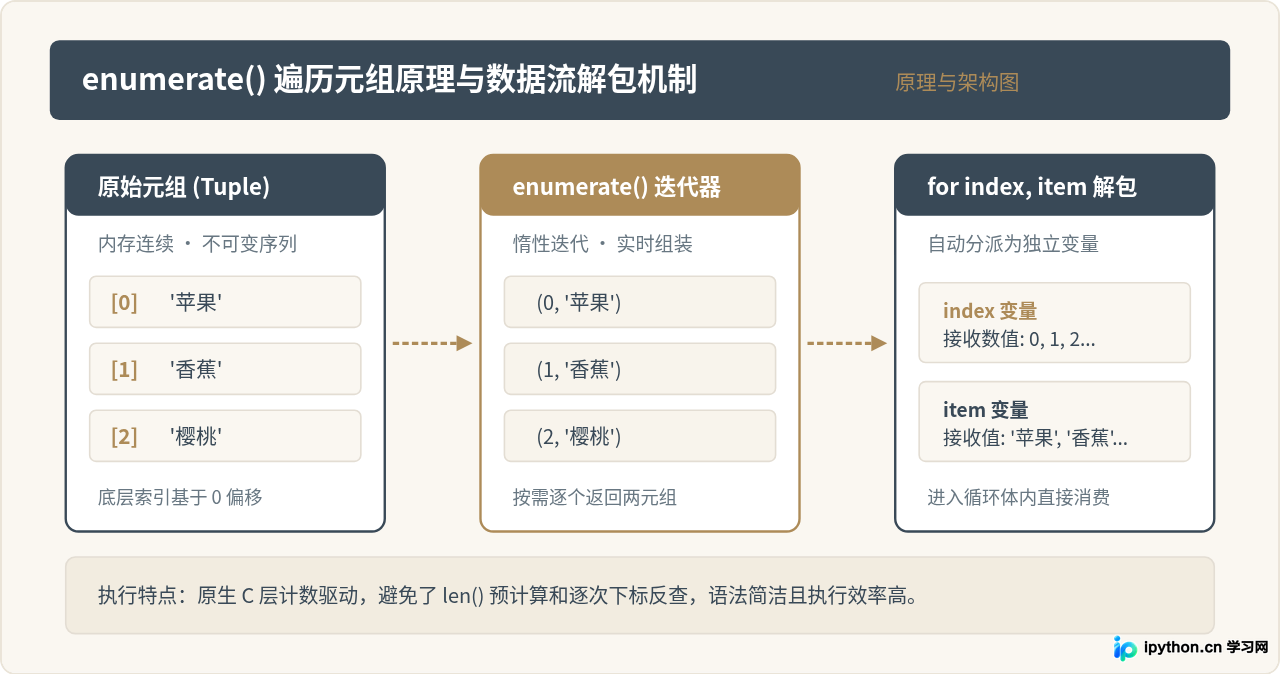
元组(Tuple)是 Python 中典型的不可变序列。当需要对其中的元素逐一处理并记录位置序号时,使用 enumerate() 是官方标准库提供的标准解法。它的基本语法非常直观:将目标元组作为参数传入 enumerate(),并在 for 循环中通过两个变量接收解包结果。
# 定义一个示例元组
fruits = ("苹果", "香蕉", "樱桃", "橙子")

# 使用 enumerate() 同时获取索引和值
for index, item in enumerate(fruits):
    print(f"索引: {index}, 元素值: {item}")
索引: 0, 元素值: 苹果
索引: 1, 元素值: 香蕉
索引: 2, 元素值: 樱桃
索引: 3, 元素值: 橙子在底层机制上,enumerate(fruits) 返回的是一个惰性迭代器对象。在每次循环步进时,它在 C 语言层面维护自增游标并与元组元素配对,产出形式为 (0, '苹果')、(1, '香蕉') 的二元组。循环语句中的 for index, item in ... 则应用了序列解包机制,将元组的首项赋给 index,第二项赋给 item。整个过程无需在 Python 解释器层面创建临时列表,内存开销为常数级别 O(1)。
二、灵活控制序号:自定义起始索引
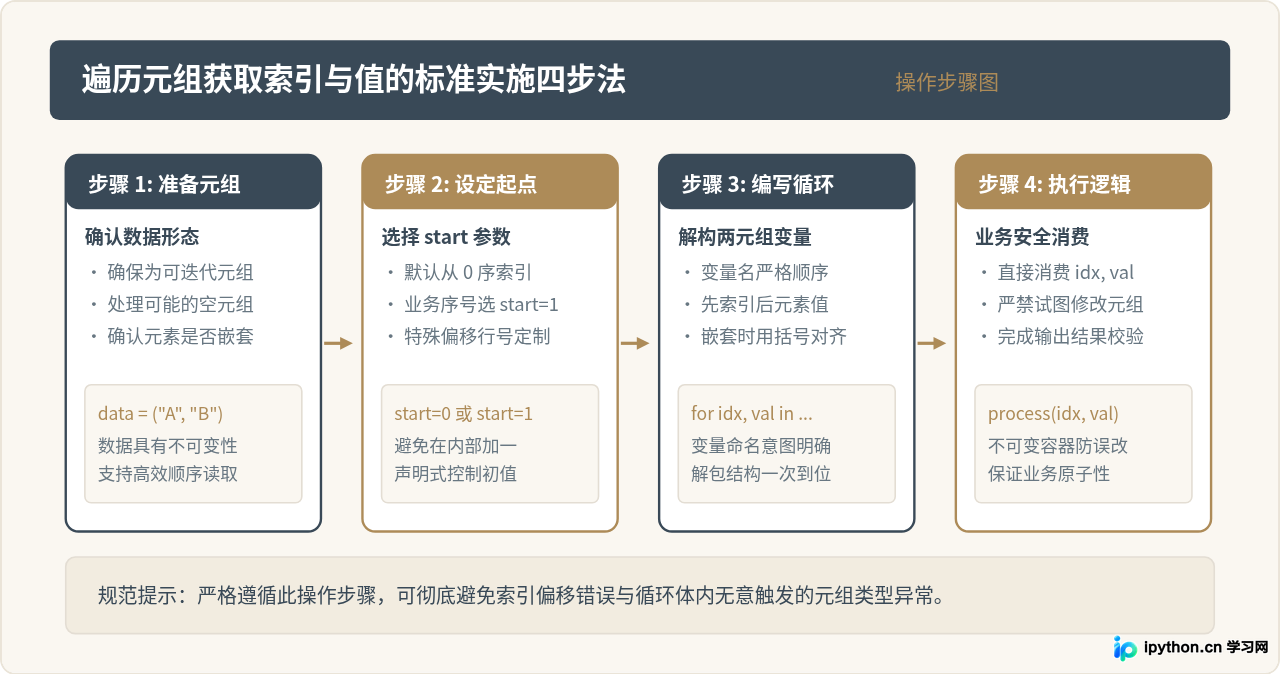
在日常开发中,数组和元组虽然在程序底层以 0 作为起始索引,但许多业务场景需要符合人类阅读习惯的计数方式(如任务清单、报表行号、显示排名等)。如果手动在循环体内执行 index + 1,不仅会增加冗余代码,还容易引发逻辑疏漏。
enumerate() 函数提供了可选的命名参数 start,允许直接指定起始计数值。当设定 start=1 时,首个元素的序号将直接从 1 开始累加:
# 任务清单元组
workflow_tasks = ("需求分析", "架构设计", "代码实现", "质量验证")

# 使用 start=1 指定从 1 开始编号
for step_number, task_name in enumerate(workflow_tasks, start=1):
    print(f"步骤 {step_number}: {task_name}")
步骤 1: 需求分析
步骤 2: 架构设计
步骤 3: 代码实现
步骤 4: 质量验证
需要明确的是,参数 start 仅仅改变了迭代时产出的数值序列,并不会对原始元组内部的物理索引产生任何修改。底层元组的第一项依然可以通过 workflow_tasks[0] 进行访问。该参数接受任何合法整数,例如设置 start=100 即可生成工单序列号。
三、方案对比:为什么不建议使用下标与手动计数
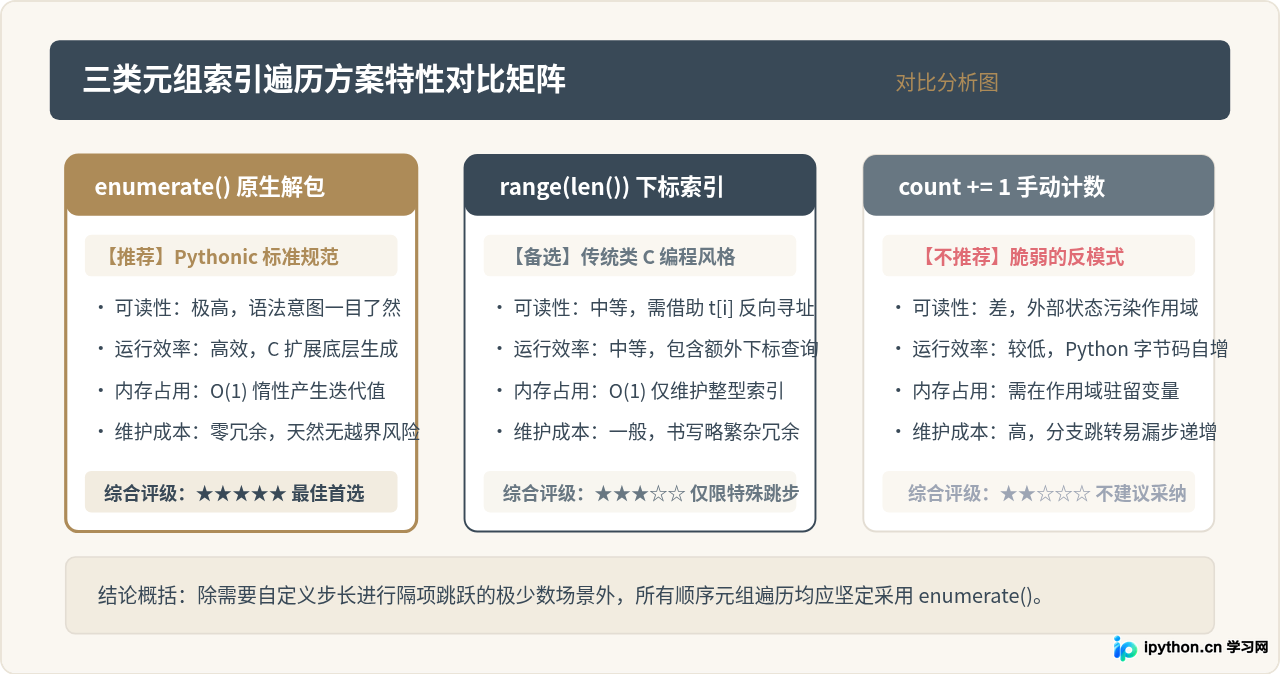
部分初学者在接触 enumerate() 之前,通常会借助其他编程语言的习惯,使用 range(len(...)) 或者在外部定义变量手动递增。这两种方案虽然能够达成相同的结果,但在代码优雅度、性能及潜在缺陷上存在明显差距。
1. range(len(...)) 方案的不足
# 传统下标遍历方案
fruits = ("苹果", "香蕉", "樱桃")
for i in range(len(fruits)):
    item = fruits[i]  # 需通过下标额外反查元素
    print(f"索引: {i}, 元素: {item}")
在上述代码中,程序首先需要调用 len() 测量元组长度,接着构建 range 迭代器,并在每个循环周期通过 fruits[i] 重新查找元组元素。这导致了一次额外的下标寻址计算,且代码表现较为繁琐,未能充分发挥 Python 迭代器协议的优势。
2. 手动维护计数器方案的缺陷
# 手动计数器方案
fruits = ("苹果", "香蕉", "樱桃")
count = 0
for item in fruits:
    print(f"索引: {count}, 元素: {item}")
    count += 1  # 极易在包含 continue 或复杂分支时遗漏
手动维护计数器需要在循环外部污染全局作用域或外部作用域命名,并且必须在循环体的每次迭代中手动执行 count += 1。一旦循环体内包含 continue 跳转或多个异常分支,极易发生计数遗漏,属于典型的反模式(Anti-pattern)。
四、进阶场景:嵌套元组的同步解包
在处理复杂业务数据(如坐标集合、人员清单、键值数据组)时,元组中的每个元素本身往往也是一个子元组。此时如果使用 enumerate(),可以直接在循环头部运用嵌套解包语法,同时获取外层索引与内层各项具体数据。
# 包含坐标点数据的嵌套元组
coordinate_points = (
    ("点A", 120.15, 30.28),
    ("点B", 121.47, 31.23),
    ("点C", 118.78, 32.04)
)

# 语法格式:for 索引, (内层字段1, 内层字段2, ...) in enumerate(...)
for index, (label, longitude, latitude) in enumerate(coordinate_points, start=1):
    print(f"坐标 #{index} [{label}]: 经度={longitude}, 纬度={latitude}")
坐标 #1 [点A]: 经度=120.15, 纬度=30.28
坐标 #2 [点B]: 经度=121.47, 纬度=31.23
坐标 #3 [点C]: 经度=118.78, 纬度=32.04
在此语法中,圆括号 (label, longitude, latitude) 的作用至关重要。它明确告知 Python 解释器:第二个解包目标是一个三元组,需要进一步向下拆解。如果缺少这层括号而写成 for index, label, longitude, latitude in enumerate(...),则解释器会试图在顶层解包四个变量,但 enumerate() 的输出永远只有两个元素(索引和值),从而触发 ValueError: too many values to unpack (expected 4) 异常。
五、常见问题与避坑指南
为了保证遍历逻辑的稳健性,在编写相关代码时需要重点规避以下几个易错点:
- 变量解包顺序颠倒:
enumerate()产出的二元组结构永远是(索引, 元素值)。如果误写为for val, idx in enumerate(data):,则val会接收到整数序号,而idx会接收到元组内容,导致逻辑完全混乱。 - 试图修改元组的不可变性:元组创建后元素内容不可变。在遍历中通过
data[index] = new_value尝试修改会立即抛出TypeError: 'tuple' object does not support item assignment。若需要修改,应结合列表推导式构建新元组。 - 循环体内提前耗尽生成器:若将
enumerate()生成的对象赋值给外部变量后再进行多次遍历,该对象作为单向迭代器会在首次遍历后耗尽。建议直接在for循环语句中使用。
六、总结
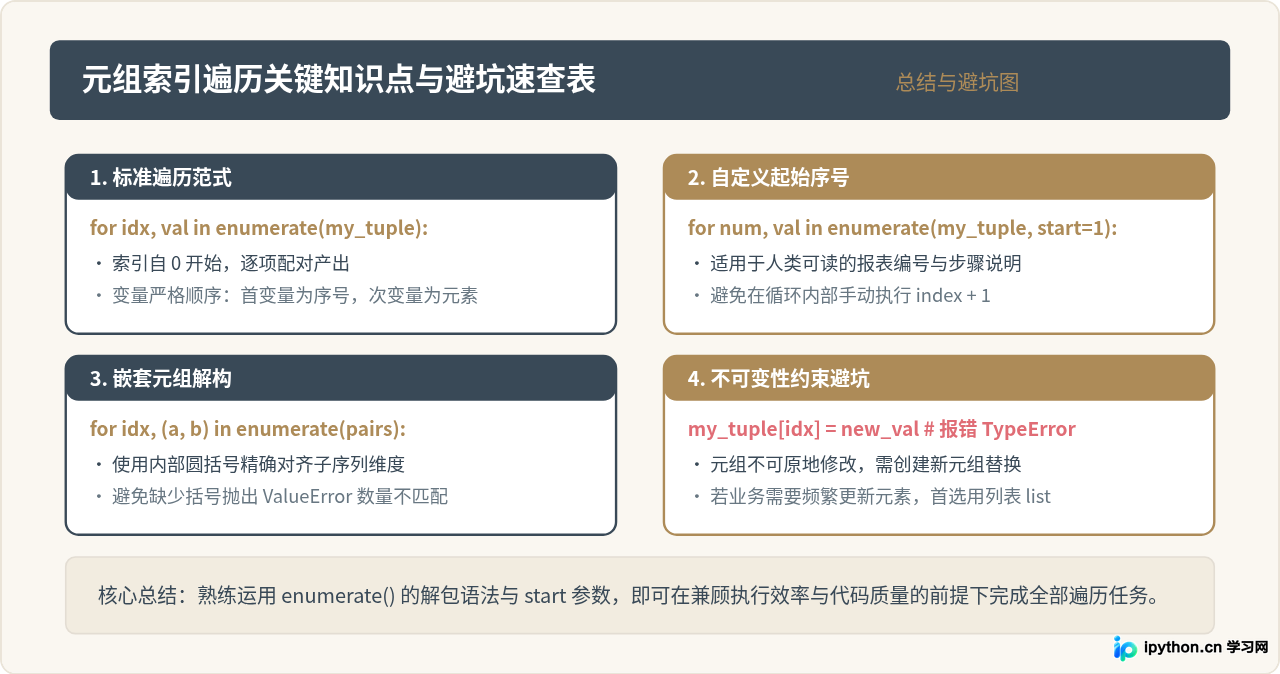
遍历元组并同步获取索引与值,是日常 Python 开发中最基础也是最高频的操作之一。通过使用内置的 enumerate() 函数,开发者可以编写出符合 Pythonic 哲学的精炼代码。配合 start 参数与解包语法,不仅能够灵活覆盖各种复杂的数据展现需求,更能从源头上杜绝下标越界与计数遗漏的隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









