

Python自动化测试中字典和列表的断言技巧

在接口自动化与端到端测试中,服务返回的响应大多是以 JSON 为基础解析出的 Python 字典与列表。假设接口返回了一组包含自增 ID、当前时间戳、随机令牌和业务数据的字典,测试人员如果直接使用 assert response == expected 进行全量比较,测试用例常常会因为几毫秒的时间偏差或自增主键变动而频繁报红。解决这个问题的核心,在于根据测试意图选用针对性的断言策略:对字典进行键值子集校验、过滤动态字段,对列表区分有序序列比对与无序集合判定,并结合深层嵌套解析与 pytest 诊断机制,让自动化测试既严密又稳定。
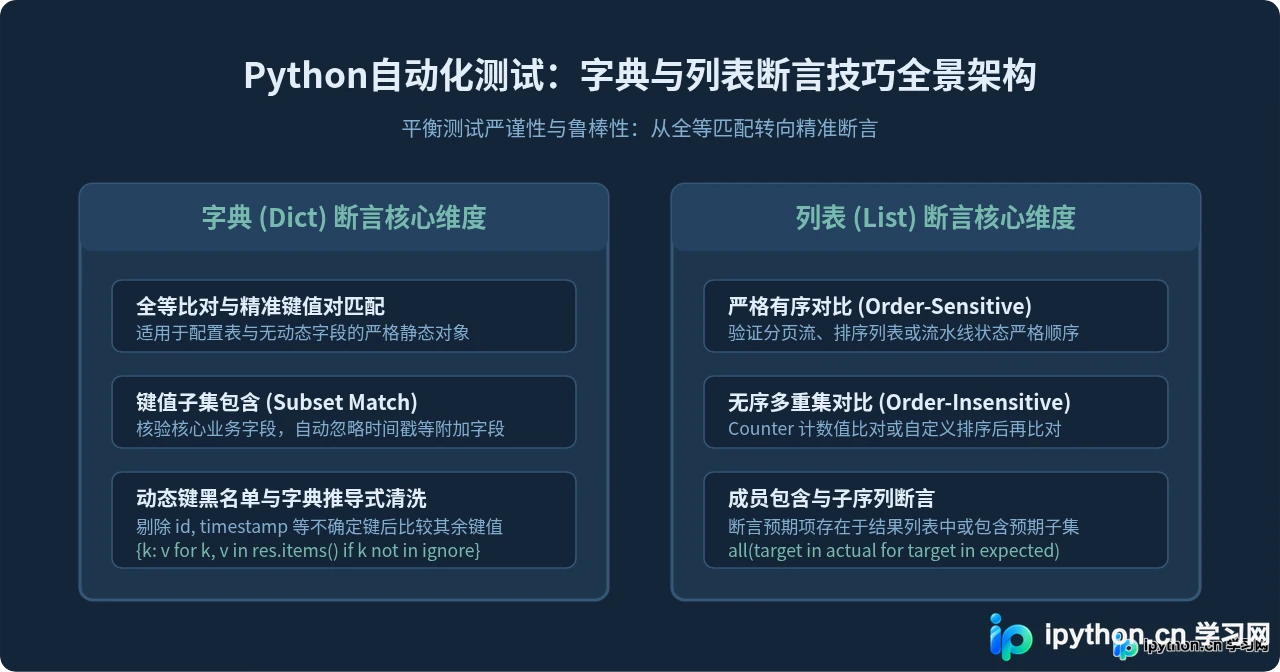
一、字典断言技巧:由全量比对转向子集与动态校验
字典断言中最常见的误区是直接使用全等断言 actual == expected。在绝大多数真实业务系统中,返回的数据往往包含时间戳、请求流水号、自增主键或服务端环境标识,这些字段每次调用都在变化。如果直接全量比对,不仅用例脆弱,还容易掩盖真正的业务逻辑缺陷。
1. 键值子集断言(Subset Matching)
当只关注接口是否返回了关键的业务字段及其正确值时,子集断言是最干净的做法。在 Python 3 中,字典的 items() 视图对象支持集合视图运算(若值是可哈希的),或者可以通过字典推导式进行快速校验:
def test_user_profile_subset():
    actual_response = {
        "user_id": 10086,
        "username": "tester_alice",
        "role": "admin",
        "created_at": "2026-10-09T12:00:00Z",
        "trace_id": "req-98f3-a12b"
    }

    expected_subset = {
        "username": "tester_alice",
        "role": "admin"
    }

    # 方式一:适用于值可哈希的情况(基于 items 集合包含)
    assert expected_subset.items() <= actual_response.items()

    # 方式二:通用推导式(支持嵌套列表或字典等不可哈希值)
    for key, value in expected_subset.items():
        assert key in actual_response, f"响应中缺少键: {key}"
        assert actual_response[key] == value, f"键 {key} 值不匹配,实际: {actual_response[key]}"
2. 动态键清洗与模式比对
如果业务要求除少数动态字段外,其余字段必须完全一致,更稳妥的做法是先排除已知动态字段,再对纯业务数据做全量等值对比:
def test_dict_excluding_dynamic_fields():
    actual = {
        "status": "success",
        "code": 200,
        "token": "tok_xyz_987",
        "timestamp": 1791547800
    }
    expected = {
        "status": "success",
        "code": 200
    }

    ignored_keys = {"token", "timestamp"}
    cleaned_actual = {k: v for k, v in actual.items() if k not in ignored_keys}

    assert cleaned_actual == expected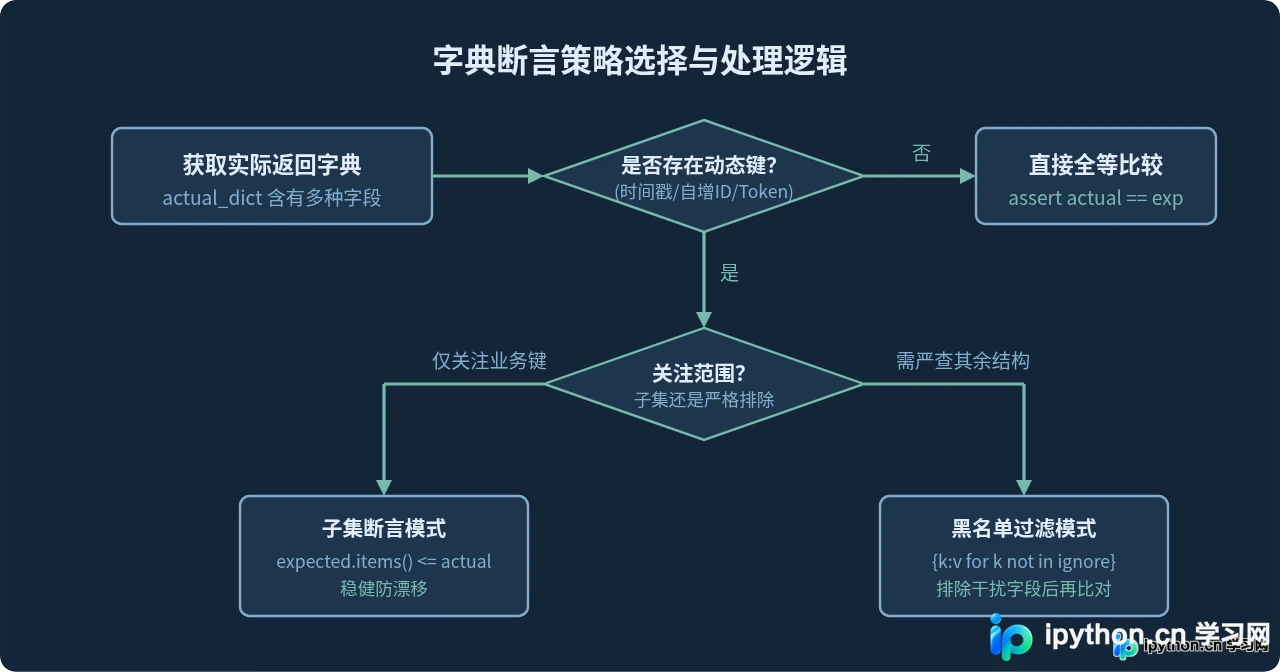
二、列表断言技巧:有序序列与无序多重集
列表断言的核心问题是:被测业务究竟是关注顺序,还是只关注内容?在数据库未指定 ORDER BY 或服务采用多节点并发聚合时,返回列表的顺序很可能是随机的。如果不假思索地直接 assert actual_list == expected_list,极易引发偶发性失败(Flaky Tests)。
1. 严格顺序对比(有序列表)
当测试诸如“文章发布倒序列表”、“排行榜”或“工作流状态按序执行”时,列表顺序本身就是测试点。此时可以直接使用 == 断言,或者在失败时逐项打印索引以辅助定位:
def test_ordered_list():
    actual_workflow = ["CREATED", "PAYING", "PAID", "DELIVERED"]
    expected_workflow = ["CREATED", "PAYING", "PAID", "DELIVERED"]

    # 长度前置检查能快速排除漏项或多项问题
    assert len(actual_workflow) == len(expected_workflow)
    assert actual_workflow == expected_workflow
2. 无序比对(忽略顺序,保留频次)
如果顺序无关紧要,但必须确保元素及其出现次数完全相同,有以下两种最佳实践:
- 元素可哈希(如字符串、整数、元组):使用
collections.Counter比对。这种方式不仅忽略顺序,而且能严格校验重复元素的数量,避免简单转换为set丢失重复项的问题。 - 元素不可哈希(如包含字典的列表):按稳定业务键统一排序后比对,或使用遍历匹配。
from collections import Counter

def test_unordered_hashable_list():
    actual_tags = ["python", "pytest", "python", "backend"]
    expected_tags = ["pytest", "python", "backend", "python"]

    # 错误做法:set(actual_tags) == set(expected_tags) 无法发现重复数量不一致
    # 正确做法:Counter 精确比对元素及其数量
    assert Counter(actual_tags) == Counter(expected_tags)

def test_unordered_dict_list():
    actual_users = [
        {"id": 2, "name": "Bob"},
        {"id": 1, "name": "Alice"}
    ]
    expected_users = [
        {"id": 1, "name": "Alice"},
        {"id": 2, "name": "Bob"}
    ]

    # 按关键业务主键排序后再进行断言
    sorted_actual = sorted(actual_users, key=lambda x: x["id"])
    sorted_expected = sorted(expected_users, key=lambda x: x["id"])
    assert sorted_actual == sorted_expected
3. 列表包含断言(子集与关键成员验证)
很多时候接口可能返回几十条数据,我们只关心新增的那一条或某些特定关键项是否存在:
def test_list_contains_items():
    actual_permissions = ["READ_USER", "WRITE_USER", "DELETE_LOG", "AUDIT_VIEW"]
    required_permissions = ["READ_USER", "WRITE_USER"]

    # 验证是否全部包含
    assert all(perm in actual_permissions for perm in required_permissions)

    # 或者使用集合子集判断
    assert set(required_permissions).issubset(set(actual_permissions))
三、深层嵌套结构的断言实战流程
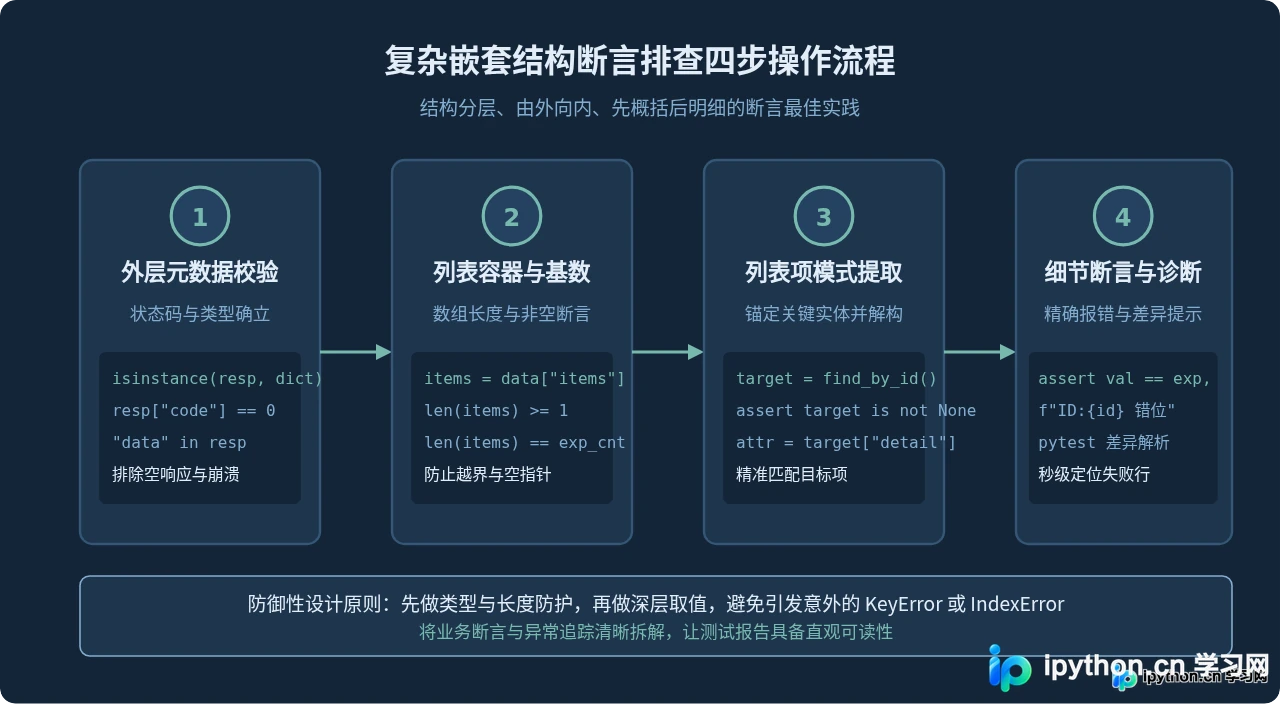
真实生产环境中的 API 往往是多层嵌套的树状结构,例如字典中包含列表,列表中又包含嵌套字典。针对此类复杂数据,按部就班的四步操作法能够帮助测试人员既快速写出稳定的断言,又能在断言失败时迅速锁定报错根因。
代码示例:针对嵌套数据的健壮断言编写
def test_nested_order_detail():
    response = {
        "code": 200,
        "message": "OK",
        "data": {
            "order_id": "ORD-202610-888",
            "status": "PAID",
            "items": [
                {"sku": "SKU-A", "quantity": 2, "price": 49.9},
                {"sku": "SKU-B", "quantity": 1, "price": 108.0}
            ],
            "billing": {
                "currency": "CNY",
                "total_amount": 207.8
            }
        }
    }

    # 步骤 1:外层与类型验证
    assert response["code"] == 200
    assert "data" in response and isinstance(response["data"], dict)

    data = response["data"]
    # 步骤 2:核心字段与列表容器验证
    assert data["order_id"] == "ORD-202610-888"
    assert len(data["items"]) == 2

    # 步骤 3:列表中特定项的匹配提取
    sku_a_item = next((item for item in data["items"] if item["sku"] == "SKU-A"), None)
    assert sku_a_item is not None, "未在商品列表中找到 SKU-A"
    assert sku_a_item["quantity"] == 2

    # 步骤 4:浮点数比对(避免精度漂移)
    from pytest import approx
    assert data["billing"]["total_amount"] == approx(207.8)
四、自动化测试断言的四大常见陷阱与避坑准则
在长期运行的自动化流水线中,断言逻辑若不够严谨,往往会成为假警报的主要来源。以下是四个高频陷阱及应对方案:
| 陷阱类型 | 典型错误写法 | 产生的危害 | 规范防御做法 |
|---|---|---|---|
| 浮点精度误差 | assert actual_price == 19.99 |
底层二进制精度丢失导致 19.990000000000002 不等于 19.99 | 使用 pytest.approx(19.99) 或 math.isclose() |
| 可哈希假象与集合去重 | assert set(actual) == set(expected) |
集合自动去重,若实际返回重复脏数据时断言仍然通过 | 使用 collections.Counter() 验证多重集 |
| 未指定断言失败信息 | assert val in list_a |
pytest 报告仅显示 False,无法获知 val 与 list_a 实际内容 | 附加具名诊断信息:assert val in list_a, f"期望 {val} 存在于 {list_a}" |
| 直接索引取值导致崩用例 | assert resp["items"][0]["id"] == 1 |
当列表为空时抛出 IndexError,掩盖了真实的业务断言失败 |
先断言列表长度,或使用防御性提取 next(...) |
五、全景总结与断言技巧速查
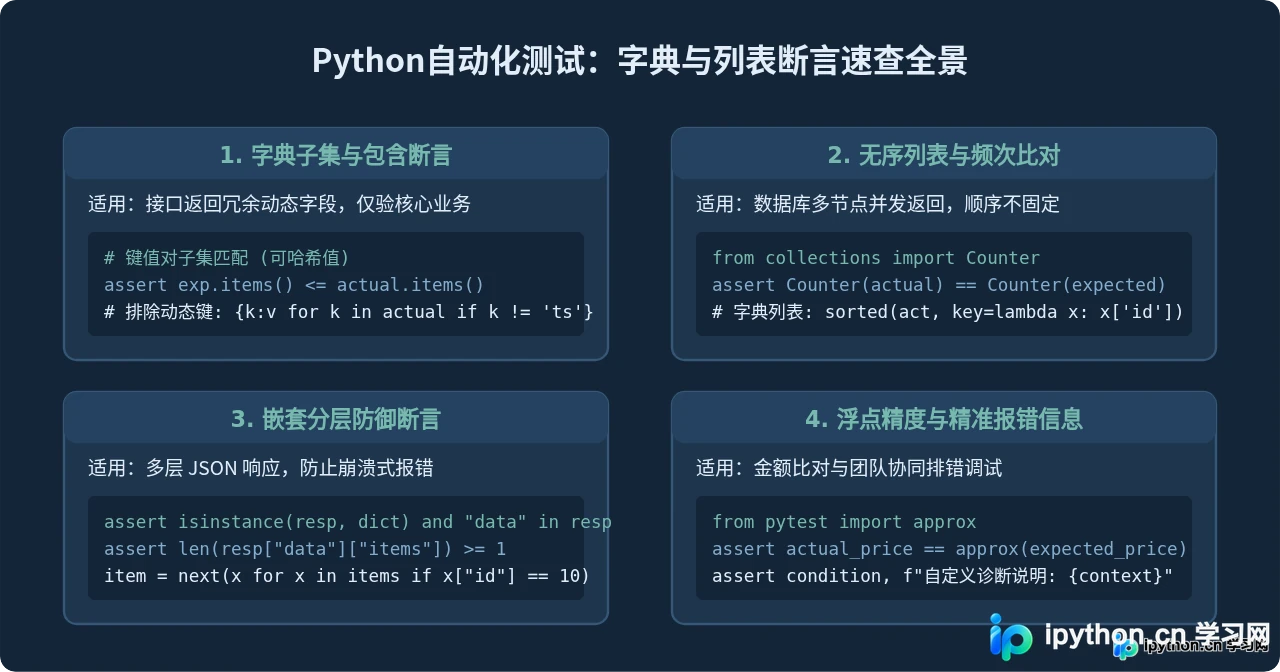
编写高质量的 Python 自动化测试断言,关键在于明确断言边界:清楚区分严格业务校验点与偶发变动字段。对于字典,善用子集与推导式清洗;对于列表,分清有序比对与无序频次比对;对于复杂数据,遵循由外向内的分层校验逻辑。掌握这些技巧,能够让自动化测试套件既能敏锐捕捉真实 Bug,又具备极高的稳定性与可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









