

Python程序员必备技能栈:从基础语法到Web与数据框架的学习路径
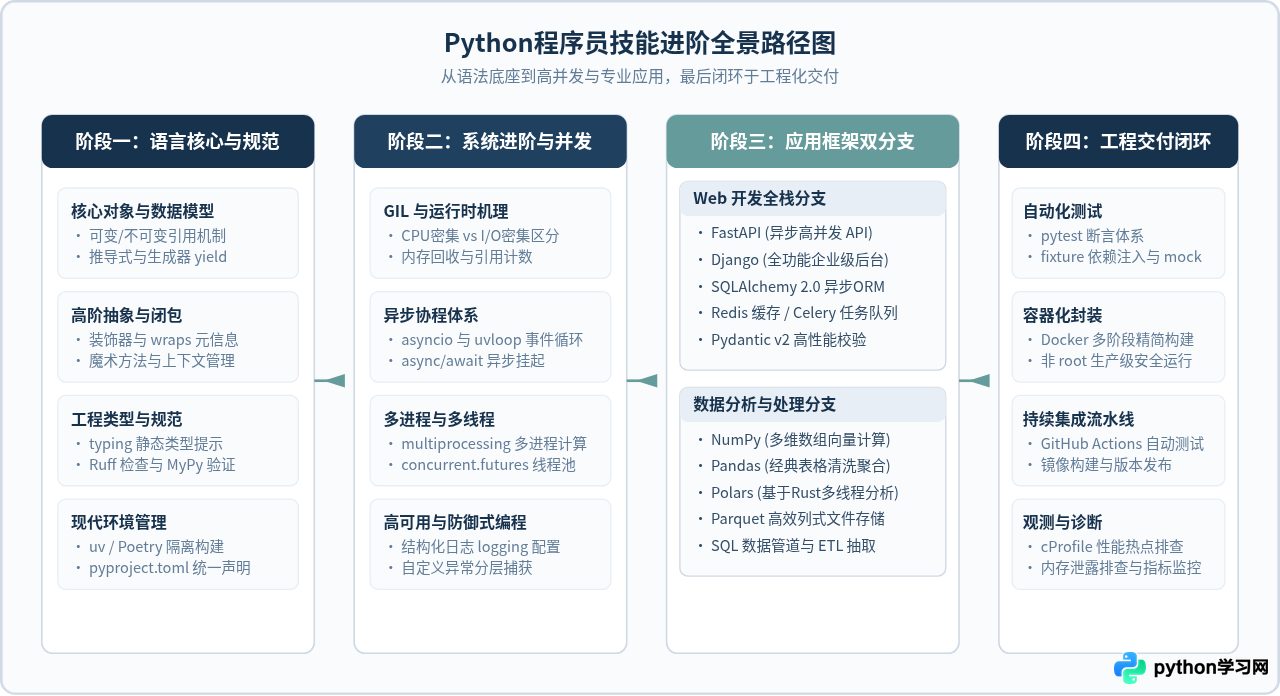
系统梳理Python程序员的进阶路线:从现代语法核心与工程规范起步,夯实并发与系统I/O底层,深入Web开发与数据处理两大主力框架生态,并最终落地于自动化测试与容器化交付。
一、语言核心与现代工程底座
很多初学者容易将大量时间花在重复练习基础的if/else和循环上,但在工程实战中,决定代码健壮度的是对Python数据模型、可变性陷阱、闭包机制及现代类型系统的透彻理解。
1. 数据模型与Pythonic惯用法
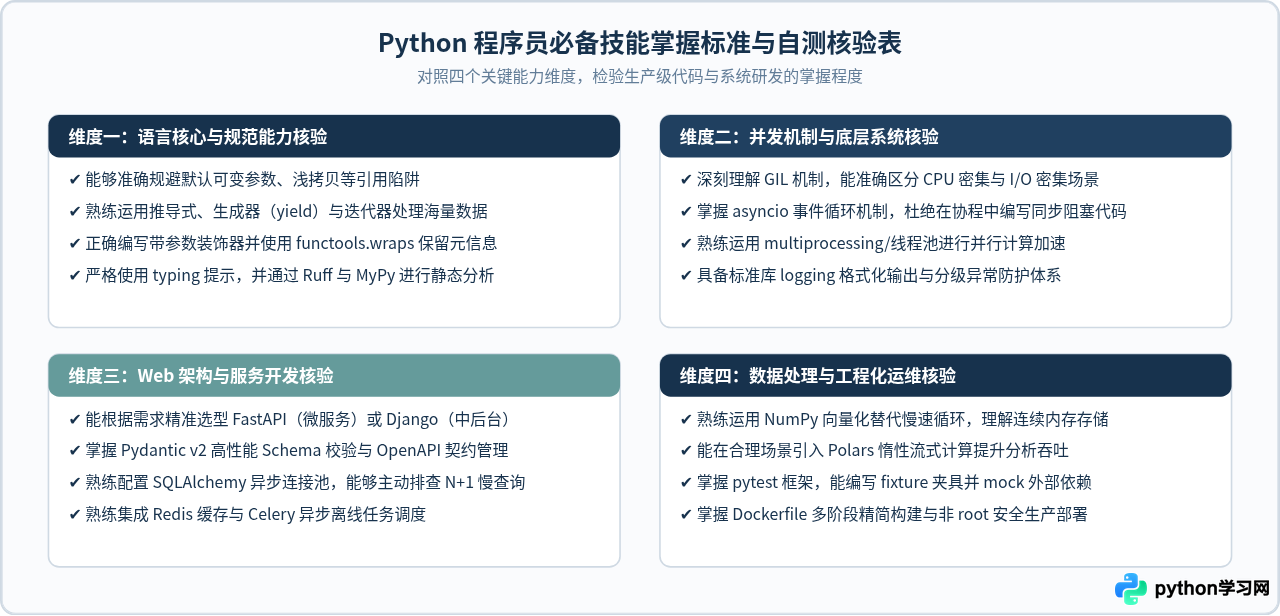
首先需要彻底掌握可变对象(list、dict、set)与不可变对象(int、str、tuple)的传参机制与浅拷贝/深拷贝区别。将默认参数设为可变对象(如 def append_item(val, target=[]))是新手最常出现的引用污染错误;标准做法始终是赋予 None 并在函数内部初始化。
列表推导式、字典推导式不仅书写优雅,在底层依靠C语言指令执行循环,其性能往往优于普通的 for 循环拼接。然而,当处理数百万级数据量时,直接生成完整列表会迅速挤占内存。此时必须理解迭代器协议与生成器(Generator),利用 yield 关键字实现惰性按需产出:
from collections.abc import Generator

def read_large_logfile(filepath: str) -> Generator[str, None, None]:
    """按行惰性流式读取大文件,防止内存溢出"""
    with open(filepath, mode="r", encoding="utf-8") as file:
        for line in file:
            stripped = line.strip()
            if stripped:
                yield stripped
2. 高阶函数、闭包与装饰器
函数在Python中是一等公民(First-Class Citizen),这意味着函数可以作为参数传递、作为返回值返回并保存在变量中。装饰器本质上就是利用闭包在不侵入原函数业务逻辑的前提下,对其进行横切关注点扩展(如耗时统计、身份验证、异常重试)。编写生产级装饰器时,务必使用 functools.wraps 保留原函数的元信息(如文档字符串与函数名):
import functools
import time
from typing import Any, Callable

def monitor_execution_time(func: Callable[..., Any]) -> Callable[..., Any]:
    @functools.wraps(func)
    def wrapper(*args: Any, **kwargs: Any) -> Any:
        start_time = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start_time
        print(f"[执行耗时] {func.__name__}: {duration:.4f}秒")
        return result
    return wrapper
3. 面向对象深入与魔术方法
除了常规的类定义与继承,进阶必须掌握Python的“魔术方法”(Dunder Methods)。通过重写 __getitem__ 和 __len__ 可以让自定义对象具备原生序列的切片与索引能力;重写 __enter__ 和 __exit__ 则能构建健壮的上下文管理器,确保数据库事务或网络连接在发生未捕获异常时仍能可靠释放。
4. 现代类型系统与工程工具链
现代Python工程早已告别了“完全动态无类型”的野蛮生长时代。利用 typing 模块(如 Optional、Union、泛型以及 dataclasses)标注类型,配合 Ruff(极速Linter与格式化器)和 MyPy(静态类型检查器),可以在编码阶段排查绝大多数属性拼写与参数类型错误。而在虚拟环境与依赖管理上,推荐掌握极速依赖管理工具 uv 或 Poetry,彻底替代脆弱的全局环境与容易产生依赖冲突的裸 pip freeze。
二、系统进阶、并发模型与I/O基石
当编写单机脚本转向构建高负载服务时,程序往往会遭遇性能瓶颈。Python程序员必须准确识别应用是属于I/O密集型还是CPU密集型,并据此选择正确的并发模型。
1. 全局解释器锁(GIL)的客观边界
CPython底层拥有全局解释器锁(Global Interpreter Lock),它确保在任何时刻只有一个操作系统线程执行Python字节码。这一机制决定了:在标准CPython环境下,纯Python的多线程(threading)无法利用多核CPU进行并行数值计算。但是,当线程遇到网络请求、磁盘读写或进入底层C扩展(如NumPy矩阵乘法)时,GIL会被主动释放。因此:
- CPU密集型任务(如加解密、图像处理、复杂数学运算):必须使用
multiprocessing模块或ProcessPoolExecutor,通过多进程分配到不同CPU核心独立运行。 - I/O密集型任务(如爬虫采集、多接口HTTP聚合调用、文件下载):使用轻量级协程
asyncio或是ThreadPoolExecutor。
2. asyncio 异步事件循环核心实战
asyncio 采用单线程单进程模式,通过事件循环(Event Loop)配合非阻塞套接字实现极高并发。当协程遇到 await 关键字时,它会出让当前执行权,让事件循环处理其他就绪任务,待I/O完成后再由循环唤醒继续执行。对比创建数千个系统线程所需的栈内存开销(每个线程默认占用数兆字节),协程在内存和上下文切换上的开销几乎可忽略不计:
import asyncio
from typing import List

async def fetch_remote_resource(task_id: int, delay_seconds: float) -> str:
    # 模拟非阻塞I/O网络请求,不要在async函数中使用time.sleep()
    await asyncio.sleep(delay_seconds)
    return f"任务 [{task_id}] 响应成功"

async def main() -> None:
    # 并发聚集运行多个异步任务
    tasks = [fetch_remote_resource(idx, 0.5) for idx in range(1, 6)]
    results: List[str] = await asyncio.gather(*tasks)
    for item in results:
        print(item)

if __name__ == "__main__":
asyncio.run(main())避坑提示:在 async def 定义的协程内部,绝对不能调用阻塞式的同步库函数(例如 time.sleep()、标准 requests.get() 或同步数据库查询)。任何同步阻塞操作都会直接卡死整个事件循环,导致所有并发任务全部暂停。应当替换为对应的异步驱动(如 asyncio.sleep()、httpx.AsyncClient、asyncpg)。
三、Web后端服务开发体系
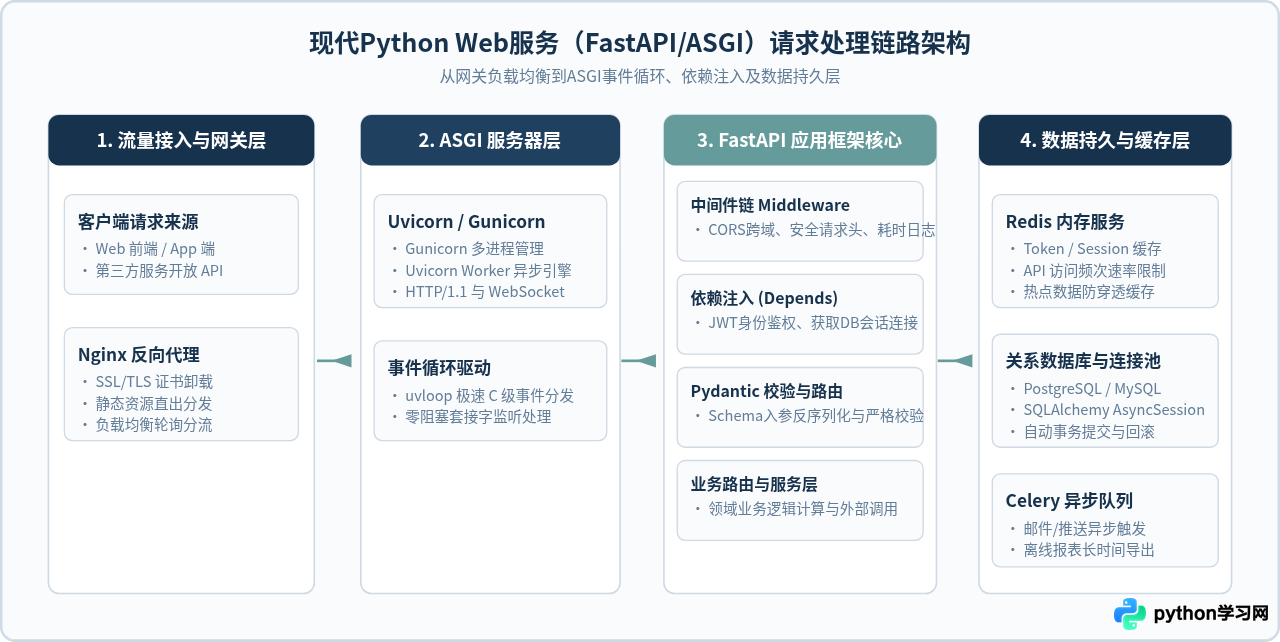
在后端服务领域,Python已经形成了以轻量级高性能异步API框架 FastAPI 与成熟全功能全栈框架 Django 为核心的双雄格局。掌握Web后端开发不仅是掌握框架API,更要掌握请求从网关到ORM的完整链路。
1. 框架选型与适用场景
| 选型维度 | FastAPI (ASGI) | Django (WSGI / ASGI) |
|---|---|---|
| 核心定位 | 现代高性能异步微服务、纯REST/GraphQL API | 全功能开箱即用大型中后台、CMS、企业系统 |
| 生态特点 | 极度精简,深度集成 Pydantic 数据验证与 OpenAPI | “电池齐全”,内置完善后台Admin、认证Auth、ORM系统 |
| 数据库交互 | 自由搭配 SQLAlchemy 2.0 / Tortoise ORM | 自带强大的 Django ORM,易用但高度耦合 |
| 推荐场景 | 高并发API、前后端分离架构、机器学习模型部署 | 功能快速迭代、多角色权限后台、企业级管理系统 |
2. FastAPI与现代ORM工程模式
FastAPI的优势在于通过类型提示直接完成参数校验与文档自动生成。配合 SQLAlchemy 2.0 异步引擎(AsyncSession),可以轻松构建安全且高吞吐的数据库接口:
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel, Field, EmailStr
from typing import Optional

app = FastAPI(title="用户中心服务", version="1.0.0")

class UserCreateRequest(BaseModel):
    username: str = Field(..., min_length=3, max_length=32, description="用户唯一账号")
    email: EmailStr = Field(..., description="有效电子邮箱")
    age: Optional[int] = Field(None, ge=1, le=150)

class UserResponse(BaseModel):
    id: int
    username: str
    email: EmailStr

@app.post("/api/v1/users", response_model=UserResponse, status_code=status.HTTP_201_CREATED)
async def create_user(payload: UserCreateRequest) -> UserResponse:
    # Pydantic在进入业务前已严格校验入参类型与边界
    new_user_id = 1001  # 模拟数据库异步插入后返回的主键
    return UserResponse(
        id=new_user_id,
        username=payload.username,
        email=payload.email
    )
四、数据处理与分析核心框架栈
在数据科学、数据工程与自动化分析领域,Python拥有极其庞大且高效的生态。理解这一技术栈的关键在于理解内存连续布局与向量化计算,切忌用Python原生for循环直接处理大规模数值矩阵。
1. 算力底座:NumPy 向量化运算
numpy.ndarray 相比原生Python列表具有本质差异:列表存储的是分散在内存各处的对象指针,每次迭代都要解引用并做动态类型检查;而 ndarray 是一段连续分配的C语言同构内存块。配合SIMD指令集与广播机制(Broadcasting),向量化计算比普通Python循环快数十倍乃至上百倍:
import numpy as np

# 构造具有 100 万个浮点数的数组
data = np.random.randn(1_000_000)

# 正确做法:直接向量化计算,交由底层C代码循环
standardized = (data - np.mean(data)) / np.std(data)

# 严禁写法:使用 Python 显式 for 循环遍历每一个元素做数学运算
2. 表格数据分析:Pandas 与新一代 Polars 对比
长期以来,Pandas 是数据处理的行业事实标准,涵盖丰富的数据过滤、缺失值填充、分组聚合(groupby)和透视表功能。然而,Pandas底层严重依赖单线程与频繁的内存深拷贝,在大规模数据(GB级别以上)时容易产生内存激增乃至OOM(内存溢出)。
近年来异军突起的 Polars 则基于 Rust 构建,支持原生多线程并行执行引擎,并引入了类似于SQL查询优化器的惰性执行(LazyFrame)。在复杂的数据流水线中,Polars可以在执行前自动下推谓词过滤与投影裁剪,极大降低内存占用:
import polars as pl

# 利用 Polars 的 LazyFrame 实现多线程流式高效过滤与聚合
query = (
    pl.scan_parquet("large_sales_records.parquet")
    .filter(pl.col("amount") > 100.0)
    .group_by("region")
    .agg([
        pl.col("amount").sum().alias("total_sales"),
        pl.col("order_id").count().alias("order_count")
    ])
    .sort("total_sales", descending=True)
)

# 此时才真正编译执行优化后的物理查询计划
df_result = query.collect()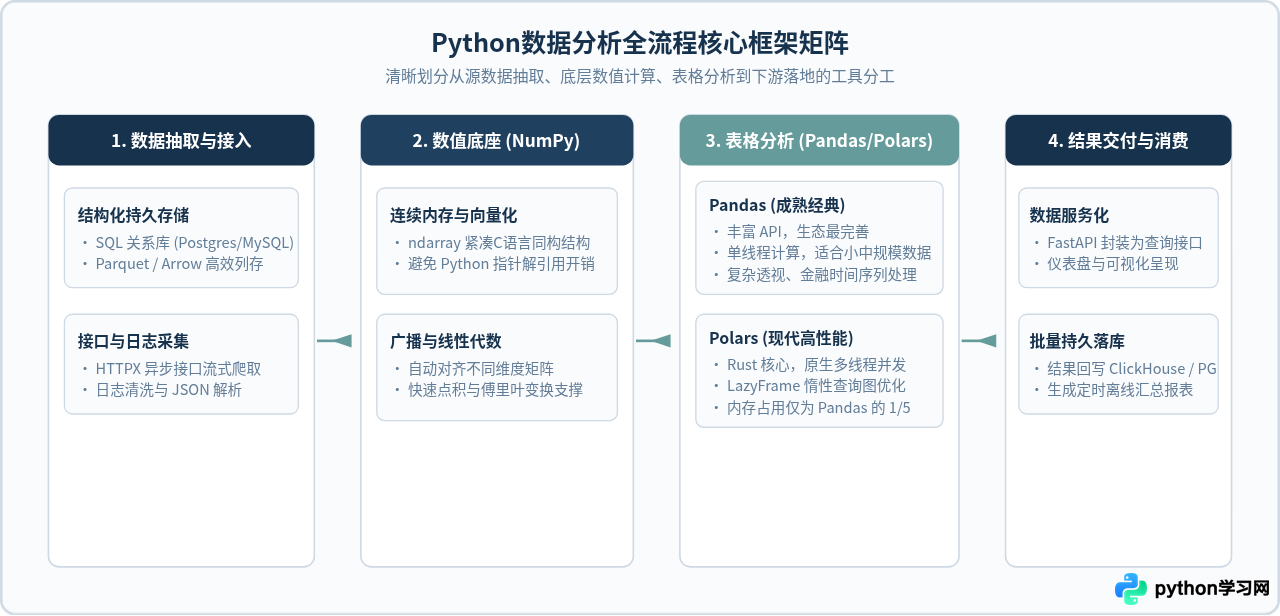
五、工程化交付、质量保证与部署运维
能写出实现业务功能的代码只代表掌握了语言用法,而让代码在团队协作和复杂生产环境中稳定运行,必须依靠成熟的工程交付体系。
1. 自动化测试体系(pytest)
放弃臃肿老旧的 unittest,全面拥抱 pytest。其优雅的核心优势包括直接使用原生 assert 表达式断言,以及强大的 fixture(夹具) 机制。通过 fixture 可以轻松管理测试数据库的建立与回滚、依赖注入以及模拟外部HTTP依赖(利用 pytest-mock):
import pytest
from typing import Generator

# 定义测试前置夹具,管理测试数据库或虚拟资源
@pytest.fixture
def mock_db_connection() -> Generator[dict, None, None]:
    # 模拟建立测试专用连接
    test_context = {"status": "connected", "data_store": []}
    yield test_context
    # 测试执行完毕后的清理逻辑(Teardown)
    test_context["data_store"].clear()

def test_insert_record(mock_db_connection: dict) -> None:
    mock_db_connection["data_store"].append({"id": 1, "name": "Antigravity"})
    assert len(mock_db_connection["data_store"]) == 1
    assert mock_db_connection["data_store"][0]["name"] == "Antigravity"
2. 生产级 Docker 容器化最佳实践
生产环境部署必须使用 Docker 确保环境一致性。在编写 Python Dockerfile 时,必须注意以下几点:
- 使用官方精简镜像:如
python:3.11-slim,避免使用包含冗余构建包的肥大镜像。 - 多阶段构建(Multi-stage Build):在构建阶段安装编译依赖,在运行阶段仅拷贝轮子(wheels)或虚拟环境,产出极致轻量的最终镜像。
- 遵循非 Root 安全原则:在镜像内创建专门的低权限系统用户(如
appuser)运行进程,降低安全逃逸风险。 - 设置正确的环境变量:设置
PYTHONUNBUFFERED=1保证日志即时输出到标准输出,避免缓冲区阻碍日志实时收集;设置PYTHONDONTWRITEBYTECODE=1避免生成多余的.pyc文件。
六、学习路径推进策略
技能体系的掌握并非一蹴而就,建议读者分三个阶段逐步落地:
- 初阶固本(前1~2个月):使用
uv初始化项目骨架,配置好ruff和mypy。通过编写命令行工具(CLI)练习生成器、装饰器、类型注解与异常处理,让每一行代码都符合现代规范。 - 中阶筑基(第3~4个月):攻克
asyncio协程机制,使用FastAPI开发一套具备 JWT 认证、Redis 限流和 SQLAlchemy 异步读写的 RESTful 服务,同时为每个接口编写pytest单元测试与接口集成测试。 - 高阶拓展(第5~6个月):根据职业规划决定深耕方向:若侧重后端架构,深入学习微服务、消息队列(Kafka/RabbitMQ)与 Docker 容器化编排;若侧重数据方向,系统掌握 NumPy 向量化运算与 Polars 惰性数据管道,形成端到端的数据处理与报表输出能力。
遵循这套循序渐进的路径,结合实际工程场景不断实操验证,即可从“只会写脚本的语法初学者”,稳步成长为具备系统性架构思维与生产交付能力的专业 Python 工程师。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









