

Python制作中文词云乱码怎么办?结合jieba分词的完整解决方案
针对Python制作中文词云时出现的矩形方框乱码、整句无法切分等问题,本文结合jieba精确分词与WordCloud的font_path参数,提供跨平台字体路径配置、停用词过滤及排查自检的完整解决方案。
在 Python 中使用 wordcloud 库处理中文文本时,初学者几乎必然会遇到两类异常:一是生成的图片中所有汉字都变成矩形方块(俗称“豆腐块”乱码);二是程序虽然输出了汉字,但整句话被当作单个词汇排布在画布上,完全失去了词频统计与词云聚类的意义。这两个问题的根源分别在于默认字体缺乏中文字形以及中文缺乏自然空格分隔。解决这一问题的标准工程路径是:使用 jieba 对中文进行词法切分,并在实例化 WordCloud 对象时显式指定有效的中文字体路径(font_path)。
一、中文词云两大失效机制与根本原因
要彻底排除中文词云的渲染故障,需要理解 wordcloud 库的原生设计假定及其与中文文本特性之间的冲突。
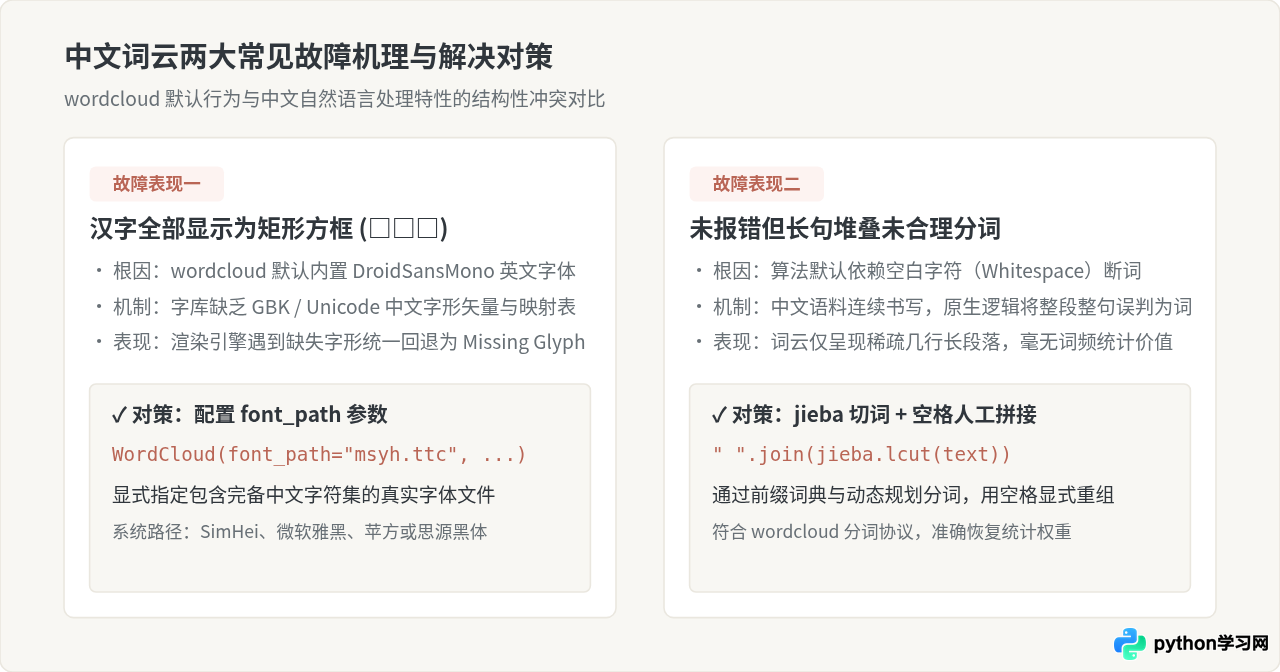
首先是字符集缺失导致的方块乱码。wordcloud 原生默认载入内置的 DroidSansMono.ttf 字体。该字体属于拉丁字符集英文字库,内部未封装任何中文字形点阵与 Unicode 映射表。当渲染引擎读取中文 Unicode 编码时,无法在字库中检索到对应的字形字模,字体引擎便会自动降级绘制为缺失占位符(即矩形框 □)。
其次是语言分词规则的差异。在英文等西方语言中,单词之间天然使用空格(Whitespace)作为边界。wordcloud 的默认处理逻辑是直接按空格切分字符串并统计频次。然而现代汉语为连续书写,词与词之间没有空格。如果直接把一段中文传入 wordcloud.generate(text),算法会将整句话视为一个超长词汇,最终导致词云中仅有零星几个长句,无法展示高频词。
二、结合 jieba 分词的标准操作步骤与完整代码
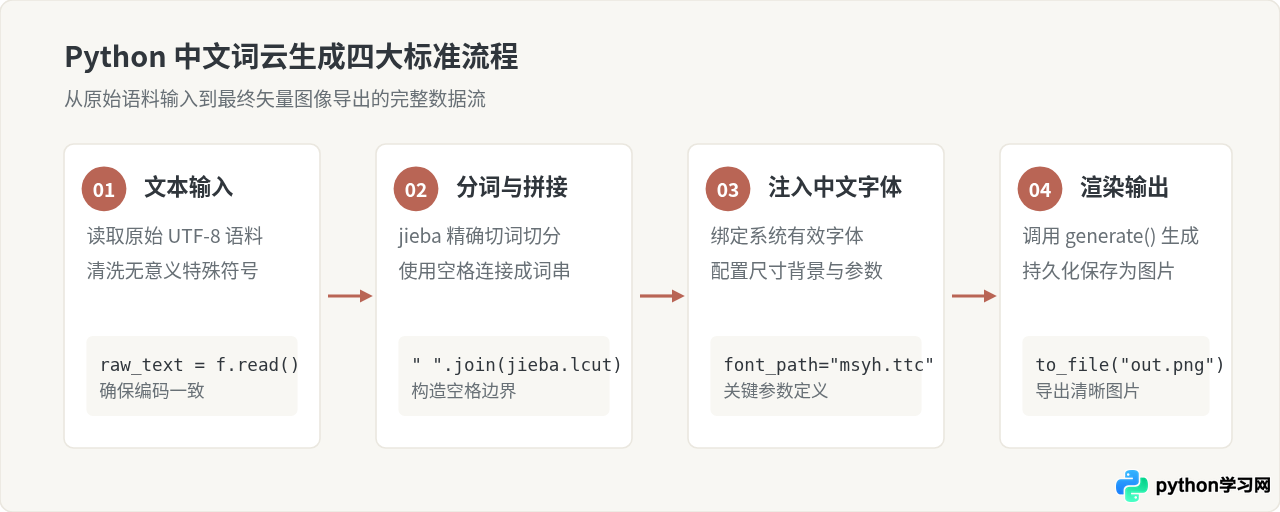
解决上述问题的完整流程由准备语料、结巴分词、构建词云对象以及渲染保存四个核心阶段组成。
1. 依赖库安装
在开始编写代码前,需确保安装了核心依赖:
pip install wordcloud jieba matplotlib pillow2. 完整可执行代码示例
下面是一个经过模块化设计的完整脚本示例。代码中包含中文字体自动探测与异常回退机制:
import os
import jieba
from wordcloud import WordCloud
import matplotlib.pyplot as plt

def get_system_chinese_font():
    """按平台探测可用中文字体路径,若找不到则返回 None"""
    candidates = [
        # Windows
        r"C:\Windows\Fonts\msyh.ttc",
        r"C:\Windows\Fonts\simhei.ttf",
        r"C:\Windows\Fonts\simsun.ttc",
        # macOS
        "/System/Library/Fonts/PingFang.ttc",
        "/Library/Fonts/Songti.ttc",
        "/System/Library/Fonts/STHeiti Light.ttc",
        # Linux
        "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc",
        "/usr/share/fonts/truetype/wqy/wqy-microhei.ttc"
    ]
    for path in candidates:
        if os.path.exists(path):
            return path
    return None

def generate_chinese_wordcloud(text, output_image_path="wordcloud.png"):
    # 步骤一:使用 jieba 进行分词
    # jieba.lcut 返回切分后的词语列表
    words = jieba.lcut(text)

    # 步骤二:清洗短词与单字标点,并用空格拼接
    # 过滤掉长度小于2的单字或标点符号,保留具有实义的名词/动词
    filtered_words = [w.strip() for w in words if len(w.strip()) > 1]
    processed_text = " ".join(filtered_words)

    # 步骤三:获取系统中的中文字体路径
    font_path = get_system_chinese_font()
    if not font_path:
        raise FileNotFoundError(
            "未检测到系统默认中文字体,请下载 .ttf/.ttc 字体文件并显式指定 font_path。"
        )

    # 步骤四:初始化 WordCloud 并传入 font_path
    wc = WordCloud(
        font_path=font_path,          # 关键参数:消除方框乱码
        width=1200,                   # 输出图片宽度(像素)
        height=800,                   # 输出图片高度(像素)
        background_color="white",     # 画布背景颜色
        max_words=100,                # 词云最大展示词数
        collocations=False            # 禁用双词搭配统计,避免jieba词汇重复拼接
    )

    # 步骤五:生成与导出
    wc.generate(processed_text)
    wc.to_file(output_image_path)
    print(f"词云生成成功,已保存至: {output_image_path}")

if __name__ == "__main__":
    sample_text = """
    Python是一种广泛使用的解释型高级编程语言。它由吉多·范罗苏姆设计,并于1991年首次公开发布。
    Python的设计哲学强调代码的可读性与简洁的语法。相比于C++或Java,Python让开发者能够用更少的代码行表达概念。
    jieba中文分词是Python生态中广泛使用的中文自然语言处理组件,拥有精确模式、全模式及搜索引擎模式三种切分方案。
    词云是对文本中词汇出现频次的可视化呈现,通过字体大小直观映射词频高低,广泛应用于数据分析、舆情监控与报告展示。
    """
    generate_chinese_wordcloud(sample_text)
三、主流操作系统中文字体路径速查与调用规范
许多开发者在配置 font_path 时依然遇到 OSError: cannot open resource 报错。该错误表示给定的字体文件路径不存在或 Python 进程无权读取。不同操作系统下的字体存放目录与命名格式存在显著差异。
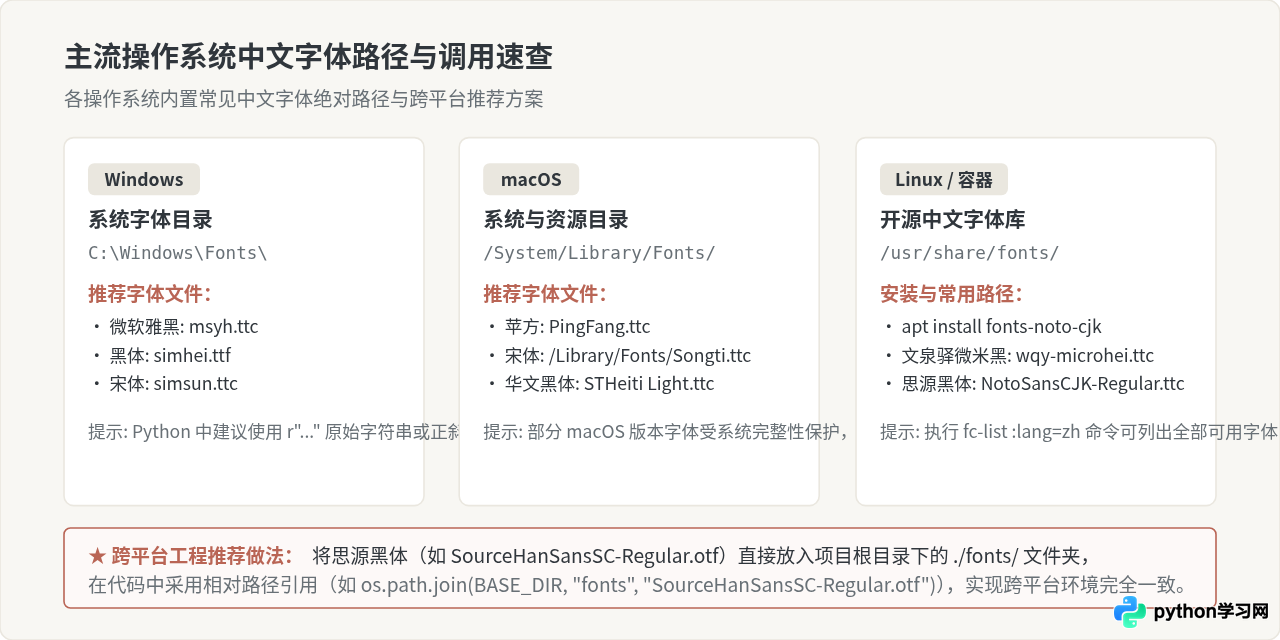
| 操作系统 | 常用中文字体名称 | 推荐绝对路径写法 | 调用注意事项 |
|---|---|---|---|
| Windows 10/11 | 微软雅黑 (Microsoft YaHei) | r"C:\Windows\Fonts\msyh.ttc" 或 "C:/Windows/Fonts/msyh.ttc" |
避免写成 "C:\Windows\Fonts\...",反斜杠 \F 可能触发字符串转义错误。 |
| Windows 10/11 | 黑体 (SimHei) | "C:/Windows/Fonts/simhei.ttf" |
经典无衬线体,对各版本兼容性极佳。 |
| macOS | 苹方 (PingFang SC) | "/System/Library/Fonts/PingFang.ttc" |
字体合集文件,在 macOS Mojave 以上系统默认可用。 |
| macOS | 宋体 (Songti SC) | "/Library/Fonts/Songti.ttc" |
衬线风格字体,适合正式、文学类词云排版。 |
| Ubuntu / Debian | 思源黑体 (Noto Sans CJK) | "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc" |
服务器环境通常未安装中文字体,需预先运行 apt-get install -y fonts-noto-cjk。 |
四、关键细节优化:停用词过滤与 collocations 参数控制
解决乱码和分词后,词云的效果往往还会受到“词频干扰项”和“重复拼接词”的影响。要生成干净、具有明确信息密度的词云,以下两项配置至关重要:
1. 剔除停用词(Stopwords)
在中文语料中,“的、了、在、是、我、我们、以及、并且”等虚词通常出现频率极高。如果不加处理,这些词将占据词云正中央的最显眼位置。wordcloud 自带的停用词库是英文的(如 a, the, of 等),对中文无任何过滤作用。因此必须自定义停用词集合:
# 自定义中文停用词集合
custom_stopwords = {
    "我们", "他们", "这个", "那个", "因为", "所以", "如果", "虽然",
    "但是", "通过", "进行", "可以", "以及", "并且", "根据", "等等"
}

# 可以在列表推导式中直接过滤,也可传入 WordCloud 的 stopwords 参数
cleaned_words = [w for w in jieba.lcut(raw_text) if w not in custom_stopwords and len(w.strip()) > 1]
text_for_wc = " ".join(cleaned_words)
2. 关闭双词搭配参数 collocations
WordCloud 类默认启用了 collocations=True 参数。该参数原本用于英文中识别类似“New York”、“Machine Learning”的双词搭配。但在经过 jieba 处理后的中文文本中,这一选项极易引发意外的二次重复组合,例如把已经分好的“数据”、“分析”强行合并显示为“数据 分析”,造成画面冗余。在制作中文词云时,务必显式设置 collocations=False。
五、全链路排查自检清单与常见故障排除
如果在执行后依然遇到异常,可以按照以下诊断树逐一核验:
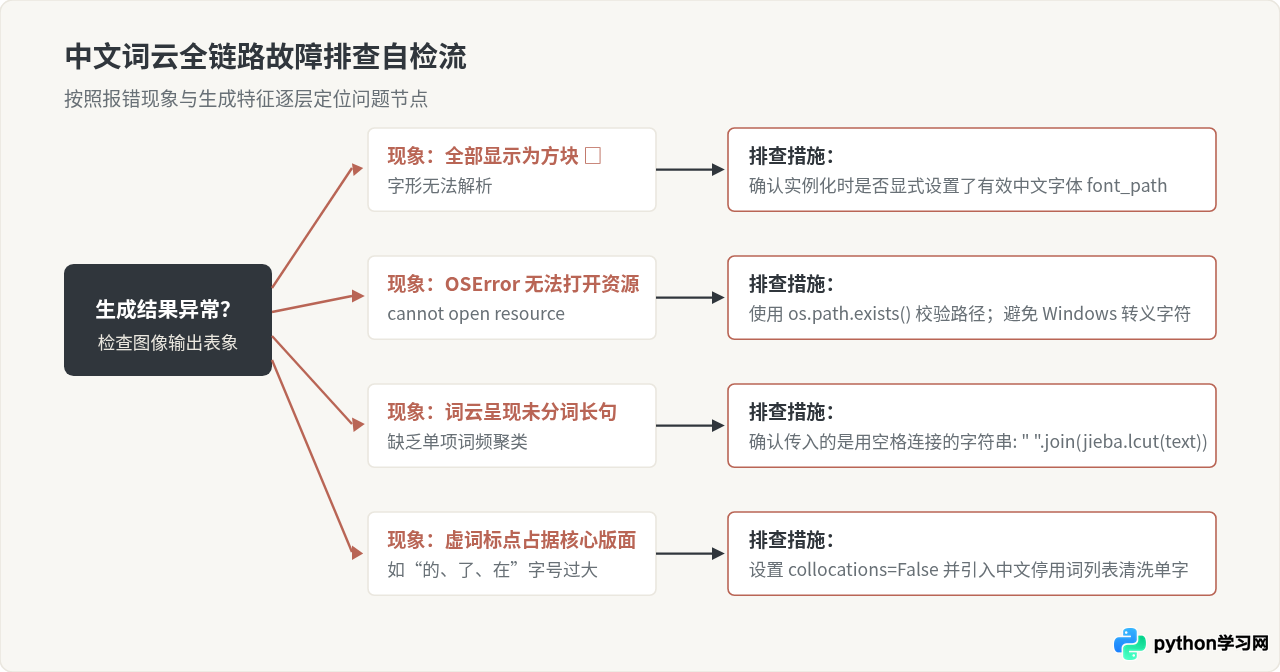
只要严格遵循两个核心原则:“输入前用 jieba 切词并用空格拼接”与“实例化 WordCloud 时显式指定可访问的中文字体路径”,即可彻底杜绝乱码与排版异常。在大型项目或 Docker 生产部署中,最稳健的做法是将中文字体文件固化在代码仓库内,利用相对路径加载,避免因宿主机操作系统差异产生环境依赖问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









