

python定义函数后下一步该学什么
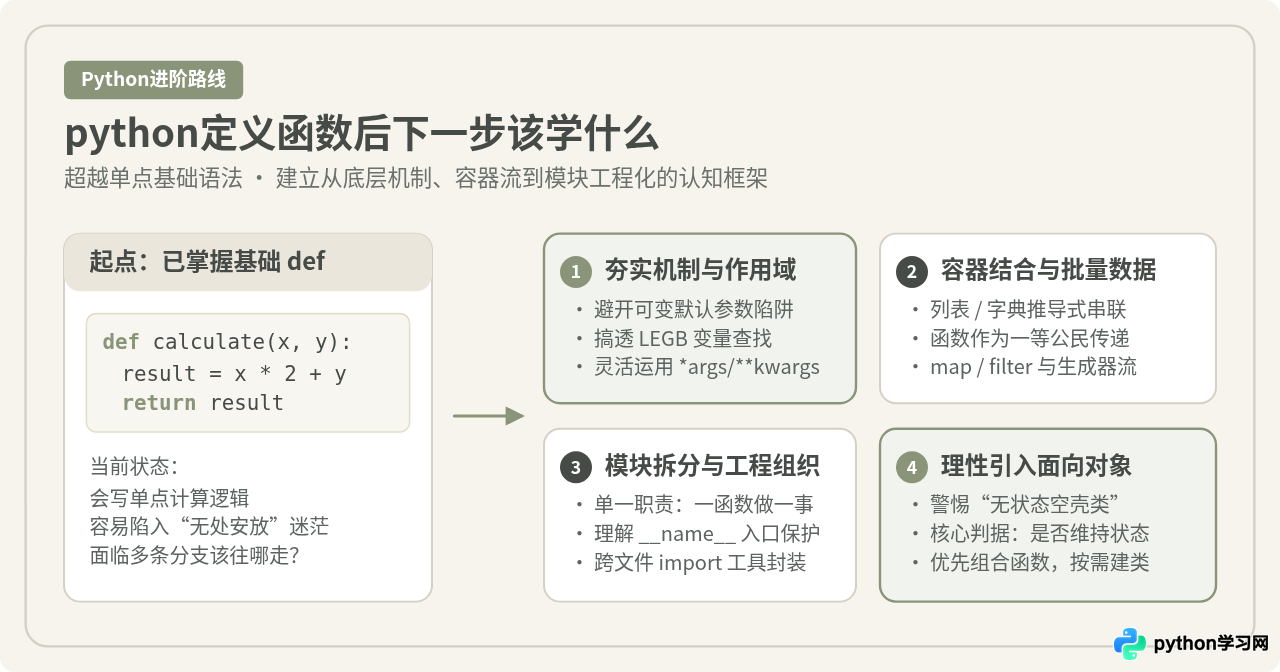
在Python中学会用def定义函数后,下一步应该学什么?本文详细梳理从单点语法到工程化落地的清晰路径:深入函数底层机制与作用域、结合容器与推导式处理批量数据、多文件模块化拆分,以及何时理性引入面向对象。
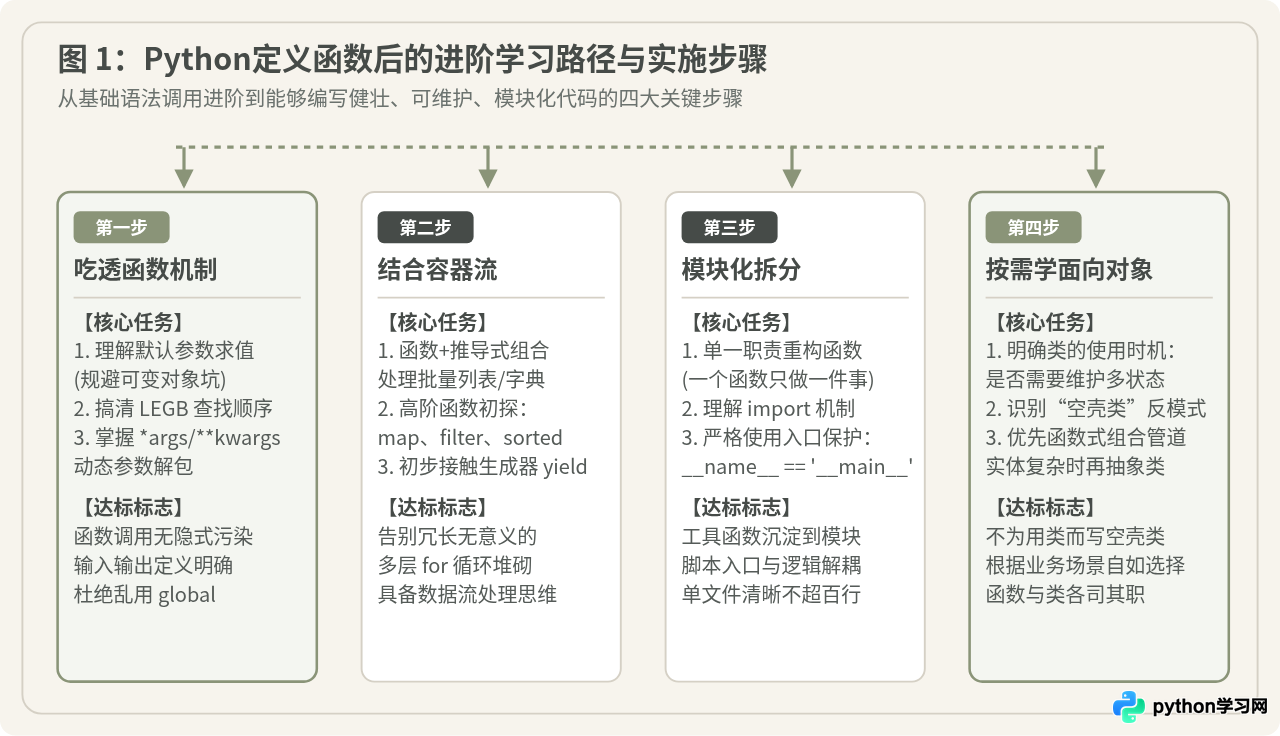
def 声明、参数传递与 return 返回值时,最合理的下一步不是盲目啃面向对象(类),也不是跳跃到复杂的外部框架。最直接且实用的学习路径,是先吃透函数本身的隐性机制(规避默认参数陷阱与理清作用域),再学会让函数驱动列表与字典推导式,随后通过多文件拆分与 if __name__ == '__main__': 建立模块化工程思维,最终根据业务是否具备“持续变化的内部状态”理性决定何时引入类。
一、为什么刚学完定义函数容易迷茫?
在 Python 基础语法的学习过程中,定义函数是一个分水岭。在学习函数之前,初学者写的代码通常是自上而下顺次执行的单行指令或简易循环;一旦学会了 def calculate():,代码第一次具备了“封装”和“复用”的属性。
然而,许多人在写出几个简单的加减乘除函数后,常常面临断档感:写小练习觉得函数可有可无,直接写进主程序好像也跑得通;翻看进阶教程,有人催促立刻学习面向对象的 class 与 self,有人建议直接上手数据爬虫或做网站。这种困惑的核心原因在于:能写出 def 仅仅代表掌握了语言层面的字面语法,而没有建立如何用函数组织数据流动、拆分业务职责的实际能力。
要跨过这道坎,必须按照合理的知识梯度,分阶段完成从“单个函数写法”到“函数间协同组织”的演进。
二、第一步:补齐函数本身的隐性盲区(底层机制与避坑)
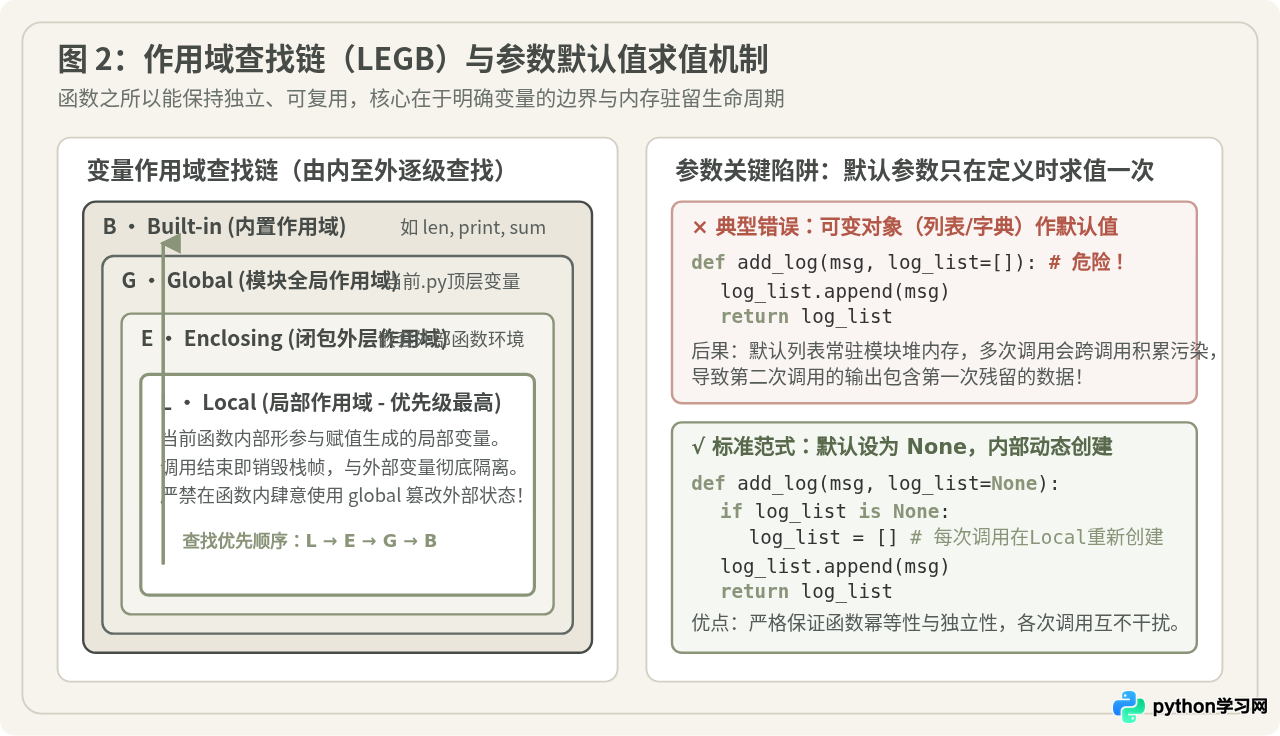
在急于向外扩展之前,首先需要彻底夯实函数本身的运行规律。初学者最容易在两个隐性机制上栽跟头:作用域查找和默认参数的求值时机。
1. 深入理解 LEGB 作用域与命名空间
函数之所以能被称为“黑盒”,是因为它拥有独立的局部命名空间(Local)。在函数内创建的变量只在该次函数调用栈中存在,调用结束就会自动释放。Python 查找变量时,遵循由内向外的 LEGB 原则:
- L (Local):当前函数内部的局部作用域;
- E (Enclosing):嵌套函数的外层闭包环境;
- G (Global):当前
.py脚本模块顶层的全局作用域; - B (Built-in):Python 预设的内置函数与对象(如
len、range、print)。
核心注意事项:初学者如果想在函数内修改外部变量,常会图省事直接使用 global x。这是一种典型的坏味道。滥用 global 会破坏函数的独立封装性,导致代码在多个函数之间产生不可预测的隐式相互依赖。正规的做法永远是:通过形参把数据传进来,通过 return 把计算结果返回去。
2. 避开可变对象作为默认参数的“深坑”
这是 Python 初学者乃至部分初级开发者最容易遭遇的隐蔽 Bug。请看下面的例子:
# 错误示范:使用可变列表作为默认参数
def record_log(message, logs=[]):
    logs.append(message)
    return logs

# 连续两次调用
print(record_log("用户登录"))
print(record_log("点击按钮"))['用户登录', '点击按钮']
第二次调用本应只包含“点击按钮”,为什么却把上次的结果也带了出来?原因在于:Python 中的默认参数只在模块被加载定义时求值一次,而不是每次调用函数时重新求值。列表 [] 是一个可变对象,所有未显式传参的调用都会共享内存中的同一个列表引用。
标准规范写法:将默认参数设为不可变的 None,在函数体内部通过判断动态新建对象:
# 正确示范:使用 None 作为占位符
def record_log(message, logs=None):
    if logs is None:
        logs = []  # 每次进入局部作用域独立创建新列表
    logs.append(message)
    return logs
3. 掌握动态参数解包:*args 与 **kwargs
学完基础定长参数后,必须掌握不定长参数:*args 将多余的位置参数打包为元组,**kwargs 将多余的关键字参数打包为字典。这项技能是后续编写通用装饰器、中间件或封装系统 API 时的核心基石。
三、第二步:让函数学会处理真实数据(结合容器与推导式)
在实际工作中,很少有函数只用来计算 1 + 1 = 2。函数最广泛的用途,是作为**数据转换器(Transformer)**,批量清洗和过滤来自列表、字典或文件的数据。
在这个阶段,不要再用四五层嵌套的 for 循环并在里面手动 list.append(),而应该学习把函数与**列表推导式(List Comprehension)**或**字典推导式**配合使用。
# 定义专门清洗单条用户信息的独立函数
def clean_user_data(raw_record):
    # 剥离前后空白、格式化年龄与邮箱
    return {
        "username": raw_record.get("name", "").strip().lower(),
        "is_adult": raw_record.get("age", 0) >= 18,
        "valid": bool(raw_record.get("email"))
    }

raw_users = [
    {"name": " Alice ", "age": 22, "email": "alice@example.com"},
    {"name": "BOB", "age": 16, "email": ""},
    {"name": " Charlie", "age": 30, "email": "c@test.com"}
]

# 将单点函数与列表推导式优雅结合,完成批量流水线处理
cleaned_users = [clean_user_data(user) for user in raw_users]
adult_users = [u for u in cleaned_users if u["is_adult"] and u["valid"]]

print(f"有效成年用户数: {len(adult_users)}")
在这个范式中,clean_user_data 只聚焦于单条数据的规则处理,推导式负责迭代调度。两者分工明确,不仅极易阅读,而且后续如果清洗规则改变,只需修改单个函数,业务主循环完全不受影响。
四、第三步:从单脚本走向多函数与模块化(职责与分工)
初学者写代码常有“把所有东西写进一个脚本”的习惯:几百行代码里,变量定义、数据爬取、计算逻辑、文件保存混杂在一起。一旦代码超过 100 行,排查问题就变得极为痛苦。
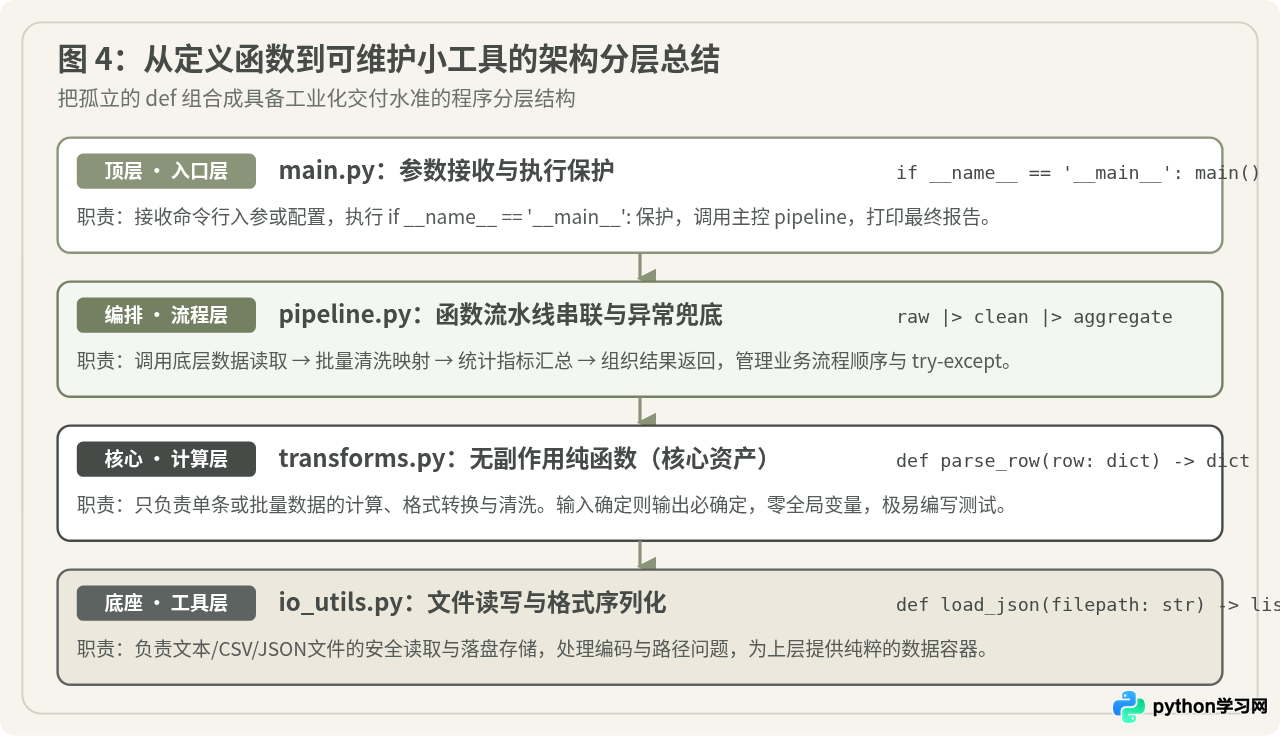
定义函数后的关键一步,就是建立模块化组织意识。具体落地到三个行动:
- 单一职责原则(Single Responsibility):一个函数只做一件事。如果一个函数既负责从本地读 CSV,又负责清洗计算,还负责把结果打印成图表,就必须拆成
read_data()、process_data()和export_report()。 - 掌握入口保护
if __name__ == '__main__'::理解每个 Python 文件既可以作为脚本独立执行,也可以作为模块被其他文件import。加入入口保护,能确保当别的脚本导入你的通用函数时,不会意外触发原本用于测试的执行代码。 - 多文件组织:在同一目录下创建
utils.py(存放通用的清洗函数或数学计算),在主业务脚本main.py中使用from utils import clean_user_data引用。真正体验“把公共逻辑沉淀为工具库”的成就感。
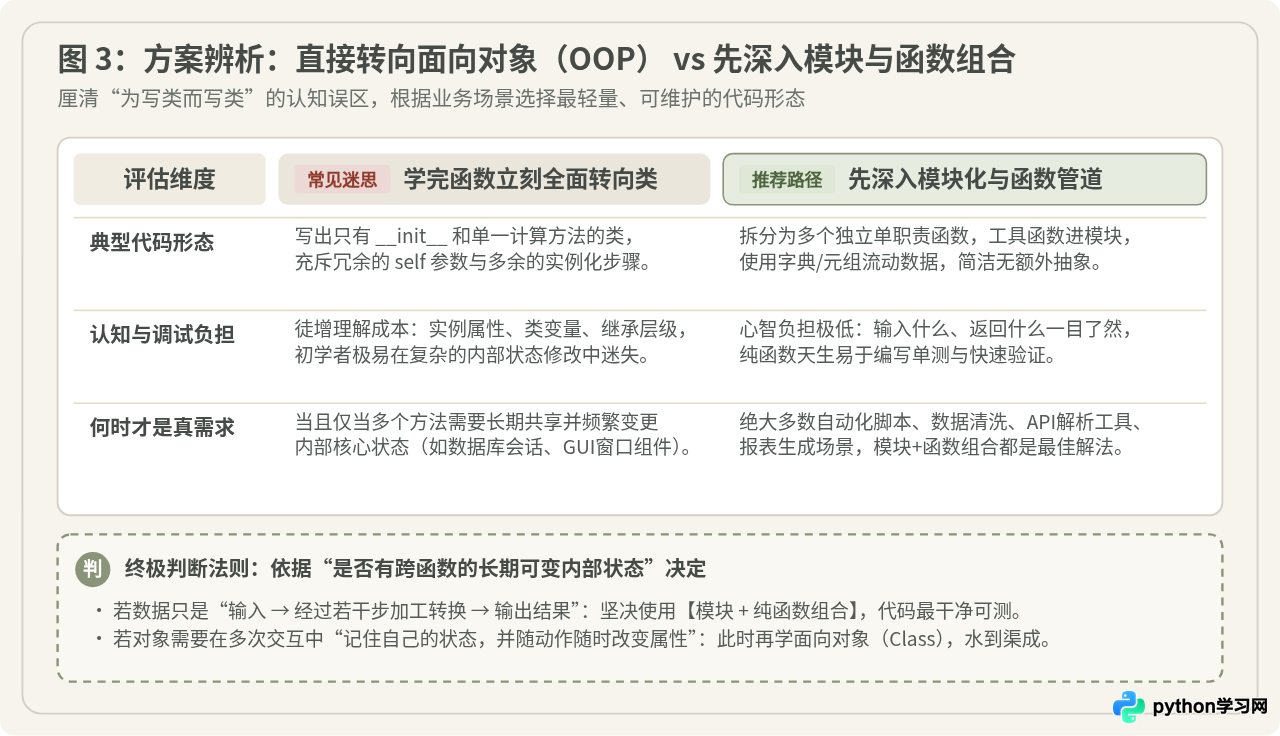
五、常见迷思辨析:刚学完函数,要不要立刻去学面向对象(类)?
许多教材在讲完 def 后,紧接着就是 class、__init__、self、继承与多态。这导致很多初学者误以为“函数只是初级的过渡玩具,面向对象才是高级程序员的标配”。
这种说法看似合理,因为在 Java、C++ 等经典语言中,类是唯一的代码容器。但在 Python 这种多范式语言中,过早、强行使用类,不仅不会提高代码质量,反而会滋生大量无意义的“空壳类”反模式。
初学者在强行写类时,常常写出类似下面的代码:
# 反模式:没有任何内部状态,强行套用类外壳
class TextProcessor:
    def __init__(self):
        pass

    def clean_text(self, text):
        return text.strip().lower()

# 每次调用还要被迫实例化
processor = TextProcessor()
res = processor.clean_text(" Hello World ")
这个类既没有维护任何跨方法的持久化属性,也没有体现任何继承价值,完全是一个被多余的 self 裹挟的空架子。一个简单的纯函数 def clean_text(text): return text.strip().lower() 比它清晰轻快十倍。
那么,到底什么时候才真正需要学类?
- 不需要类的场景:流水线式的数据清洗、脚本自动化、报表统计。这类任务的本质是“输入数据 → 经过一系列步骤计算 → 吐出结果”,使用模块 + 纯函数 + 字典/列表是 Python 中最高效、最易于单元测试的写法。
- 必须引入类的场景:当出现需要跨函数持续保存和变更的状态(Stateful)时。例如:网络爬虫的 Session 会话管理器(需要跨请求保持 Cookie 和重试计数器)、游戏里的角色实体(血量、坐标、装备随时变化)、数据库连接池、图形界面控件等。
六、实战演练:组合多个函数构建一个微型工具
检验是否真正跨过函数关卡的最佳办法,是动手编写一个包含 3~4 个独立函数的小工具。以下示例展示了一个完整的访问日志清洗与统计工具,它演示了函数如何各司其职、协同流水线运转:
# -*- coding: utf-8 -*-
# 运行环境:Python 3.8+ 标准库

def parse_log_line(line: str) -> dict:
    """步骤1:纯函数,负责解析单行字符串为结构化字典"""
    parts = line.strip().split(",")
    if len(parts) < 3:
        return {}
    return {
        "ip": parts[0].strip(),
        "status": int(parts[1].strip()),
        "endpoint": parts[2].strip()
    }

def filter_errors(records: list) -> list:
    """步骤2:过滤出HTTP状态码非200的异常请求"""
    return [r for r in records if r.get("status") and r["status"] != 200]

def count_by_endpoint(records: list) -> dict:
    """步骤3:统计各个接口出现的频次"""
    counts = {}
    for r in records:
        ep = r.get("endpoint", "unknown")
        counts[ep] = counts.get(ep, 0) + 1
    return counts

def main():
    """步骤4:业务主干调度流程"""
    raw_logs = [
        "192.168.1.10, 200, /api/user",
        "192.168.1.11, 404, /api/goods",
        "192.168.1.12, 500, /api/pay",
        "192.168.1.10, 200, /api/goods",
        "192.168.1.13, 500, /api/pay",
        "invalid line data"
    ]

    # 组合调用函数流水线
    parsed = [parse_log_line(line) for line in raw_logs]
    valid_records = [p for p in parsed if p]
    error_records = filter_errors(valid_records)
    error_summary = count_by_endpoint(error_records)

    print(f"总有效日志行数: {len(valid_records)}")
    print(f"发现异常请求数: {len(error_records)}")
    print("异常接口分布详情:")
    for endpoint, freq in error_summary.items():
        print(f"  - {endpoint}: {freq} 次")

if __name__ == "__main__":
main()发现异常请求数: 3
异常接口分布详情:
- /api/goods: 1 次
- /api/pay: 2 次
七、总结与下一步行动清单
学完函数定义,你已经拥有了进入工业化编程的大门钥匙。请按照以下行动清单检验你的进阶节奏:
- 清单 1(机制过关):在写任何带有默认参数的函数时,绝不用
[]或{},一律使用arg=None;函数内部不写global。 - 清单 2(组合过关):将多层冗长的
for循环,改写为“单职责清洗函数 + 列表推导式”的组合模式。 - 清单 3(工程过关):每个脚本都加上
if __name__ == '__main__':;当一个脚本超过两百行时,主动把通用功能抽离进utils.py。 - 清单 4(理性进阶):面对实际业务时,优先尝试用函数管道解决;只有在需要跨方法维护复杂对象状态时,才去开启面向对象的系统学习。
按照这套路径走下去,你写出的代码不仅能跑通,而且层次分明、容易测试、可维护性强,真正完成从“语法初学者”到“合格开发者”的认知跃迁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









