

Python自定义词云形状与配色的实现方法
详细讲解在Python中使用wordcloud库自定义词云图形轮廓与色彩风格的完整实现方法,涵盖掩码图像二值化预处理、中文字体配置、三种主流配色策略以及常见报错排查。
一、基础运行环境与核心组件装配
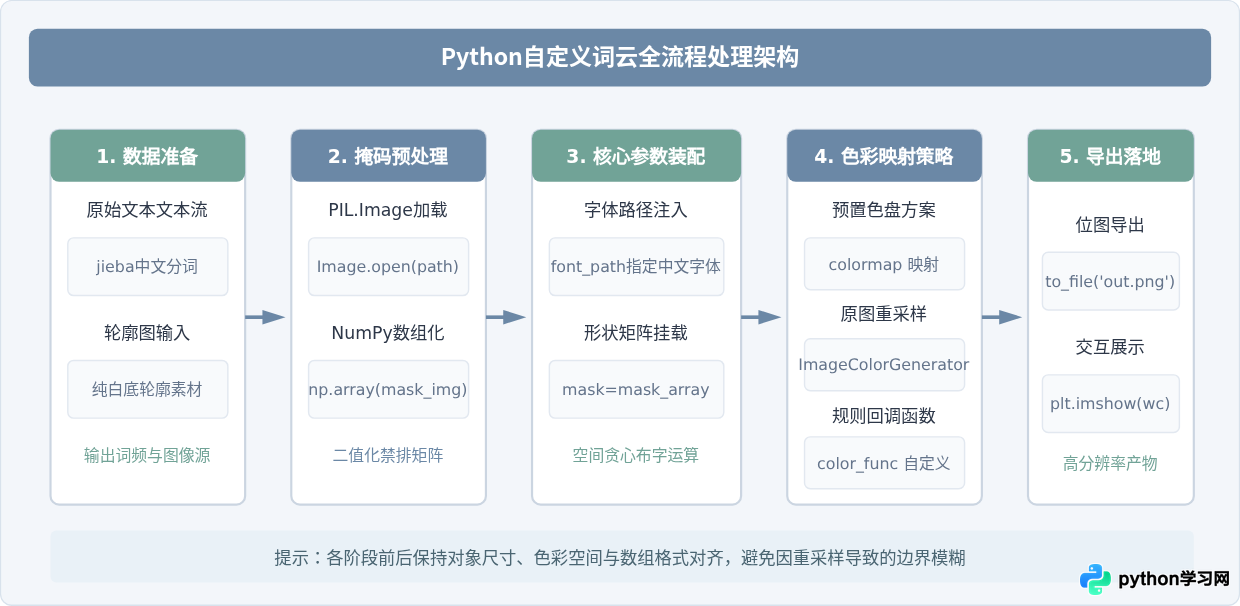
制作具备自定义轮廓与配色的中文词云,通常需要五个核心库协同工作:负责文本分词的jieba、负责图像读取与矩阵转换的Pillow与NumPy、负责词云排版布局的核心库wordcloud,以及用于可视化展示与色彩映射的matplotlib。
各组件在数据流中的分工明确:原始中文语料经分词去停用词后输出词频字典;轮廓图像经数组化后生成像素坐标掩码;词云生成器根据掩码约束词语放置位置;调色模块根据预设规则为每个单词赋予色彩值。
二、自定义形状的实现原理与掩码(Mask)预处理
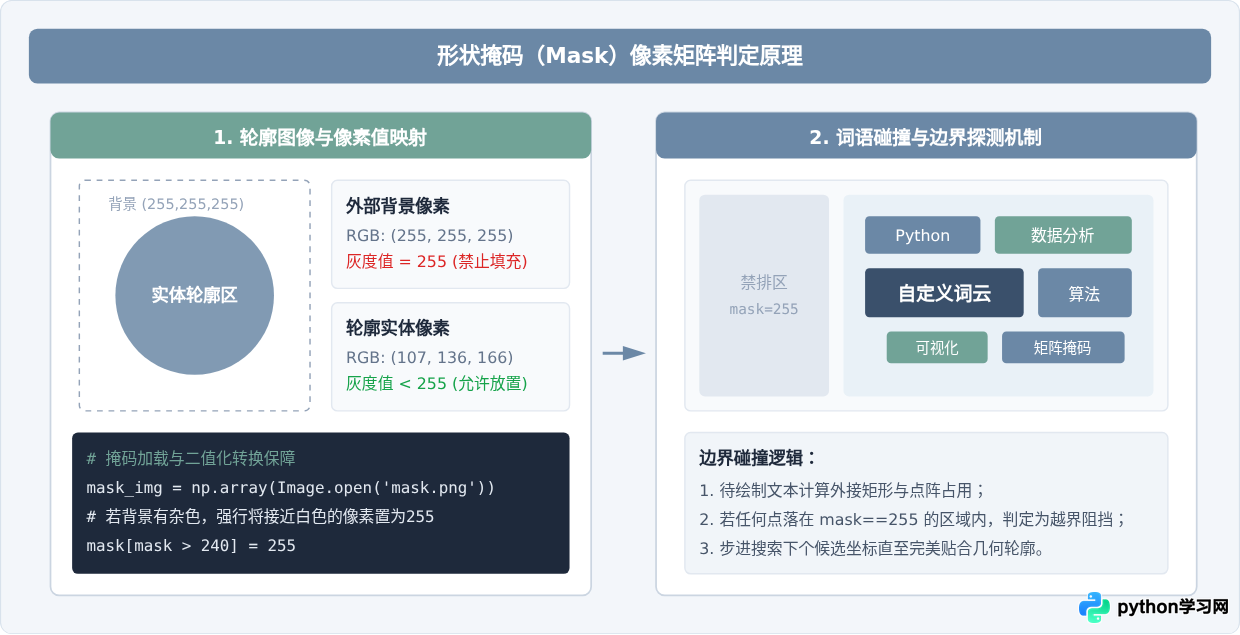
在默认情况下,WordCloud使用简单的矩形画布(由width和height指定)。当传入mask参数时,WordCloud会把该图像对应的NumPy二维数组作为空间占用判定矩阵。
其核心判据非常直接:凡是矩阵中数值为255(对应RGB中的纯白 #FFFFFF)的像素点,均被视为不可放置文字的禁排空白区;而数值小于255的非纯白像素区域,才会被判定为可放置文本的绘制区。
三、中文语料分词与字体映射配置
WordCloud默认使用的是系统英文开源字体(DroidSansFallback等)。若文本中包含中文,直接渲染会出现大量的方框(俗称“豆腐块”□)或问号乱码。这是由于默认字体库中缺乏中文字形点阵数据所致。
解决中文渲染的核心在于明确提供本地系统的中文字体路径给font_path参数。不同操作系统常见的中文字体路径如下:
| 操作系统 | 典型中文字体名称 | 标准物理路径示例 |
|---|---|---|
| Windows | 黑体 (SimHei) / 微软雅黑 | C:\Windows\Fonts\simhei.ttf 或 msyh.ttc |
| macOS | 苹方 (PingFang SC) / 黑体 | /System/Library/Fonts/PingFang.ttc |
| Linux / Ubuntu | 思源黑体 (Noto Sans CJK) / 文泉驿 | /usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc |
中文文本的另一个特殊性在于词语之间没有空格分隔,因此在交给WordCloud之前,必须先使用jieba.cut()进行中文分词,过滤无实际语义的停用词(如“的”、“了”、“在”等),再以空格重新拼接成合规语料字符串,或直接统计为词频字典传入generate_from_frequencies()。
四、自定义配色的三种实现策略
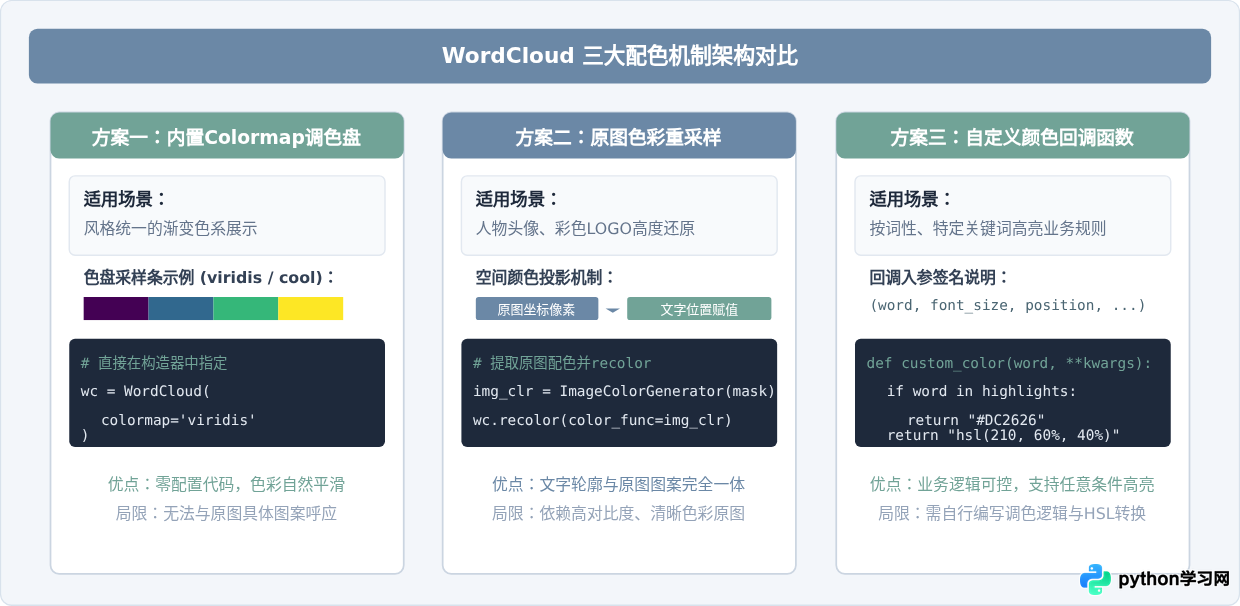
在WordCloud中,自定义色彩不仅关乎视觉美观,更直接体现信息层级。常见的实现策略有三种:基于Matplotlib调色板(Colormap)、基于原图采样的ImageColorGenerator,以及高度自主的自定义颜色回调函数。
1. 使用Matplotlib内置Colormap
这是最轻量的自定义配色方式。WordCloud接收所有Matplotlib支持的色彩映射名称,例如冷色调的'Blues'、现代质感的'viridis'、科技感十足的'plasma'或清爽的'ocean'。
wc = WordCloud(
    font_path='simhei.ttf',
    mask=mask_array,
    background_color='white',
    colormap='viridis'  # 替换默认随机配色
)
2. 使用原图色彩重采样(ImageColorGenerator)
如果希望词云完全还原输入形状图片本身的色彩分布(例如让词云拼成一个彩色的苹果LOGO或公司彩色标识),使用ImageColorGenerator是最佳解法。该生成器会计算词语在画布上的几何中心坐标,并在原图对应像素位置抽取主色,将其作为该词语的前景色。
from wordcloud import ImageColorGenerator

# 基于原始mask图生成色彩生成器
image_colors = ImageColorGenerator(mask_array)

# 生成基础词云后,使用原图颜色重绘
wc.generate(text_corpus)
wc.recolor(color_func=image_colors)
3. 编写自定义规则的颜色回调函数(color_func)
当需要突出某些特定重点词汇(例如将包含“核心”、“优势”等词汇设为醒目的红色或金色,其余词汇保持冷灰),可以自定义回调函数并将其传递给recolor()或直接赋给初始化参数color_func。
颜色函数可以返回十六进制RGB字符串(如"#E53E3E")、CSS颜色名称(如"navy"),或标准HSL格式字符串(如"hsl(210, 80%, 50%)")。
import random

def my_color_func(word, font_size, position, orientation, random_state=None, **kwargs):
    # 特定核心重点词汇指定强调色
    highlight_words = {"Python", "数据分析", "机器学习"}
    if word in highlight_words:
        return "#E53E3E"  # 红色强调

    # 其余词汇在主色调区间内随机浮动亮度和饱和度
    # HSL: 色相(Hue)=210(沉稳蓝), 饱和度(Saturation)=40%~70%, 亮度(Lightness)=30%~60%
    h = 210
    s = random.randint(40, 70)
    l = random.randint(30, 60)
    return f"hsl({h}, {s}%, {l}%)"

# 应用自定义颜色函数
wc.recolor(color_func=my_color_func)
五、完整工程可执行代码示例
下面给出一段整合了中文分词、掩码图像二值化清洗、中文字体加载及原图色彩重采样的完整Python脚本,可以直接执行并生成高质量词云图片:
import os
import jieba
import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
from wordcloud import WordCloud, ImageColorGenerator

def generate_custom_wordcloud(
    corpus_text: str,
    mask_image_path: str,
    font_path: str,
    output_image_path: str = "custom_wordcloud.png",
    use_image_color: bool = True
):
    # 1. 验证必要文件是否存在
    if not os.path.exists(mask_image_path):
        raise FileNotFoundError(f"未找到形状掩码图像: {mask_image_path}")
    if not os.path.exists(font_path):
        raise FileNotFoundError(f"未找到中文字体文件: {font_path}")

    # 2. 中文分词与停用词清洗
    words = jieba.cut(corpus_text)
    stop_words = {"我们", "他们", "可以", "以及", "通过", "进行", "一个", "对于", "由于"}
    filtered_words = [w for w in words if len(w) > 1 and w not in stop_words]
    clean_text = " ".join(filtered_words)

    # 3. 掩码图像加载与二值化稳健处理
    raw_image = Image.open(mask_image_path).convert("RGB")
    mask_array = np.array(raw_image)

    # 容差清洗:防止由于JPG压缩伪影导致背景存在微弱杂色
    # 凡是各通道像素均高于245的区域,强行置为纯白255
    mask_array[mask_array > 245] = 255

    # 4. 初始化WordCloud对象
    wc = WordCloud(
        font_path=font_path,
        background_color="white",  # 画布背景色(可设为None并指定mode='RGBA'获得透明背景)
        mask=mask_array,
        max_words=300,
        max_font_size=120,
        min_font_size=10,
        random_state=42,
        scale=2  # scale=2提升清晰度,使导出位图不失真
    )

    # 5. 生成词云布局
    wc.generate(clean_text)

    # 6. 色彩方案应用
    if use_image_color:
        image_colors = ImageColorGenerator(mask_array)
        wc.recolor(color_func=image_colors)

    # 7. 导出保存结果
    wc.to_file(output_image_path)
    print(f"词云生成成功,已导出至: {output_image_path}")

    return wc

# 示例调用
if __name__ == "__main__":
    sample_text = """
    Python作为一门通用编程语言,在数据分析、机器学习、网页爬虫、自然语言处理和数据可视化领域有着广泛的应用。
    通过使用Jieba分词和WordCloud库,开发者可以快速对非结构化文本进行关键词抽取与词频统计。
    自定义掩码形状和原图配色能够极大地增强词云的视觉冲击力与信息表达效率。
    """

    # 执行生成
    # 请根据实际环境将 'mask.png' 和 'simhei.ttf' 替换为你的真实本地路径
    # generate_custom_wordcloud(
    #     corpus_text=sample_text,
    #     mask_image_path="mask.png",
    #     font_path="simhei.ttf"
    # )
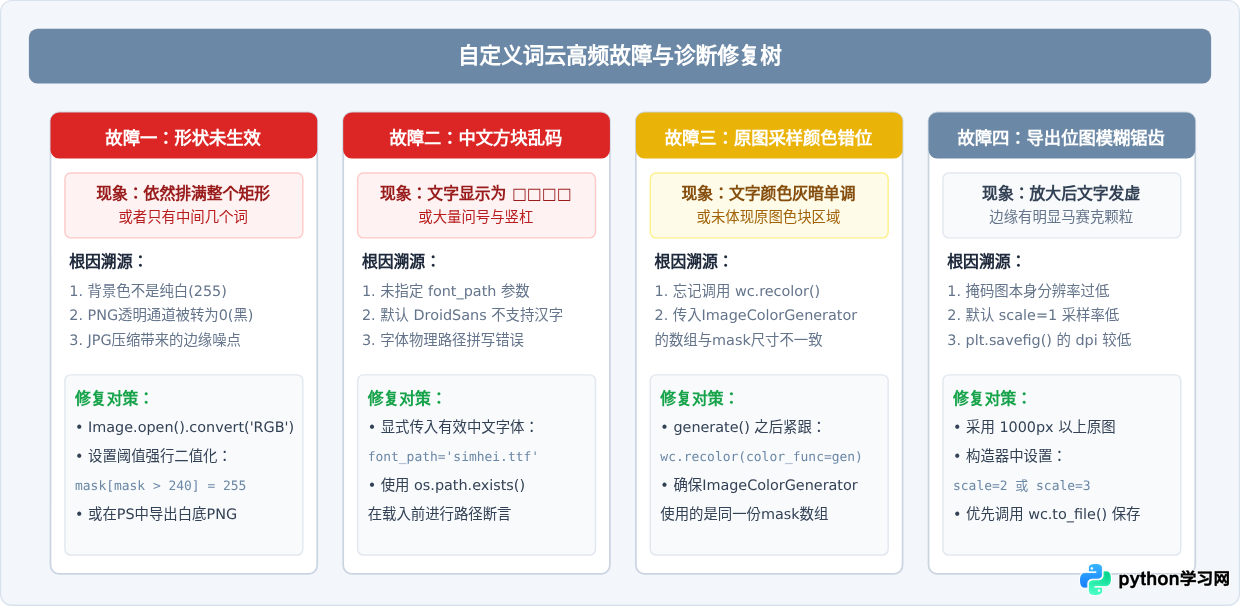
六、高频故障与边缘问题排查指南
在实际落地自定义词云项目时,开发者常遇到形状未按预期轮廓收紧、中文字体显示异常或导出边缘锯齿等问题。遵循以下排查流程即可精确定位并解决:
七、总结
掌握Python词云的自定义开发,本质上是理清“掩码数据矩阵”与“空间渲染策略”的对应关系。通过将形状图像标准化为以255为禁排区的NumPy矩阵,即可精准控制词云的外轮廓;通过绑定中文字体解决了字符编码与渲染乱码问题;再配合Colormap、ImageColorGenerator或回调函数,便能在形状与色彩两个维度上完全摆脱默认模版的限制,产出兼具信息密度与视觉吸引力的高质量词云可视化成果。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









