

解决Python wordcloud报错:字体找不到(OSError)与编码问题
针对Python使用wordcloud库生成词云时常见的OSError字体找不到、中文字符显示方块乱码以及文本编码报错问题,本文提供从错误成因到系统字体排查、代码配置及中文分词的完整解决方案。
在使用 Python 的 wordcloud 库生成中文词云时,开发者最常遇到的两个阻碍是:控制台抛出 OSError: cannot open resource 导致程序中断,或者生成的图片中所有汉字都变成方块豆腐块(口口);而在读取文本时,还经常遇到 UnicodeDecodeError 异常。这三个问题本质上分别对应字体路径失效、字体缺乏中文字形以及文本编码不匹配。本文将针对这些具体报错展开成因分析,并给出跨平台系统字体路径配置、独立字体打包及中文分词的一体化解决方案。
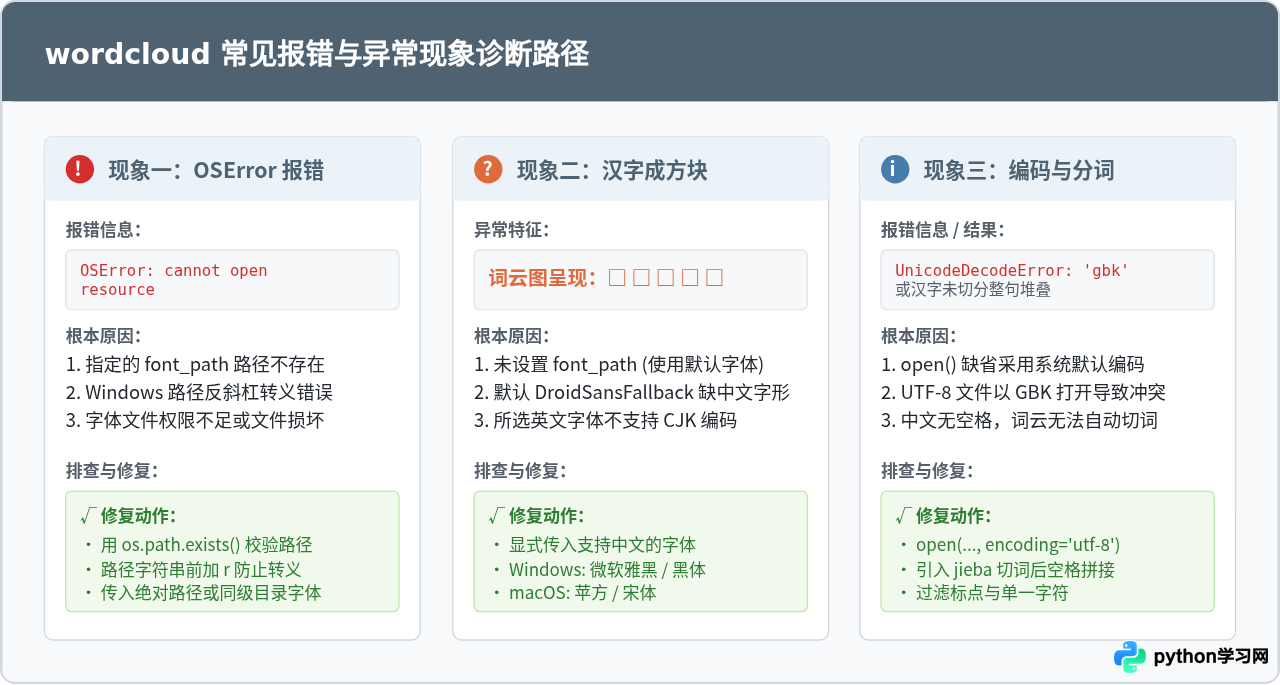
一、现象识别:区分“字体找不到”与“中文字体缺失”
在调试词云生成代码时,第一步是根据终端输出与图片结果,准确区分底层错误类型。许多初学者将“文字显示为方块”误认为是系统报错,或者把 OSError 归咎于第三方依赖缺失,导致排查方向偏离。
1. 报错一:OSError: cannot open resource
当执行 WordCloud(font_path='...').generate(text) 时,控制台打印出如下 Traceback:
Traceback (most recent call last):
  File "generate_cloud.py", line 12, in <module>
    wc.generate(text)
  File "site-packages/wordcloud/wordcloud.py", line 639, in generate
    return self.generate_from_text(text)
  ...
  File "site-packages/PIL/ImageFont.py", line 852, in truetype
    return freetype(font)
OSError: cannot open resource
这个错误由底层图像库 PIL (Pillow) 抛出。它意味着 PIL 在尝试加载 font_path 参数对应的字体文件时发生致命故障。最常见的原因是给定的路径在文件系统中根本不存在、文件名拼写错误,或者在 Windows 系统中使用了包含未转义反斜杠的字符串(例如 "C:\Users\test\font.ttf" 中的 \t 会被解析为制表符)。
2. 现象二:程序正常结束,但生成的词云全为方形“豆腐块”
代码运行无任何报错,图片也能正常导出,但打开后发现原本的汉字全部变成了空心小方块(“口口”)。
出现这种情况的原因是:WordCloud 类在未指定 font_path 时,默认使用内置的 DroidSansMono.ttf 字体。该字体是纯西文字体,字库中不包含中文 CJK(中日韩统一表意文字)字符集的字形映射。当渲染引擎尝试绘制中文字符时,找不到对应的字形轮廓,只能使用字体内的“缺少字符替代符号”(通常表现为方块或问号)进行填充。
3. 报错三:UnicodeDecodeError 文本解码失败
在从外部文本文件(如 article.txt)读取数据并喂给分词器时,控制台抛出编码异常:
UnicodeDecodeError: 'gbk' codec can't decode byte 0xaa in position 14: illegal multibyte sequence这是因为 Python 的 open() 函数在未显式传入 encoding 参数时,会默认调用系统当前区域的首选编码(Windows 中文版系统通常为 cp936 即 GBK)。若待处理的文本文件是以目前主流的 UTF-8 编码保存的,就会在读取特定汉字字节序列时发生解码越界崩溃。
二、解决 OSError:正确定位并配置系统字体路径
要彻底解决 OSError: cannot open resource 与汉字豆腐块问题,必须向 WordCloud 构造函数明确提供一个真实存在、具备中文字形且格式合法的字体文件完整路径。
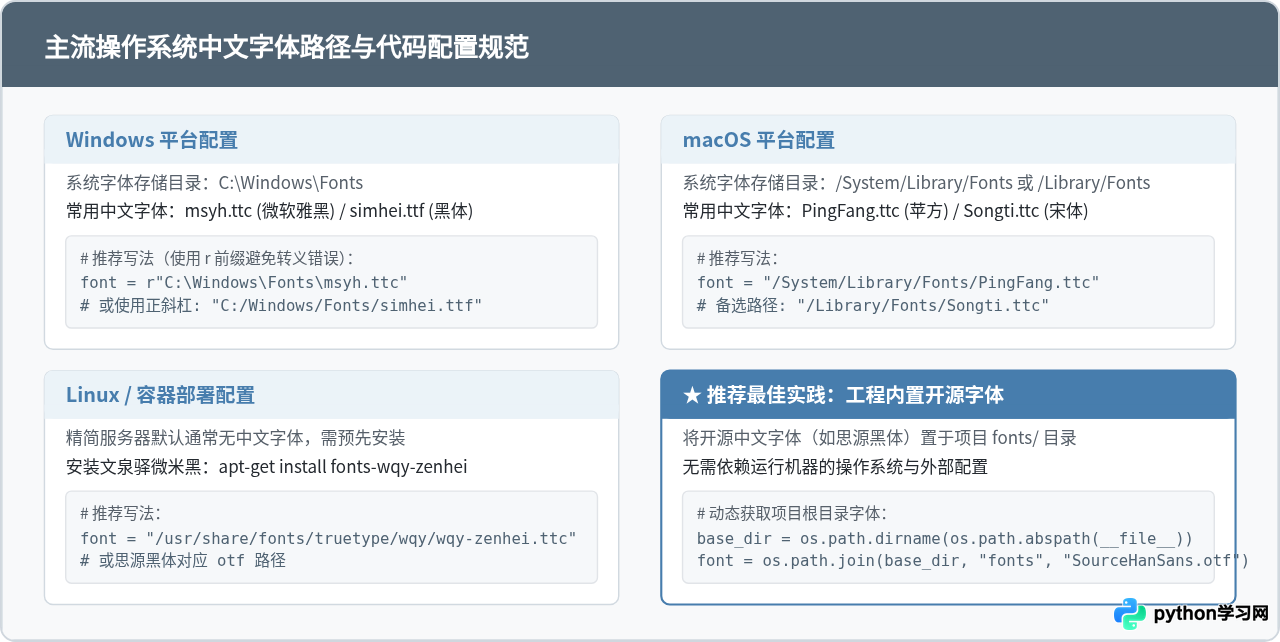
1. 主流系统的内置中文字体路径对照
不同操作系统内置字体的物理存放路径不同。以下为各系统最常用且兼容性良好的中文字体文件清单:
| 操作系统 | 中文字体名称 | 系统实际物理路径 |
|---|---|---|
| Windows | 微软雅黑 (Microsoft YaHei) 黑体 (SimHei) |
C:\Windows\Fonts\msyh.ttcC:\Windows\Fonts\simhei.ttf |
| macOS | 苹方 (PingFang SC) 宋体 (Songti SC) |
/System/Library/Fonts/PingFang.ttc/Library/Fonts/Songti.ttc |
| Linux (Ubuntu/Debian) | 文泉驿微米黑 / 正黑 思源黑体 |
/usr/share/fonts/truetype/wqy/wqy-zenhei.ttc/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc |
注意:Windows 字符串转义陷阱
在 Python 代码中书写 Windows 路径时,若写成 "C:\Windows\Fonts\simhei.ttf",其中的 \f 会被当成换页符,\s 会引发非法转义警告。必须采用以下两种写法之一:
1. 在字符串前加上 r 标识为原始字符串:r"C:\Windows\Fonts\simhei.ttf"
2. 将反斜杠改为正斜杠(Windows API 原生支持正斜杠):"C:/Windows/Fonts/simhei.ttf"
2. 代码级字体路径安全校验
为了避免直接抛出难以直观理解的 OSError: cannot open resource,建议在实例化 WordCloud 前,通过 Python 标准库中的 os.path.exists() 验证字体文件是否存在。如果检测到路径不存在,立即抛出包含清晰指引的错误提示,而不是任由 PIL 在深层调用中崩溃:
import os

font_path = r"C:\Windows\Fonts\msyh.ttc"

if not os.path.exists(font_path):
    raise FileNotFoundError(f"未找到指定的字体文件: {font_path},请核查路径或使用自定义字体。")
三、解决编码与乱码:从文本读取到中文分词
词云库 wordcloud 最初是针对英文等依靠空格天然分词的语言设计的。在处理英文时,输入一整段自然语言,库内部可以直接通过空格和标点将单词剥离出来。但在处理中文时,词语之间连续书写没有空格,如果不进行预先分词,wordcloud 会将整个句子甚至整段话当成一个巨型词条,或者直接无法统计词频。
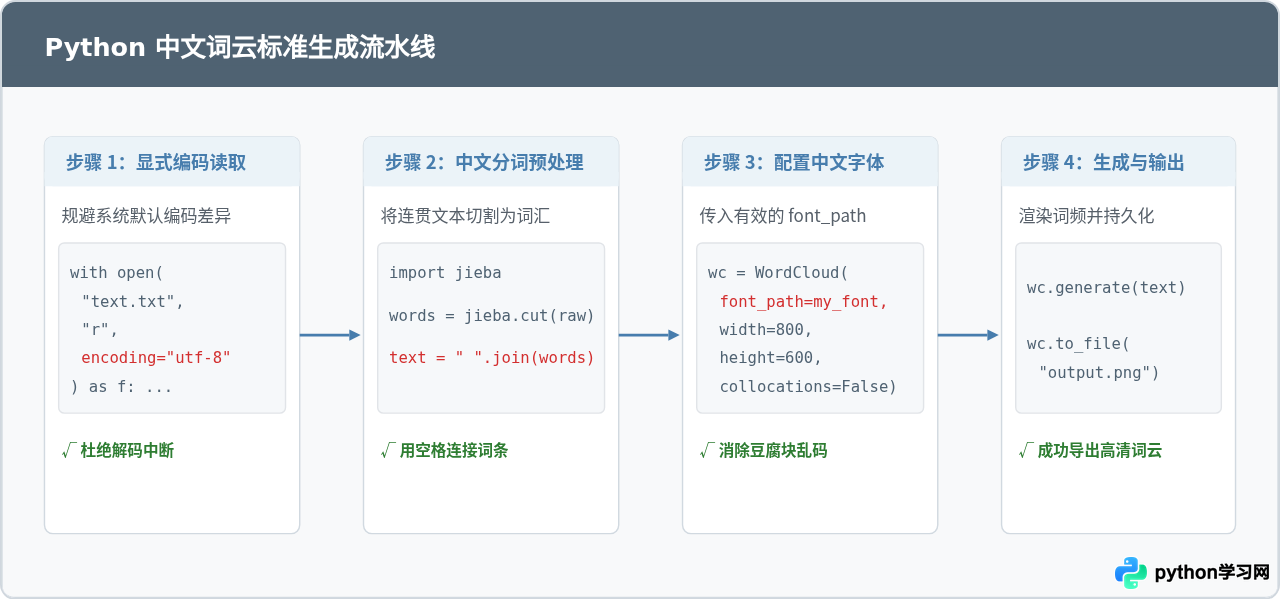
完整、健壮的生产级代码示例
下面是一个经过完整异常处理与路径适配的中文词云生成脚本。它涵盖了文本安全读取、jieba 分词、停用词过滤、跨平台字体自动探测及最终导出:
import os
import sys
import jieba
from wordcloud import WordCloud

def get_system_chinese_font():
    """根据操作系统自动探测可用的中文字体路径"""
    candidate_paths = []

    if sys.platform.startswith("win"):
        candidate_paths = [
            r"C:\Windows\Fonts\msyh.ttc",    # 微软雅黑
            r"C:\Windows\Fonts\simhei.ttf",  # 黑体
            r"C:\Windows\Fonts\simsun.ttc",  # 宋体
        ]
    elif sys.platform.startswith("darwin"):
        candidate_paths = [
            "/System/Library/Fonts/PingFang.ttc",       # 苹方
            "/Library/Fonts/Songti.ttc",                # 宋体
            "/System/Library/Fonts/STHeiti Light.ttc",  # 华文细黑
        ]
    else:  # Linux 及容器环境
        candidate_paths = [
            "/usr/share/fonts/truetype/wqy/wqy-zenhei.ttc",
            "/usr/share/fonts/opentype/noto/NotoSansCJK-Regular.ttc",
            "/usr/share/fonts/truetype/droid/DroidSansFallbackFull.ttf",
        ]

    # 优先检查当前项目根目录下的 fonts 目录
    local_font = os.path.join(os.path.dirname(__file__), "fonts", "SourceHanSansCN-Regular.otf")
    if os.path.exists(local_font):
        return local_font

    for path in candidate_paths:
        if os.path.exists(path):
            return path

    raise FileNotFoundError(
        "未能找到可用的中文字体文件!请手动指定 font_path,"
        "或在项目目录下放置中文字体文件 (如 .ttf/.otf)。"
    )

def generate_chinese_wordcloud(input_file, output_image):
    # 1. 显式指定 UTF-8 编码读取源文件,彻底避免 UnicodeDecodeError
    if not os.path.exists(input_file):
        raise FileNotFoundError(f"输入文本不存在: {input_file}")

    with open(input_file, "r", encoding="utf-8") as f:
        raw_content = f.read()

    # 2. 中文精准分词并用空格重新拼接
    words = jieba.cut(raw_content)
    # 过滤单字或无意义空白,只保留长度大于1的有效词条
    filtered_words = [w.strip() for w in words if len(w.strip()) > 1]
    processed_text = " ".join(filtered_words)

    # 3. 获取字体路径
    font_path = get_system_chinese_font()
    print(f"使用字体路径: {font_path}")

    # 4. 初始化 WordCloud 实例
    # collocations=False 用于避免 wordcloud 自动将相邻词语作为双词搭配重复统计
    wc = WordCloud(
        font_path=font_path,
        width=1000,
        height=700,
        background_color="white",
        collocations=False,
        max_words=200,
        random_state=42
    )

    # 5. 生成并持久化保存
    wc.generate(processed_text)
    wc.to_file(output_image)
    print(f"词云图已成功导出至: {output_image}")

if __name__ == "__main__":
    # 执行前需确保 text.txt 以 UTF-8 编码保存
    # 示例执行: generate_chinese_wordcloud("sample.txt", "wordcloud.png")
    pass
四、常见避坑指南与排查清单
在实际项目部署与交付阶段,除了上述主要步骤,还有一些细节极易引发偶发性问题:
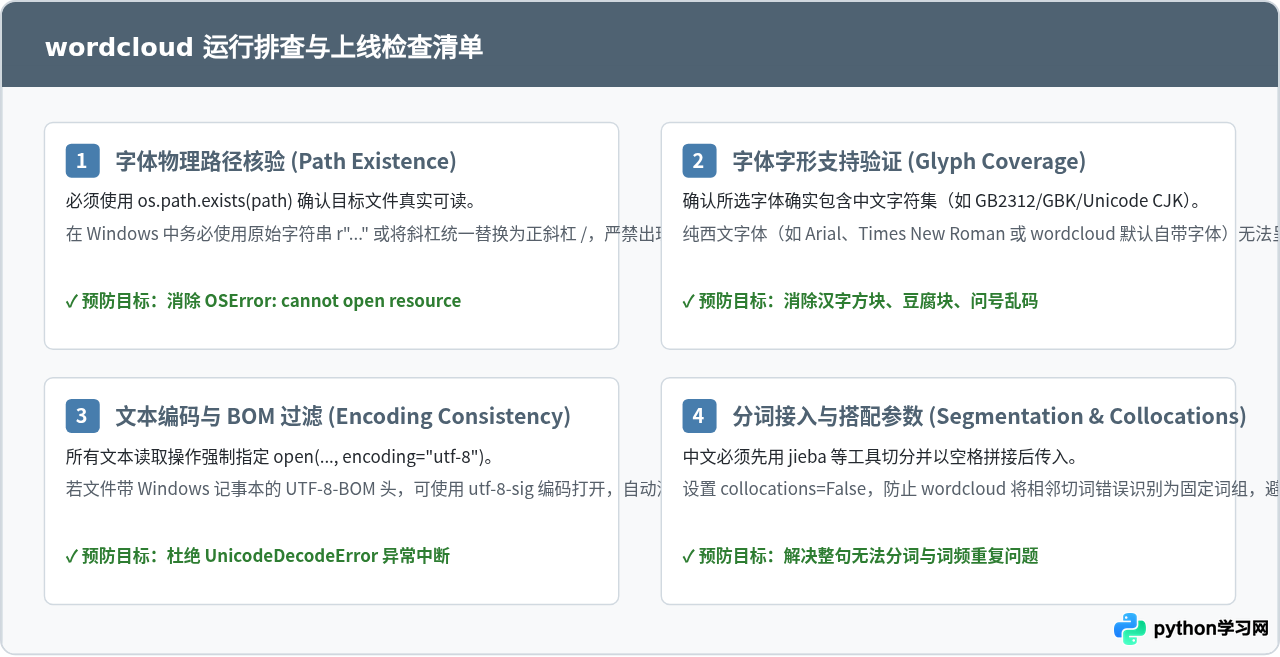
1. TTC 集合字体的注意事项
很多系统级中文字体文件后缀为 .ttc(TrueType Collection,字体集合包),例如 msyh.ttc 和 PingFang.ttc。在某些较旧版本的 Pillow 中,读取 TTC 文件若未指定子字体索引可能偶发告警。当前现代 Pillow 库已能直接加载 TTC 首选字形,但在制作长期维护的独立项目或容器镜像时,更推荐直接使用单体 .ttf 或 .otf 格式字体(如思源黑体 SourceHanSansSC-Regular.otf),其格式定义清晰单一,兼容性更为稳定。
2. Docker 容器构建陷阱
在将词云生成服务打包进 Docker 容器(如基于 python:3.10-slim 或 alpine)时,基础镜像通常经过极度精简,不携带任何中文字体库。如果在容器内部直接硬编码宿主机的 /System/Library/Fonts 或 C:\Windows\Fonts,容器启动后必然抛出 OSError: cannot open resource。在编写 Dockerfile 时,应通过包管理器安装基础字体包:
RUN apt-get update && apt-get install -y --no-install-recommends \
    fonts-wqy-zenhei \
    && rm -rf /var/lib/apt/lists/*
或者在 COPY 指令中将项目自身的 fonts/ 文件夹一并打包进容器镜像,这是实现“一次构建、到处运行”最稳妥的做法。
3. 处理 UTF-8 带 BOM 的文本
如果文本源文件是由 Windows 记事本等工具创建的,文件开头可能包含三个隐式字节 \xef\xbb\xbf(即 UTF-8 BOM)。如果仅使用 encoding="utf-8" 读取,这三个字节会被转换为 Unicode 字符 \ufeff,附加在首个词条前面,导致首个词语统计异常。解决方法是将编码参数指定为 encoding="utf-8-sig",Python 会自动检测并安全剔除 BOM 头。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









