

适合Python初学者的5个实战小项目:从猜数字到简易爬虫
适合Python初学者的5个递进式实战小项目教程。从控制台交互到数据持久化、操作系统交互,再到网络数据采集,通过完整代码与清晰原理解析帮助初学者跨越语法阶段,建立实际编码能力。
学完Python基础语法后,最有效的进阶方式不是反复背诵文档,而是通过小型项目解决具体问题。本文精选5个难度循序渐进的练手项目,涵盖基础分支循环、本地数据读写、系统文件操作与网络数据采集,提供完整源码、逻辑拆解与避坑指南。
一、技能进阶路径与项目规划
初学者在掌握了变量、数据类型、条件判断与函数之后,常常面临“看得懂教程却写不出程序”的脱节状态。原因在于零散的语法知识只有嵌入到实际的调用闭环中,才能形成工程解决思维。
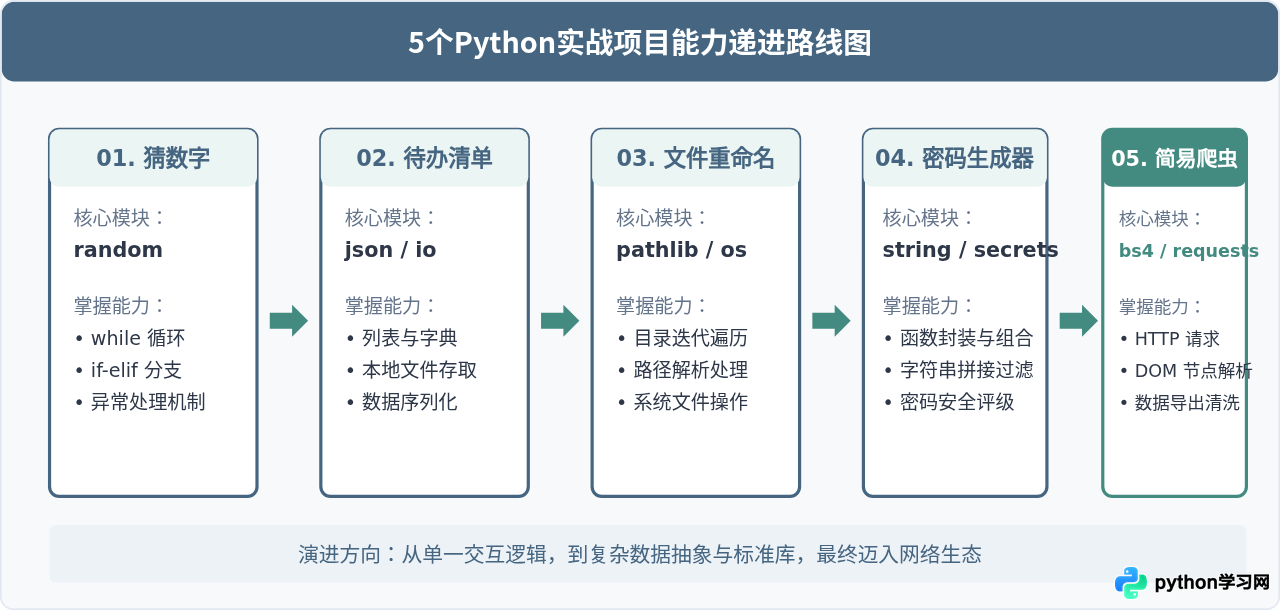
为了让学习曲线平缓且目标清晰,本文安排的5个项目遵循从控制台到本地系统,再延伸至互联网请求的技术脉络:
- 项目1:猜数字游戏 —— 掌握条件分支、while 循环控制与异常容错。
- 项目2:命令行待办事项清单 —— 掌握复合数据结构(列表与字典)以及 JSON 格式的本地持久化。
- 项目3:批量文件重命名工具 —— 掌握标准库
pathlib与os,实现安全的系统磁盘读写。 - 项目4:强密码生成与评估器 —— 掌握字符串处理、函数模块化设计以及随机算法。
- 项目5:简易网页资讯爬虫 —— 掌握第三方库
requests与BeautifulSoup,完成网络请求与 DOM 数据提取。
二、项目一:猜数字游戏(掌握变量、循环与条件分支)
猜数字游戏是初学编程的第一站。它结构精炼,却能涵盖现代程序运行的核心环节:系统初始化随机值、持续接收用户输入、数据类型转换、大小比较逻辑分支以及循环终止控制。
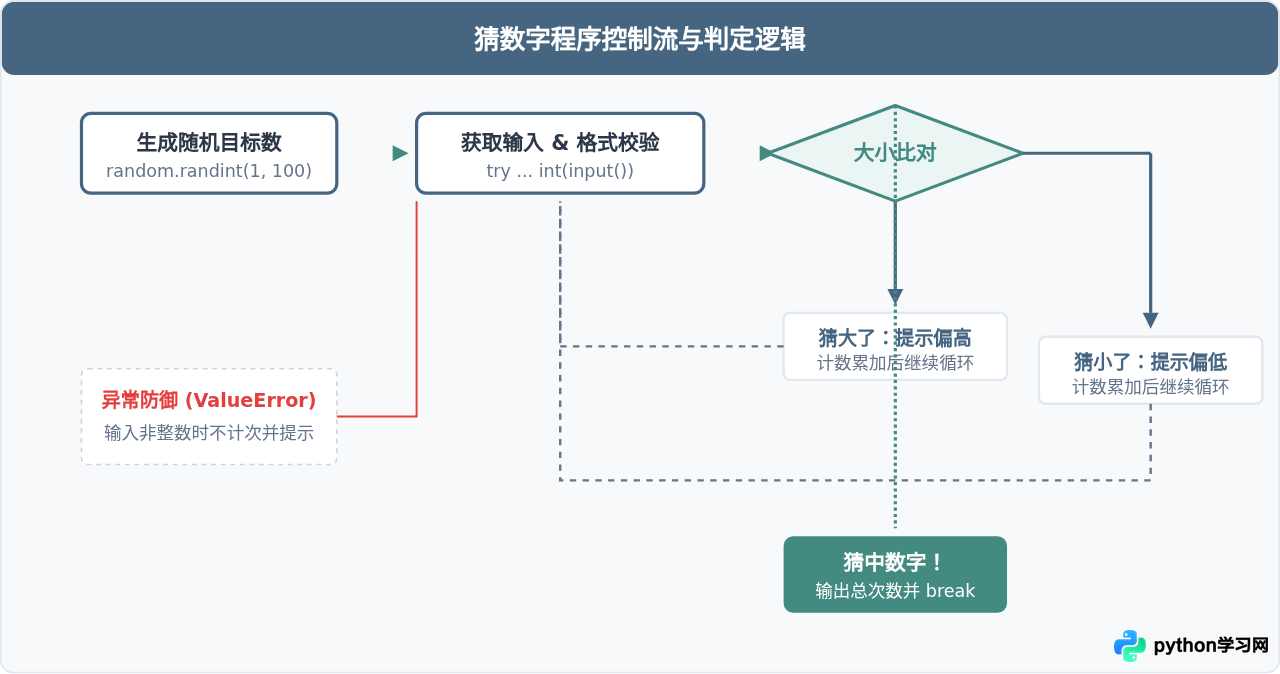
1. 逻辑流程与设计思路
程序开始时生成 1 到 100 之间的随机整数。通过 while True 建立交互主循环,每次等待用户输入。需要特别注意:Python input() 函数返回的是字符串类型,必须转为 int 才能进行数值比较。若用户输入非数字字符,需通过异常捕获防止程序崩溃。
2. 完整代码实现
import random

def guess_number_game():
    target = random.randint(1, 100)
    attempts = 0
    print("=== 欢迎来到猜数字小游戏 ===")
    print("目标已锁定在 1 到 100 之间,请开始猜测!")

    while True:
        user_input = input("请输入你猜的整数(输入 q 退出):").strip()

        if user_input.lower() == 'q':
            print(f"已放弃游戏,正确答案是:{target}")
            break

        try:
            guess = int(user_input)
        except ValueError:
            print("【输入错误】请输入有效的正整数!")
            continue

        attempts += 1

        if guess < 1 or guess > 100:
            print("【提示】数字超出范围,请输入 1-100 之间的数字。")
            continue

        if guess < target:
            print(f"太小了!这是你的第 {attempts} 次尝试。")
        elif guess > target:
            print(f"太大了!这是你的第 {attempts} 次尝试。")
        else:
            print(f"\n恭喜你猜对了!目标就是 {target}。")
            print(f"你总共尝试了 {attempts} 次。")
            break

if __name__ == "__main__":
guess_number_game()很多新手初写时容易直接写 guess = int(input())。一旦用户无意中按了回车或者输入了字母,Python 会立即抛出 ValueError 导致程序异常终止。养成用 try...except 包裹类型转换的习惯,是写出健壮代码的第一步。
三、项目二:命令行待办事项清单(掌握复合数据结构与文件存储)
仅在内存中运行的代码,每次退出后数据都会丢失。待办事项清单(To-Do List)项目引导初学者接触数据结构建模与本地持久化,让程序真正具有实用价值。
1. 数据建模与 JSON 持久化
在内存中,我们使用字典列表表示待办项:每个任务拥有 id、title 和 done 属性。利用 Python 内置的 json 模块,在程序启动时读取 todos.json,在修改任务后自动写入磁盘,保证数据不丢失。
2. 完整代码实现
import json
from pathlib import Path

DATA_FILE = Path("todos.json")

def load_todos():
    """读取本地文件中的待办事项列表"""
    if not DATA_FILE.exists():
        return []
    try:
        with open(DATA_FILE, "r", encoding="utf-8") as f:
            return json.load(f)
    except json.JSONDecodeError:
        return []

def save_todos(todos):
    """将待办列表写回本地文件"""
    with open(DATA_FILE, "w", encoding="utf-8") as f:
        json.dump(todos, f, ensure_ascii=False, indent=2)

def list_todos(todos):
    """打印当前所有任务列表"""
    if not todos:
        print("\n当前没有待办事项,轻松一下吧!")
        return
    print("\n----- 待办事项列表 -----")
    for item in todos:
        status = "[x]" if item["done"] else "[ ]"
        print(f"{item['id']}. {status} {item['title']}")
    print("------------------------")

def add_todo(todos):
    """添加一条新的待办事项"""
    title = input("请输入要添加的任务内容: ").strip()
    if not title:
        print("任务内容不能为空!")
        return
    next_id = max([item["id"] for item in todos], default=0) + 1
    todos.append({"id": next_id, "title": title, "done": False})
    save_todos(todos)
    print(f"已添加任务: #{next_id} {title}")

def toggle_todo(todos):
    """切换指定任务的完成状态"""
    try:
        target_id = int(input("请输入要标记/取消标记的任务编号: "))
    except ValueError:
        print("请输入正确的数字编号!")
        return
    for item in todos:
        if item["id"] == target_id:
            item["done"] = not item["done"]
            save_todos(todos)
            state_str = "已完成" if item["done"] else "未完成"
            print(f"任务 #{target_id} 状态已更新为:{state_str}")
            return
    print(f"未找到编号为 #{target_id} 的任务。")

def main():
    todos = load_todos()
    while True:
        print("\n[1] 查看待办  [2] 添加任务  [3] 切换状态  [4] 退出程序")
        choice = input("请选择操作 (1/2/3/4): ").strip()
        if choice == "1":
            list_todos(todos)
        elif choice == "2":
            add_todo(todos)
        elif choice == "3":
            toggle_todo(todos)
        elif choice == "4":
            print("再见!")
            break
        else:
            print("无效的指令,请重新输入。")

if __name__ == "__main__":
    main()
四、项目三:批量文件重命名工具(掌握标准库与文件系统交互)
日常办公中经常遇到整理照片、整理下载资料或按格式批量重命名文件的需求。通过该项目,初学者可以掌握 pathlib.Path 模块的目录遍历、文件名切分与磁盘文件重命名,深刻体会用 Python 自动化代替繁琐手工操作的优势。
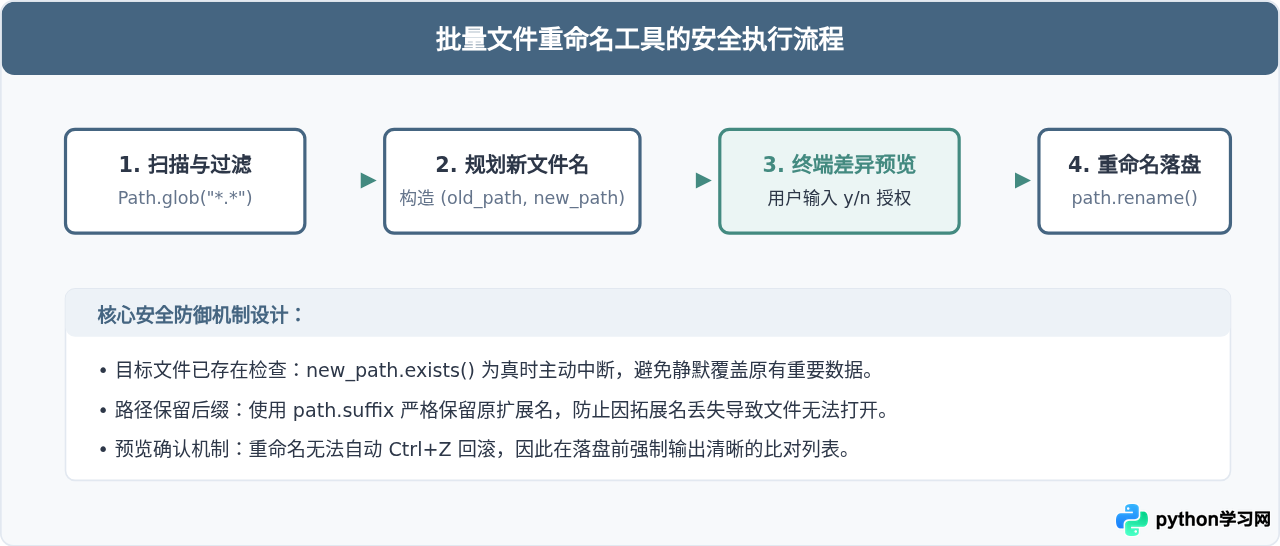
1. 安全执行逻辑与防护机制
操作真实磁盘文件时必须严防数据丢失。规范的重命名工具必须遵循两项安全准则:先展示预览再执行确认,以及目标路径冲突检测。
2. 完整代码实现
from pathlib import Path

def batch_rename(directory_path, prefix, extension_filter=None):
    target_dir = Path(directory_path)
    if not target_dir.is_dir():
        print(f"【错误】路径 '{directory_path}' 不是有效的文件夹!")
        return

    # 收集符合条件的文件
    files = [f for f in target_dir.iterdir() if f.is_file()]
    if extension_filter:
        ext = extension_filter if extension_filter.startswith(".") else f".{extension_filter}"
        files = [f for f in files if f.suffix.lower() == ext.lower()]

    files.sort(key=lambda x: x.name)

    if not files:
        print("未找到需要重命名的文件。")
        return

    # 1. 预先计算映射计划
    rename_plan = []
    for index, file_path in enumerate(files, start=1):
        new_filename = f"{prefix}_{index:03d}{file_path.suffix}"
        new_path = file_path.parent / new_filename
        rename_plan.append((file_path, new_path))

    # 2. 打印差异预览
    print(f"\n找到 {len(rename_plan)} 个匹配文件,改名计划如下:")
    for old, new in rename_plan:
        print(f"  {old.name}  ==>  {new.name}")

    # 3. 提示用户确认
    confirm = input("\n确认执行以上修改吗?(y/n): ").strip().lower()
    if confirm != 'y':
        print("已取消重命名操作。")
        return

    # 4. 执行重命名
    success_count = 0
    for old, new in rename_plan:
        if old == new:
            continue
        if new.exists():
            print(f"【跳过】目标文件 {new.name} 已存在,防止覆盖!")
            continue
        try:
            old.rename(new)
            success_count += 1
        except OSError as e:
            print(f"重命名 {old.name} 失败: {e}")

    print(f"\n重命名完成!成功处理了 {success_count} 个文件。")

if __name__ == "__main__":
    # 使用示例:对当前目录下的 photos 文件夹批量重命名
    # batch_rename("./photos", "Travel_Photo", ".jpg")
    print("批量重命名模块已就绪,调用 batch_rename(dir, prefix, ext) 即可使用。")
五、项目四:强密码生成与评估器(掌握函数封装与模块化思维)
密码生成器是学习函数设计与字符串处理的经典范例。通过组合标准库 string 和 random(或更安全的 secrets 模块),读者能学到如何把大任务拆分成职责分明的独立小函数。
1. 模块化设计要求
| 函数名称 | 输入参数 | 核心职责 |
|---|---|---|
generate_password |
length, use_upper, use_digits, use_special | 根据用户勾选的字符池,生成随机乱序的强字符串 |
check_strength |
password | 基于长度和字符集维度对密码进行 1-4 级的安全评分 |
2. 完整代码实现
import secrets
import string

def generate_password(length=12, use_upper=True, use_digits=True, use_special=True):
    """
    根据给定的规则生成高随机度密码
    使用 secrets 替代普通 random 模块以提高密码安全性
    """
    if length < 4:
        raise ValueError("密码长度至少需要4位以保证安全性")

    characters = list(string.ascii_lowercase)
    guaranteed = [secrets.choice(string.ascii_lowercase)]

    if use_upper:
        characters.extend(string.ascii_uppercase)
        guaranteed.append(secrets.choice(string.ascii_uppercase))
    if use_digits:
        characters.extend(string.digits)
        guaranteed.append(secrets.choice(string.digits))
    if use_special:
        symbols = "!@#$%^&*()_+-=[]{}|;:,."
        characters.extend(symbols)
        guaranteed.append(secrets.choice(symbols))

    # 填充剩余位数
    remaining_length = length - len(guaranteed)
    for _ in range(remaining_length):
        guaranteed.append(secrets.choice(characters))

    # 打乱字符顺序避免前几位类型固定
    secrets.SystemRandom().shuffle(guaranteed)
    return "".join(guaranteed)

def check_strength(password):
    """对生成的密码进行简明强度评分"""
    score = 0
    if len(password) >= 8:
        score += 1
    if any(c.isupper() for c in password):
        score += 1
    if any(c.isdigit() for c in password):
        score += 1
    if any(c in "!@#$%^&*()_+-=[]{}|;:,." for c in password):
        score += 1

    level_map = {1: "弱 (Weak)", 2: "中等 (Medium)", 3: "良好 (Good)", 4: "极强 (Strong)"}
    return level_map.get(score, "极弱 (Very Weak)")

if __name__ == "__main__":
    print("=== 随机强密码生成器 ===")
    pwd = generate_password(length=16, use_upper=True, use_digits=True, use_special=True)
    strength = check_strength(pwd)
    print(f"生成的密码: {pwd}")
    print(f"安全评估:   {strength}")
六、项目五:简易网页新闻爬虫(掌握网络请求与 DOM 数据解析)
爬虫是 Python 最受初学者欢迎的应用场景之一。在掌握了前面的控制流、文件存取与模块使用后,编写爬虫只需迈出关键一步:利用 HTTP 客户端获取网络文档,再通过解析器抽取指定信息。
1. 网络抓取管线
完整的简易爬虫遵循四个步骤:构造包含真实 User-Agent 的请求头、发起 GET 请求获取 HTML 文本、使用 BeautifulSoup 查找目标 DOM 节点,以及将提取的纯文本整理落盘。
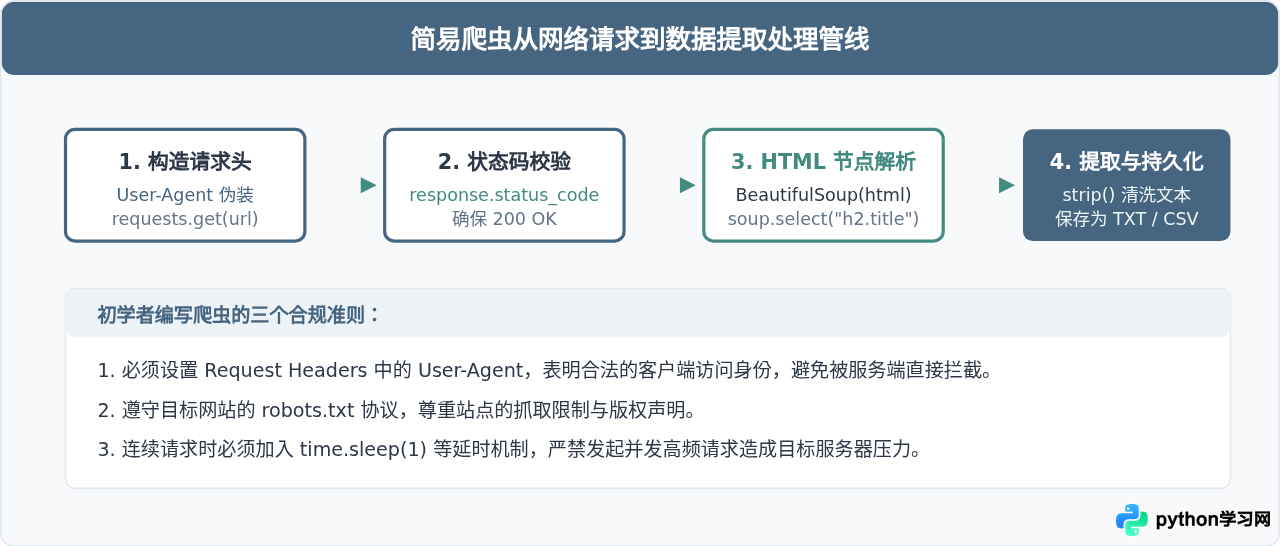
2. 环境依赖与安装
执行爬虫项目前,需要安装两个业界广泛使用的第三方库:
pip install requests beautifulsoup43. 完整代码实现
import time
import requests
from bs4 import BeautifulSoup

def fetch_top_stories(target_url):
    """抓取目标页面的文章标题与链接"""
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        )
    }

    print(f"正在发起请求: {target_url}")
    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        # 显式设定编码,防止中文网页乱码
        response.encoding = response.apparent_encoding
        response.raise_for_status()
    except requests.RequestException as e:
        print(f"【网络请求失败】: {e}")
        return []

    # 解析 HTML 内容
    soup = BeautifulSoup(response.text, "html.parser")

    # 示例选择器:查找常见页面中的 h2, h3 标题
    # 实际应用中请根据具体目标网页的 HTML 结构调整 CSS 选择器
    articles = []
    headers_tags = soup.find_all(["h2", "h3"])

    for tag in headers_tags:
        title = tag.get_text(strip=True)
        if len(title) >= 5:  # 过滤过短的无意义标签
            link_tag = tag.find("a")
            link = link_tag.get("href") if link_tag else "无外链"
            articles.append({"title": title, "link": link})

    return articles

def save_to_markdown(data, output_file="news_digest.md"):
    """将抓取到的内容输出为 Markdown 清单"""
    with open(output_file, "w", encoding="utf-8") as f:
        f.write("# 抓取资讯汇总\n\n")
        f.write(f"生成时间: {time.strftime('%Y-%m-%d %H:%M:%S')}\n\n")
        for idx, item in enumerate(data, start=1):
            f.write(f"{idx}. **{item['title']}**\n   链接: {item['link']}\n")
    print(f"成功导出 {len(data)} 条数据至文件: {output_file}")

if __name__ == "__main__":
    # 以示例技术博客站点为例演示
    sample_url = "https://httpbin.org/html"
    results = fetch_top_stories(sample_url)
    if results:
        for r in results:
            print(f"- {r['title']}")
        save_to_markdown(results)
    else:
        print("未提取到匹配的数据内容。")
七、初学者如何高效巩固与继续进阶
完成这 5 个实战小项目后,初学者已经实际运用了 Python 最核心的基础机制。接下来如何避免遗忘并持续提升?建议遵循以下三步法:
- 改写现有功能:给猜数字增加排行榜与最高分记录;给待办清单增加截止日期筛选;给批量重命名增加正则替换支持。
- 组合多个项目:例如将项目五(爬虫)抓取到的数据,用项目二学到的 JSON 文件读写保存起来,再自动用项目四的方法进行字符串过滤。
- 尝试添加界面:安装
tkinter或PyQt,将控制台输入框替换为真实的图形桌面窗口,或者使用Flask改造为轻量 Web 页面。
编程能力是在一次次解决实际报错中累积起来的。保持写完整可运行程序的习惯,逐步扩充功能边界,就能扎实完成从初学者到独立开发者的蜕变。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









