

怎么在PyCharm中结合jieba分词生成自定义形状词云
在PyCharm中结合jieba分词与wordcloud库生成自定义形状中文词云的完整实操指南,涵盖依赖安装、遮罩图像处理、中文字体配置、停用词过滤及高频排错方案。
在Python文本分析与可视化中,将一段中文文本按指定图形轮廓排列为词云,核心在于三项工作的串联:利用 jieba 将连续中文切分为独立词汇并剔除无意义词,利用 Pillow 与 numpy 将轮廓图片转化为二值遮罩矩阵(Mask),以及在 wordcloud 库中配置本地中文字体路径与遮罩参数。本文将以 PyCharm 为开发环境,从零搭建工程并逐步实现自定义形状词云的生成。
一、工程初始化与依赖库安装
在生成自定义形状词云前,需要在 PyCharm 项目所使用的 Python 解释器环境中安装五个核心类库:用于文本切词的 jieba、用于绘制词云的 wordcloud、处理图像的 pillow、处理数组矩阵的 numpy,以及用于预览与展示图表的 matplotlib。
在 PyCharm 界面底部打开 Terminal(终端窗口),确保虚拟环境处于激活状态(终端行首通常带有虚拟环境名称如 (venv)),执行以下安装命令:
pip install jieba wordcloud pillow numpy matplotlib安装完成后,建议在项目根目录下规划清晰的文件组织结构,避免因相对路径错误导致程序无法读取遮罩图片或字体文件:
main.py:主运行脚本,承载数据读取、分词、词云生成与图表保存逻辑。source_text.txt:待分析的中文源文本文件(UTF-8 编码)。mask_shape.png:自定义轮廓图片(白色底、黑色或纯色剪影主体)。stopwords.txt:停用词列表,用于排除“的”、“了”、“在”等高频无信息词。msyh.ttc(可选):中文字体文件,亦可直接引用操作系统系统盘中的自带字体。
二、自定义形状遮罩(Mask)的原理与选图规范
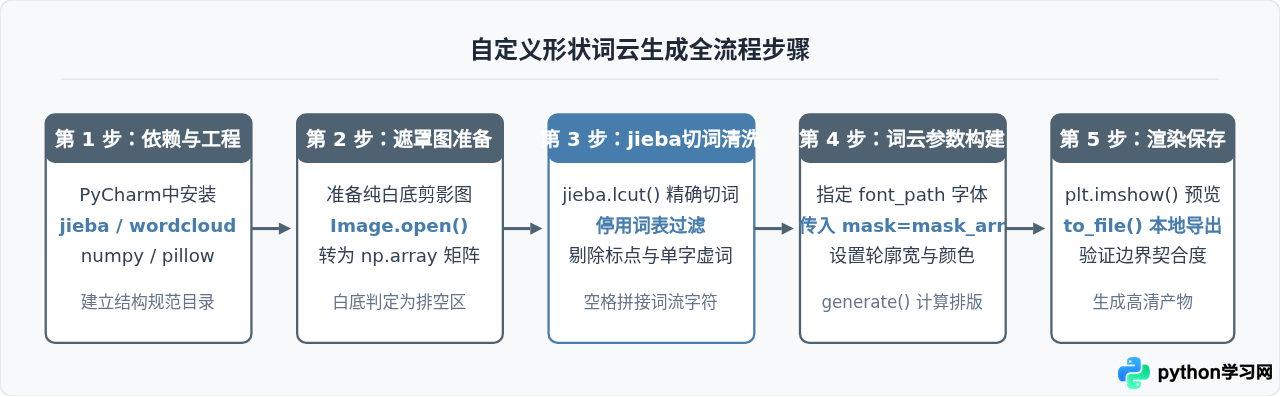
WordCloud 是如何识别“形状”的?理解底层原理能直接避免 90% 的形状失效问题。WordCloud 接受一个二维或三维的 numpy.ndarray 数组作为 mask 参数。在算法排版逻辑中:
- 像素值为 255(纯白色)的区域:被判定为“禁止放置区域”(即图形外部留白)。
- 像素值小于 255(非纯白、黑色或深色彩色)的区域:被判定为“允许填入文字的区域”。
因此,选择与准备遮罩图片时必须遵守两条基本规范:
- 背景必须为绝对纯白(RGB: 255, 255, 255):许多网络下载的 JPG 图片由于有损压缩,背景白色可能夹杂着
(254, 253, 255)这种人眼难以察觉的浅灰杂色。如果不做二值化清洗,算法会将杂色判定为可排版区,导致形状依然呈现长方形。 - 切忌使用未经转换的透明背景 PNG:透明通道(Alpha=0)读取为数组时,各颜色通道数值通常为 0(等同于黑色),会导致整张图片全部被当成填词区。
三、结合 jieba 进行中文分词与数据清洗
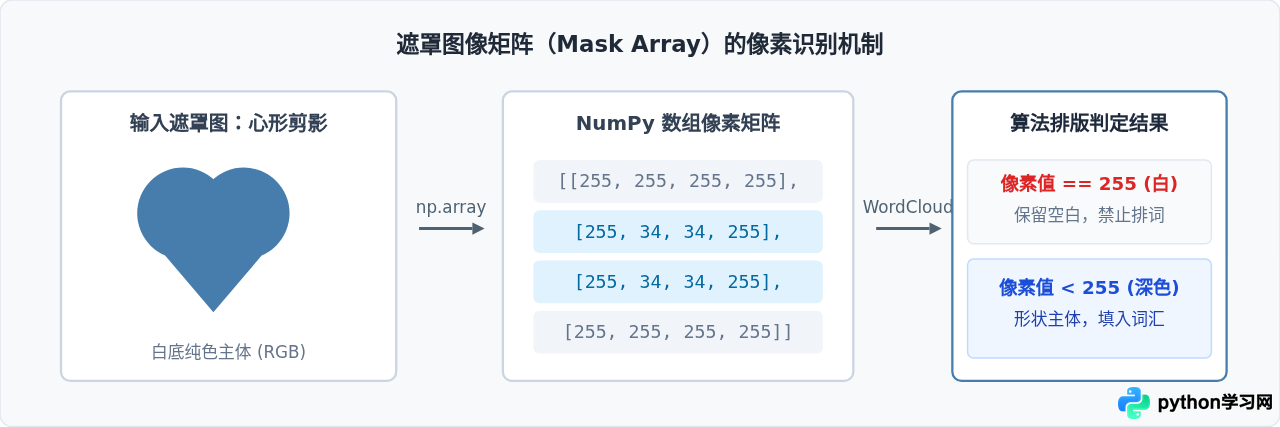
英文词云能直接依据空格拆分单词,而中文书写是连续的汉字流。如果不做预分词,WordCloud 会将整句话或单独汉字作为词元,导致词云可读性极低。结合 jieba 可以精确切分出有意义的词组。
切词过程中有三个关键细节需要处理:
- 使用精确模式切词:调用
jieba.lcut(text, cut_all=False),避免全模式切分产生冗余的子词。 - 加载专有名词词典(可选但实用):若文本涉及专业术语(如“人工智能”、“机器学习”、“PyCharm”),可调用
jieba.add_word("专有名词")防止被拆散为单字。 - 过滤停用词与标点:遍历分词结果,过滤掉长度为 1 的无意义单字、纯数字符号以及预设停用词表(如“我们”、“可以”、“因为”等)。
- 以空格拼接有效词汇:WordCloud 的
generate()方法默认接收空格分隔的字符串。因此需将清洗后的词列表重新通过" ".join(filtered_words)组装。
四、完整实战代码与参数配置
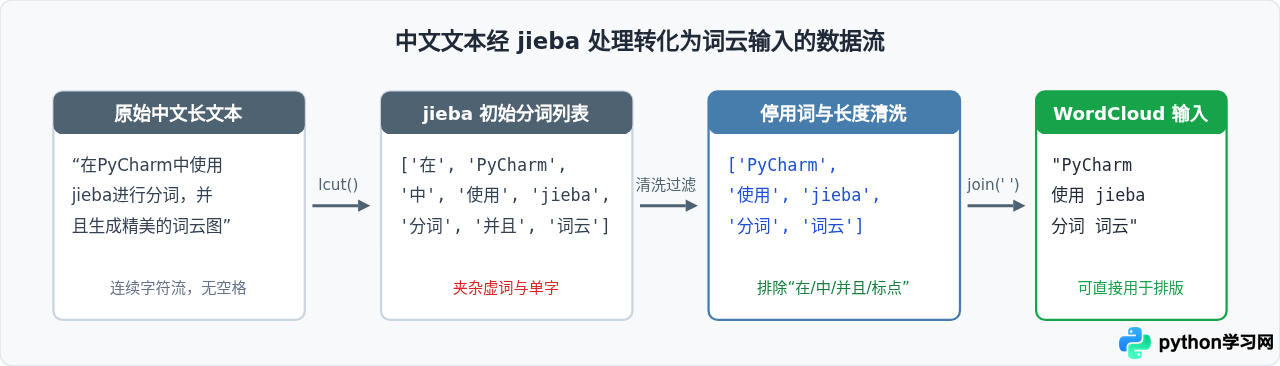
在 PyCharm 中新建 Python 文件 generate_cloud.py,编写以下完整代码。代码中包含了遮罩读取、二值化清洗(消除边缘噪点)、jieba分词清洗、词云构建与渲染导出的全流程。
import jieba
import numpy as np
from PIL import Image
from wordcloud import WordCloud
import matplotlib.pyplot as plt

def generate_custom_wordcloud():
    # 1. 准备并加载中文源文本
    text_content = """
    Python是一种广泛使用的解释型高级通用编程语言。在数据科学、机器学习、自动化办公、
    网络爬虫与数据可视化领域应用极广。PyCharm作为功能强大的Python集成开发环境,
    为开发者提供了智能代码补全、代码检查、快速修复与版本控制支持。
    结巴分词jieba是优秀的中文分词工具,支持精确模式、全模式和搜索引擎模式,
    能够帮助文本挖掘工作者准确识别中文词汇,生成直观且美观的自定义形状词云图。
    数据分析可视化使原本枯燥的文本数据转变为具有艺术感染力的视觉成果。
    """

    # 2. 补充自定义专用词汇(避免被 jieba 拆散)
    jieba.add_word("结巴分词")
    jieba.add_word("数据可视化")

    # 3. 进行分词并结合停用词过滤
    raw_words = jieba.lcut(text_content, cut_all=False)
    # 定义常见停用词集合(实际开发中可读取外部 stopwords.txt)
    stopwords = {"在", "是", "的", "了", "和", "与", "为", "能够", "使", "极", "作为"}

    # 筛选有效词汇:排除停用词与单个无意义字符
    cleaned_words = [w.strip() for w in raw_words if len(w.strip()) > 1 and w.strip() not in stopwords]
    word_space_string = " ".join(cleaned_words)

    # 4. 加载自定义形状遮罩图片并执行二值化防杂色处理
    # 遮罩图必须为白底黑形(或深色主体)
    raw_mask = Image.open("mask_shape.png").convert("L")  # 转灰度图像
    mask_array = np.array(raw_mask)

    # 关键防坑处理:将接近纯白(>240)的过渡噪点强制修正为 255 纯白留白区
    mask_array = np.where(mask_array > 240, 255, mask_array)

    # 5. 配置 WordCloud 核心参数(注意中文字体路径)
    # Windows 推荐字体:'C:/Windows/Fonts/msyh.ttc'(微软雅黑)或 'simhei.ttf'(黑体)
    # macOS 推荐字体:'/System/Library/Fonts/PingFang.ttc' 或 '/System/Library/Fonts/STHeiti Light.ttc'
    # Linux 推荐字体:'/usr/share/fonts/truetype/wqy/wqy-microhei.ttc'
    font_file = "C:/Windows/Fonts/msyh.ttc"

    wc = WordCloud(
        font_path=font_file,         # 必须指定中文字体,否则中文显示为豆腐块
        mask=mask_array,             # 传入形状遮罩矩阵
        background_color="white",    # 画布背景色,通常设为 white 或 None (透明)
        max_words=200,               # 显示最大词数
        max_font_size=80,            # 最大字号
        min_font_size=10,            # 最小字号
        contour_width=2,             # 形状轮廓描边宽度(像素)
        contour_color="#477DAD",     # 轮廓线颜色,强化自定义形状的辨识度
        colormap="Blues",            # 文字主色盘(如 Viridis, Blues, coolwarm 等)
        random_state=42              # 固定随机种子,确保每次生成排版一致
    )

    # 6. 根据词频文本生成词云
    wc.generate(word_space_string)

    # 7. 在 PyCharm 中弹出预览窗口并保存到本地
    plt.figure(figsize=(10, 8), dpi=200)
    plt.imshow(wc, interpolation="bilinear")
    plt.axis("off")  # 隐藏坐标轴
    plt.tight_layout(pad=0)

    # 保存高分辨率图片产物
    wc.to_file("custom_wordcloud_output.png")
    print("词云生成完毕,已保存为 custom_wordcloud_output.png")
    plt.show()

if __name__ == "__main__":
    generate_custom_wordcloud()
核心参数解析说明
| 参数名 | 推荐取值 | 关键作用与设置技巧 |
|---|---|---|
font_path |
系统真实字体绝对路径 | 决定中文是否正常显示。未指定此参数时,WordCloud 默认使用内置英文字体 DroidSansMono,导致所有中文变成空白方框(豆腐块)。 |
mask |
NumPy 二维/三维数组 | 决定词云轮廓。数组中数值为 255 的点作为留白,小于 255 的点作为排词区。 |
contour_width |
1 ~ 3(像素) | 绘制遮罩形状的外围边界线。当词数较少、无法填满形状边缘时,开启轮廓线能大幅提升整体图形的轮廓辨识度。 |
contour_color |
十六进制颜色或颜色名 | 轮廓边框颜色。建议选择与背景形成鲜明对比的深色(如 #477DAD)。 |
colormap |
Matplotlib 色系名称 | 文字颜色的配色方案,例如 'tab10'、'Blues'、'viridis'。 |
五、常见问题与排错自检指南
在实际编码与运行过程中,初学者常遇到“中文不显示”、“形状依然是方形”、“词被切碎”等问题。以下整理了四大高频问题的现象、诱因及针对性解决方案。
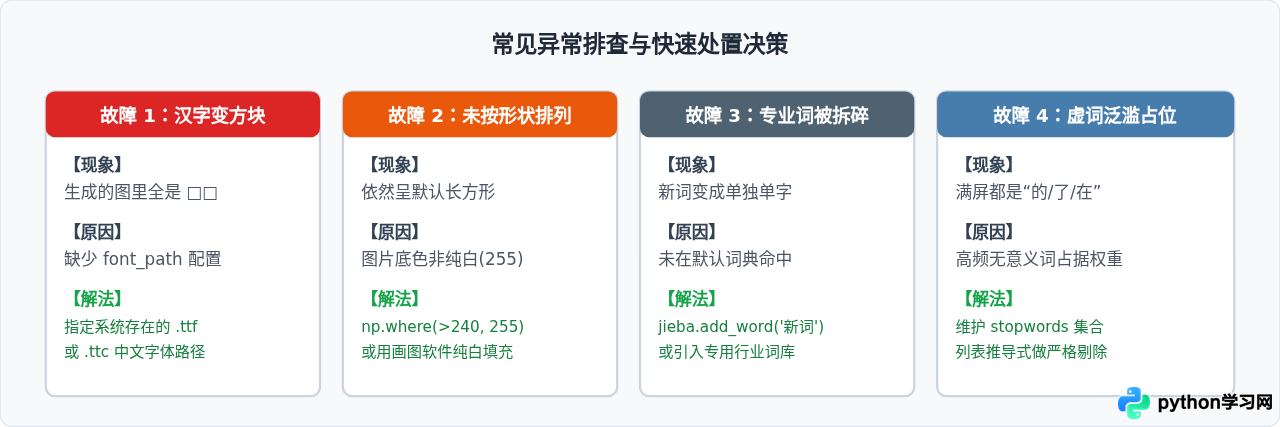
如果在不同操作系统或部署服务器(如 Linux Docker 容器)中运行,可直接在 PyCharm 项目目录下放置一个开源免费的中文字体文件(如思源黑体 SourceHanSansSC-Regular.otf),代码中使用相对路径引用 font_path="./SourceHanSansSC-Regular.otf",即可实现跨平台的统一渲染,彻底杜绝操作系统自带字体缺失的风险。
六、进阶效果微调技巧
完成基础自定义形状词云后,可以通过以下几个技巧进一步提升视觉效果与实用性:
- 使用原图颜色作为字体颜色(ImageColorGenerator):如果遮罩图本身具有丰富的色彩分布(例如一张彩色蝴蝶或中国地图),可以使用
from wordcloud import ImageColorGenerator,通过image_colors = ImageColorGenerator(mask_array)提取色彩,并在wc.recolor(color_func=image_colors)中应用,使词云文字颜色自动贴合原图材质。 - 提高导出图像清晰度:默认生成的词云分辨率可能较低。在初始化
WordCloud对象时,可以增加scale=2或scale=3参数,将输出尺寸按比例放大,生成支持高清打印和汇报演示的矢量感图片。 - 自定义词频字典直接输入:若已有各关键词的精确统计频次,无需拼接长文本,可以直接调用
wc.generate_from_frequencies(freq_dict),此时 wordcloud 会精确依据频次字典的大小比例安排字号。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









