

Python列表推导式与生成器的高效使用场景

深入解析Python列表推导式与生成器表达式的核心机制、性能差异与高效使用场景,帮助开发者根据数据规模、访问模式和资源限制做出最佳技术选型。
在编写日常Python代码时,列表推导式(List Comprehension)与生成器(Generator / Generator Expression)是处理集合数据最常用的两种语法结构。二者在语法形式上极为相似,仅有中括号 [...] 与圆括号 (...) 的细微差别,但在底层运行机制、内存分配模型与适用场景上存在本质区别。高效使用它们的核心在于:明确当前数据是需要被完整持久化与多轮读取,还是仅在流水线中按需单次流转。
一、核心机制对比:即时求值与惰性迭代
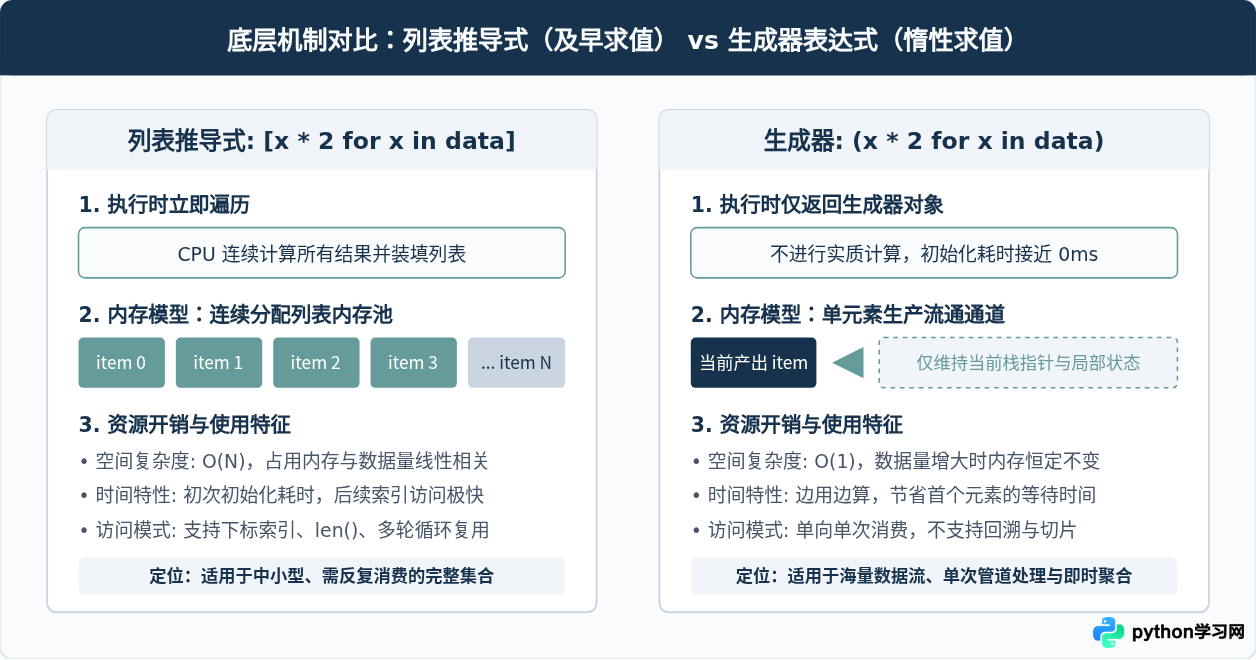
列表推导式遵循及早求值(Eager Evaluation)策略。在执行推导式的一瞬间,解释器会遍历输入数据,完整计算出所有元素,并在内存中一次性分配空间构建新的 list 对象。这种模式的优势在于后续可以随时进行索引访问、随机切片以及多轮遍历,但劣势是内存消耗与数据规模成线性正比(\(O(N)\))。
生成器表达式则采用惰性求值(Lazy Evaluation)机制。定义生成器时不会预先计算任何元素,也不会分配用于容纳全量数据的内存空间,而是返回一个轻量的迭代器对象。只有当外部通过 next()、for 循环或聚合函数触发迭代时,生成器才会计算并产出一个元素,计算完成后立即释放中间状态,其内存开销始终保持恒定(\(O(1)\))。
二、从普通循环到推导式与生成器的重构步骤
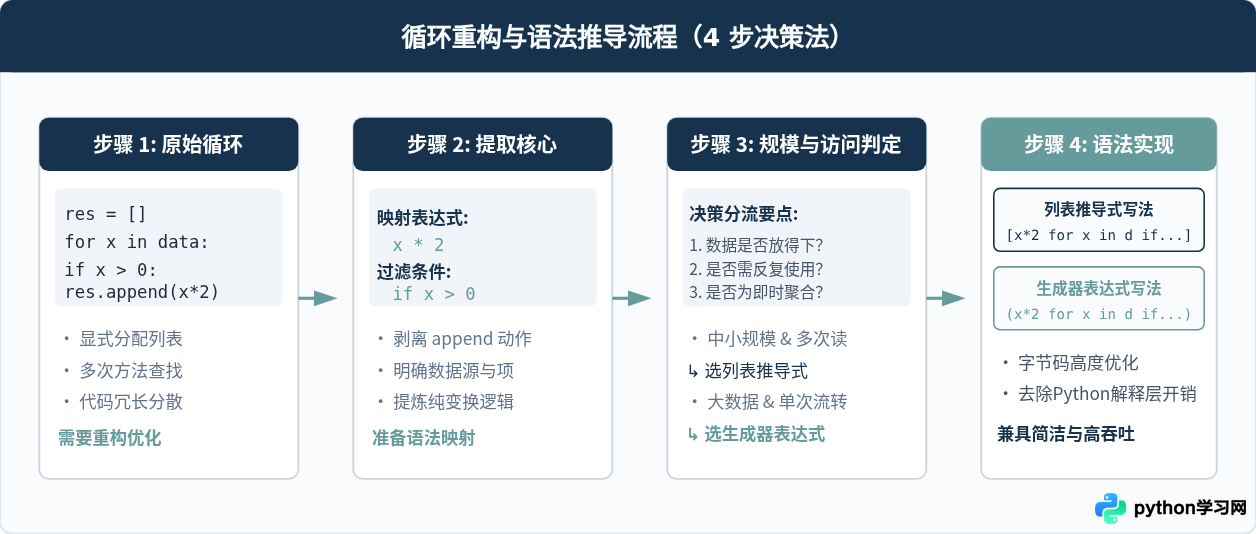
很多初学者容易将所有传统 for 循环直接重写为复杂的推导式,或者为了节省内存盲目使用生成器。合理的代码重构应当依据明确的决策步骤推进:
- 识别核心转换逻辑:分析循环体内部是否有显式的集合构建逻辑(如频繁调用
list.append()),以及是否存在前置过滤条件(if)。 - 评估数据生命周期:判断产出的数据在后续流程中是否需要被多次遍历、通过索引访问,或者传递给需要已知长度(
len())的第三方API。 - 选择表达载体:需要就地持久化多轮消费的选用列表推导式;属于单次流式消费、大数据清洗或聚合计算的选用生成器表达式。
- 验证复杂度与可读性:确保嵌套深度不超过两层,避免单行包含过多业务逻辑。
三、列表推导式的高效使用场景
列表推导式不仅是语法糖,在底层C语言解释器层面,它通过专用的 LIST_APPEND 字节码指令直接构建底层数组,避免了常规循环中反复查找 append 属性与函数调用的额外开销。在满足以下场景时,使用列表推导式能够兼顾运行速度与代码简洁度:
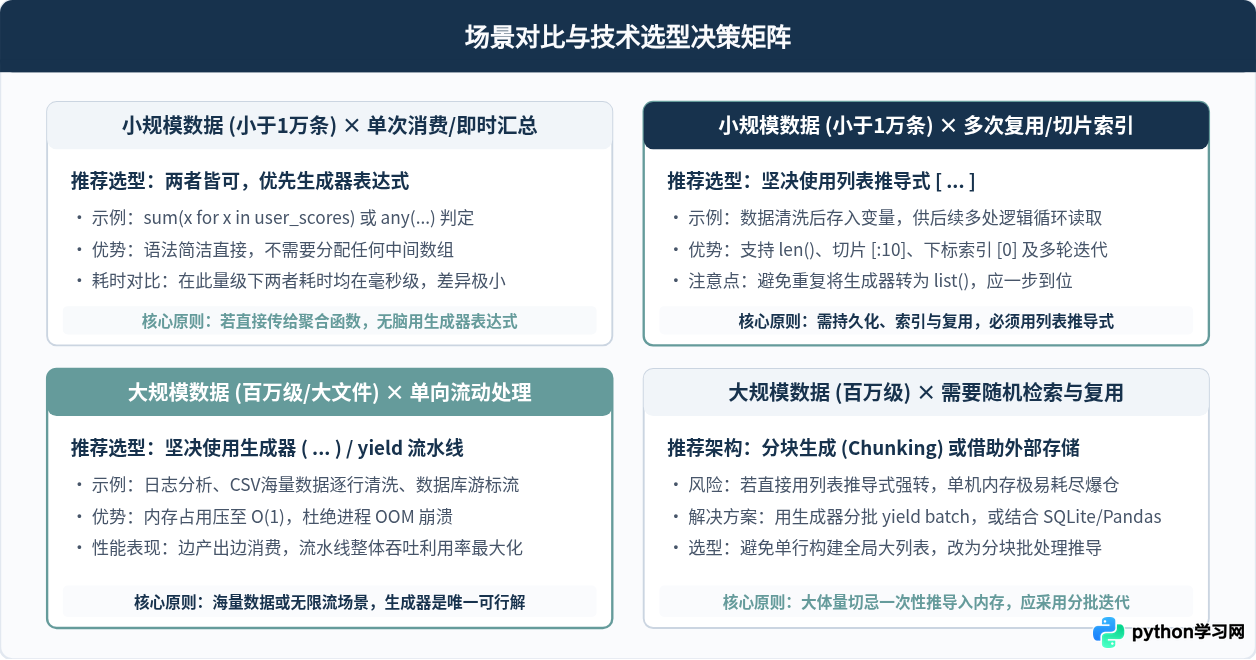
1. 数据集已知、体量适中且需要频繁随机访问
当处理已知长度的数据集(例如配置文件项、数据库分页返回的几十到几千条记录)且后续业务逻辑需要根据索引访问元素(如 result[0]、切片 result[10:20])或获取集合总长度 len(result) 时,列表推导式是最佳选择。
# 示例:清洗并标准化中小型数据集
raw_users = [" alice ", "BOB", "  Charlie", "", "David "]

# 列表推导式:去除前后空格并统一为小写,过滤无效空值
cleaned_users = [u.strip().lower() for u in raw_users if u.strip()]

# 紧接着支持随机读取与切片
print("用户总数:", len(cleaned_users))
print("首位用户:", cleaned_users[0])
print("后两位用户:", cleaned_users[-2:])
2. 数据需要供多个下游函数或组件多次遍历
如果生成的数据集必须经历多道互不干扰的独立处理流程(例如先传递给统计函数计算方差,再传递给可视化组件绘图,最后序列化为JSON格式落盘),列表推导式生成的实体列表可以支持无限制的多轮迭代。
# 示例:多下游共享消费的指标集合
sensor_data = [18.2, 24.5, 30.1, 15.6, 28.4]
normalized_temps = [(t - 32) * 5 / 9 for t in sensor_data]

# 流程 1: 统计均值
avg_temp = sum(normalized_temps) / len(normalized_temps)

# 流程 2: 输出警报
alerts = [t for t in normalized_temps if t > 25.0]

# 流程 3: 绘制图表或数据持久化
# 实体列表能够反复进行多次迭代,不会产生耗尽问题
四、生成器的高效使用场景
生成器(包括生成器表达式与带有 yield 的生成器函数)在面对大规模数据集、无限数据流或单向数据管道时展现出压倒性的优势。它将空间复杂度直接降为常量 \(O(1)\),在有限的内存环境下依然能稳定处理几十GB甚至TB级的数据。
1. 超大文件或海量流式日志的逐行过滤与清洗
如果直接使用 [line.strip() for line in open('access.log')],当日志文件达到数GB时,整个物理内存会被瞬间占满导致系统触发OOM崩溃。改用生成器后,Python每次仅在内存中维护一行文本内容:
# 示例:处理庞大的Nginx访问日志
def parse_large_log(file_path):
    # 逐行读取大文件,生成器保证单行驻留内存
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            if "ERROR" in line:
                yield line.strip().split(" - ")

# 使用生成器表达式进行二级变换
error_logs = parse_large_log("server_huge.log")
error_codes = (parts[1] for parts in error_logs if len(parts) > 1)

# 仅消费前10个错误,不需要读取整个文件
for i, code in enumerate(error_codes):
    if i >= 10:
        break
    print(f"检测到错误码: {code}")
2. 配合即时聚合函数(sum、max、min、any、all)
当一个集合的终极目标只是计算统计指标(求和、极值、存在性判定)时,中间产出的元素并不需要保存。直接将生成器表达式作为单参数传递给内置聚合函数,不仅可以免去一层外层括号,还能利用短路特性提前结束运算。
# 高效做法:生成器表达式直接作为函数参数(无需双层括号)
# 内存复杂度 O(1),计算到第一个满足条件时立即短路退出
has_critical = any(item["level"] == "CRITICAL" for item in event_stream)

# 计算上亿个数字的平方和,不会创建任何临时列表
total_sum = sum(x * x for x in range(10_000_000))
3. 构建低耦合、低内存的流式数据处理流水线(Pipeline)
通过串联多个生成器,可以实现类似于Unix管道(cat file | grep | awk | sort)的处理架构。每个步骤只负责一种纯粹的转换,各阶段之间以惰性流动的方式协同运作。
五、常见反模式与避坑要点
在享受推导式与生成器带来简洁代码的同时,如果忽视了Python的语言特性,极易引发难以排查的隐蔽缺陷。以下是日常开发中最容易踩坑的三个关键反模式:
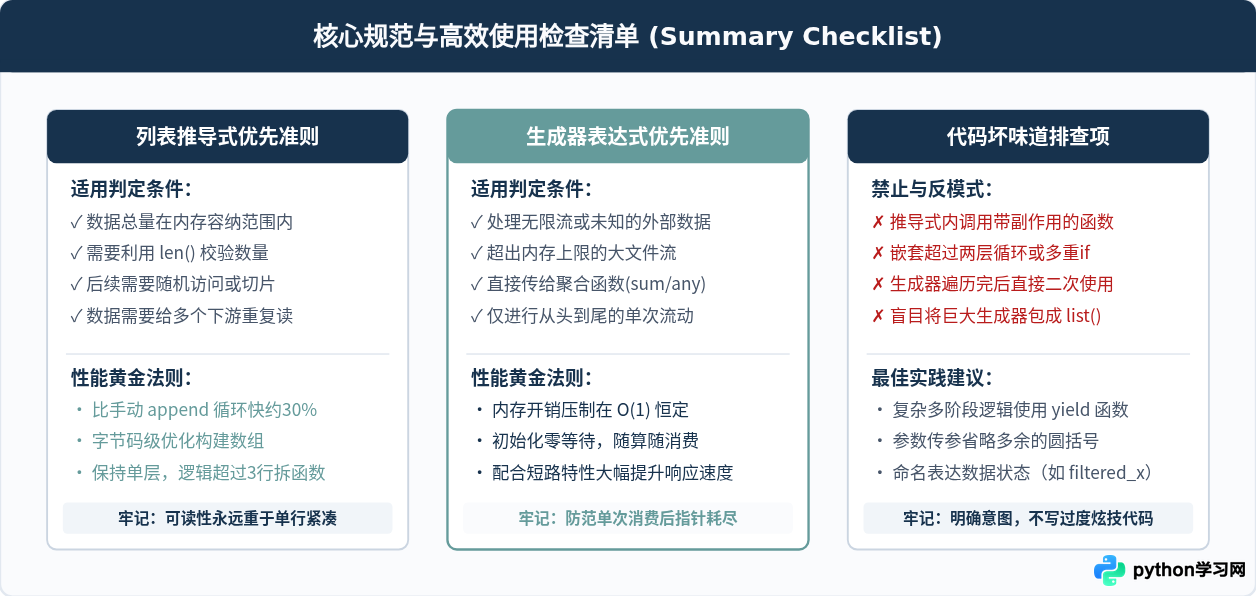
生成器是一次性消费品。一旦被遍历完毕,生成器的内部指针即停留在尾部,再次对其进行 for 循环或使用 in 判定时,将得到完全为空的结果,且不会抛出任何异常提示:
# 错误示例:误以为生成器能重复读取
gen = (x * 2 for x in [1, 2, 3])

if any(v > 4 for v in gen):  # 迭代进行到了 6,此时生成器已经耗尽
    print("存在大于4的值")

# 再次遍历时,循环体直接跳过,根本不会执行!
for val in gen:
print("输出:", val) # 此处什么都不会打印!修复方案:如果确实需要对数据进行多轮检查与使用,且数据量适中,请直接在初始阶段使用列表推导式;或者使用 itertools.tee 复制迭代器。
虽然Python语法允许在单行推导式中编写多层 for 和复杂的三元表达式,但一旦超过两层嵌套,代码可读性将断崖式下跌:
# 极差可读性反模式(避免使用):
result = [func(x, y) for row in matrix for x in row if x > 0 for y in range(x) if y % 2 == 0]

# 正确重构:拆分为清晰的常规循环,或提取为具名生成器函数
def filter_and_combine(matrix):
    for row in matrix:
        for x in row:
            if x > 0:
                for y in range(x):
                    if y % 2 == 0:
yield func(x, y)列表推导式与生成器设计的初衷是完成纯数据映射与过滤(Mapping & Filtering)。切忌在推导式内部调用修改外部全局变量、发送网络请求、向数据库插入记录或打印日志等带有副作用的函数。对于纯粹为了产生副作用的遍历,应老老实实编写传统的 for item in collection: do_something()。
六、选型与性能特征总结
为了在工程开发中能够快速决策,下表与结构总结图给出了列表推导式与生成器的核心参数对照:
| 对比维度 | 列表推导式 (List Comprehension) | 生成器表达式 (Generator Expression) |
|---|---|---|
| 语法特征 | [x for x in iterable] |
(x for x in iterable) |
| 求值时机 | 及早求值(定义即完成全量计算) | 惰性求值(按需通过 next() 计算) |
| 空间复杂度 | \(O(N)\)(线性扩展,受内存上限约束) | \(O(1)\)(恒定空间,仅保存当前状态) |
| 遍历能力 | 无限次重用、支持多轮迭代 | 一次性消费,遍历完毕后自动耗尽 |
| 访问特性 | 支持下标索引 [i]、切片 [:]、len() |
不支持下标与切片,无法获取长度 |
| 典型高效场景 | 中小型数据处理、图表输入、多次读取、快速切片 | 大文件流读写、海量数据清洗、单次聚合求值 (sum/any) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









