

Python初学者常见报错解析:缩进错误与编码问题怎么修
针对Python初学者高频遭遇的缩进错误(IndentationError/TabError)与编码报错(UnicodeDecodeError),深入剖析底层成因,给出清晰的排查流程、代码修复方案及主流编辑器标准化配置。
在刚刚学习 Python 的阶段,终端里突然跳出的一长串红色英文报错往往会打乱编写代码的节奏。这类报错虽然看起来复杂,但绝大多数都集中在语法规范与环境配置等基础环节。其中,缩进错误(IndentationError / TabError)与编码问题(UnicodeDecodeError / SyntaxError)是出现频次最高、也最容易让初学者感到困惑的两类故障。本文将分别拆解这两类报错的具体表象、背后的语法或底层机制,并给出明确的操作步骤与编辑器配置方法,帮助读者彻底理解并修复对应问题。
一、缩进错误的表现形式与结构关系
与 C、Java、JavaScript 等使用花括号 {} 界定代码块的语言不同,Python 采用所谓的“越位规则”(off-side rule),完全依赖空格或制表符的缩进深度来识别作用域与执行逻辑。这意味着缩进在 Python 中不仅是排版风格,更是语法本身的核心组成部分。当缩进的层次关系出现错位,解释器就无法准确判断语句归属,从而抛出异常。
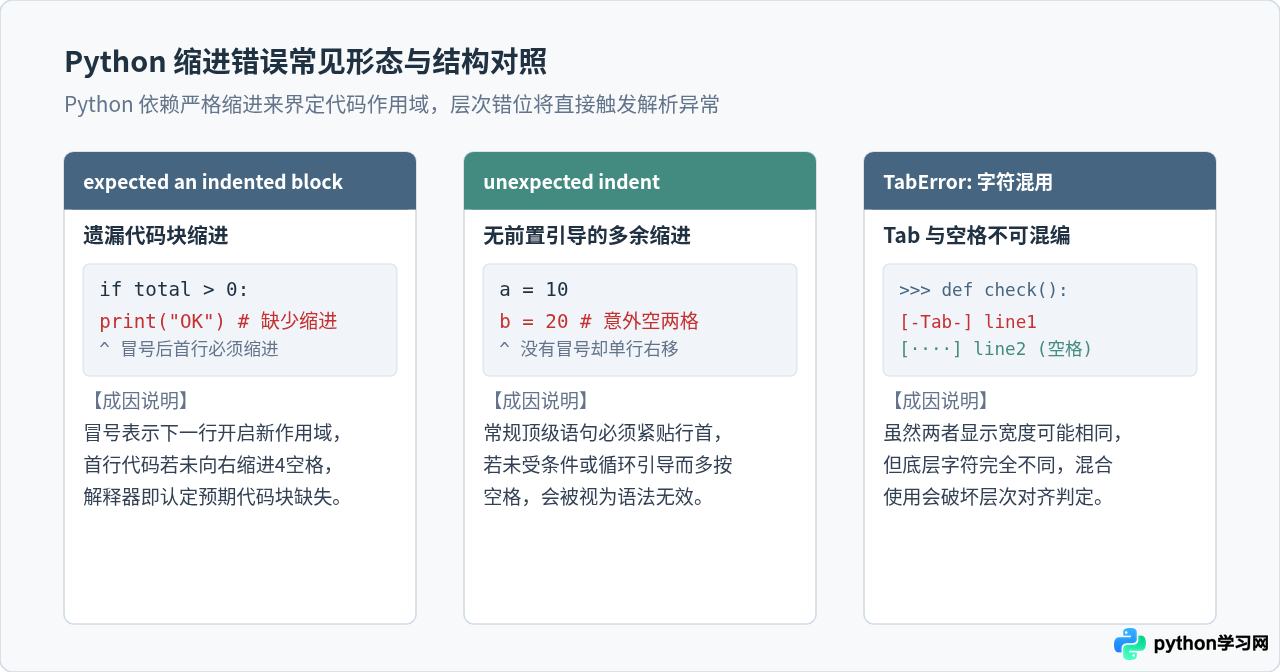
在日常编写代码时,缩进错误通常表现为以下三种经典报错:
IndentationError: expected an indented block:预期需要缩进的代码块缺失。常见于在if、for、while、def、class、try等带有冒号引导的控制语句下方,没有按下缩进,而是直接与上一行平级书写,或者语句下方只有空行而没有有效代码。IndentationError: unexpected indent:出现了意外的缩进。往往发生在不需要缩进的常规语句前多按了空格,或者在同一代码块内部,某一行意外比上一行向右偏移。TabError: inconsistent use of tabs and spaces in indentation:缩进混用了制表符(Tab)和空格。在肉眼观察时,Tab 和空格可能显示为完全相同的视觉宽度,但在 Python 3 解释器眼里,制表符是 1 个\t字符,空格是\x20字符,两者绝对不可在同一代码块中混用。
二、缩进问题的排查步骤与标准化修复
遇到缩进报错时,不要盲目通过随意敲击空格或删除缩进来尝试对齐。科学的排查步骤应当借助代码编辑器(如 VS Code、PyCharm)提供的可视化与格式化工具,从根源上规范代码结构。
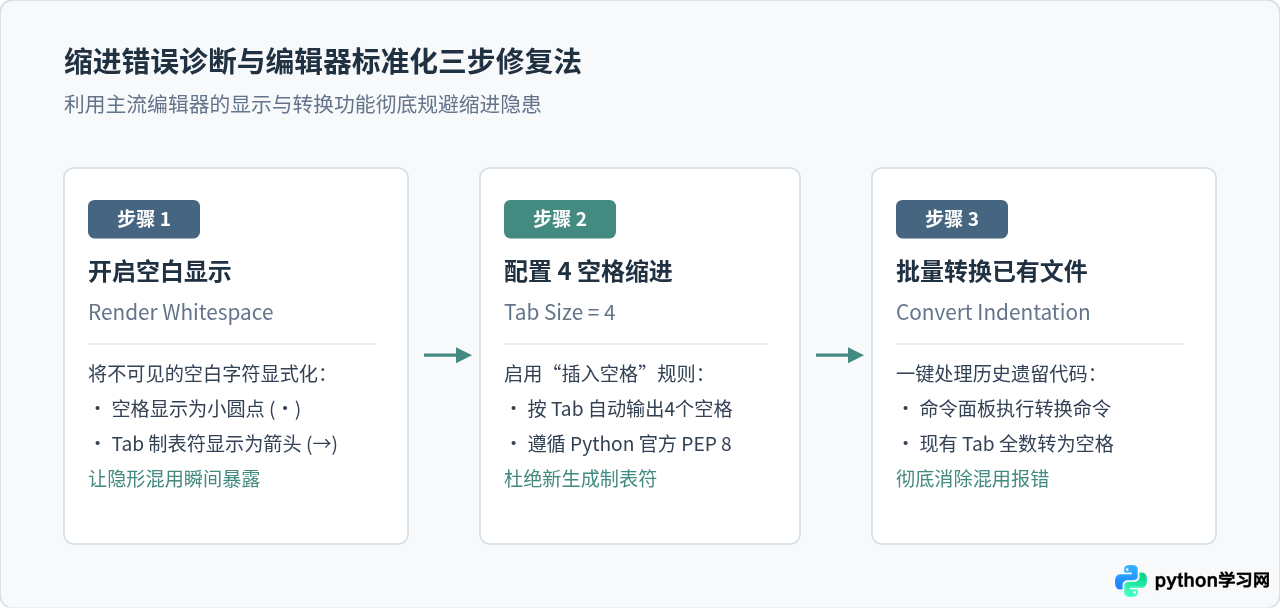
具体排查与修复流程分为三步:
- 第一步:开启“显示不可见字符”。在 VS Code 中,打开设置并搜索
Editor: Render Whitespace,将其值设为all;在 PyCharm 中,依次点击Preferences -> Editor -> General -> Appearance -> Show Whitespaces。此时,代码中的每个空格都会显示为一个灰色微小圆点,每个 Tab 则显示为一个箭头。一旦发现混用,肉眼便能一眼识别。 - 第二步:统一缩进规则为 4 个空格。根据官方 PEP 8 规范,Python 首选的缩进方式是每层固定使用 4 个空格,绝对禁止在同一项目中混用 Tab。在 VS Code 底部状态栏点击“空格/制表符长度”指示器,选择“使用空格进行缩进(Indent Using Spaces)”,并将宽度设定为 4;同时勾选“插入空格”选项,这样今后每次按下键盘 Tab 键时,编辑器都会自动输入 4 个空格,而不是输出
\t制表符。 - 第三步:全文件批量转为空格。若代码是从网路上复制或由不同成员协同编辑导致的混乱,在 VS Code 中按下快捷键
Ctrl+Shift+P(macOS 为Cmd+Shift+P),在命令面板中输入并执行Convert Indentation to Spaces(将缩进转换为空格),编辑器会自动把全文所有的 Tab 批量替换为标准数量的空格。
三、编码问题的本质与报错成因
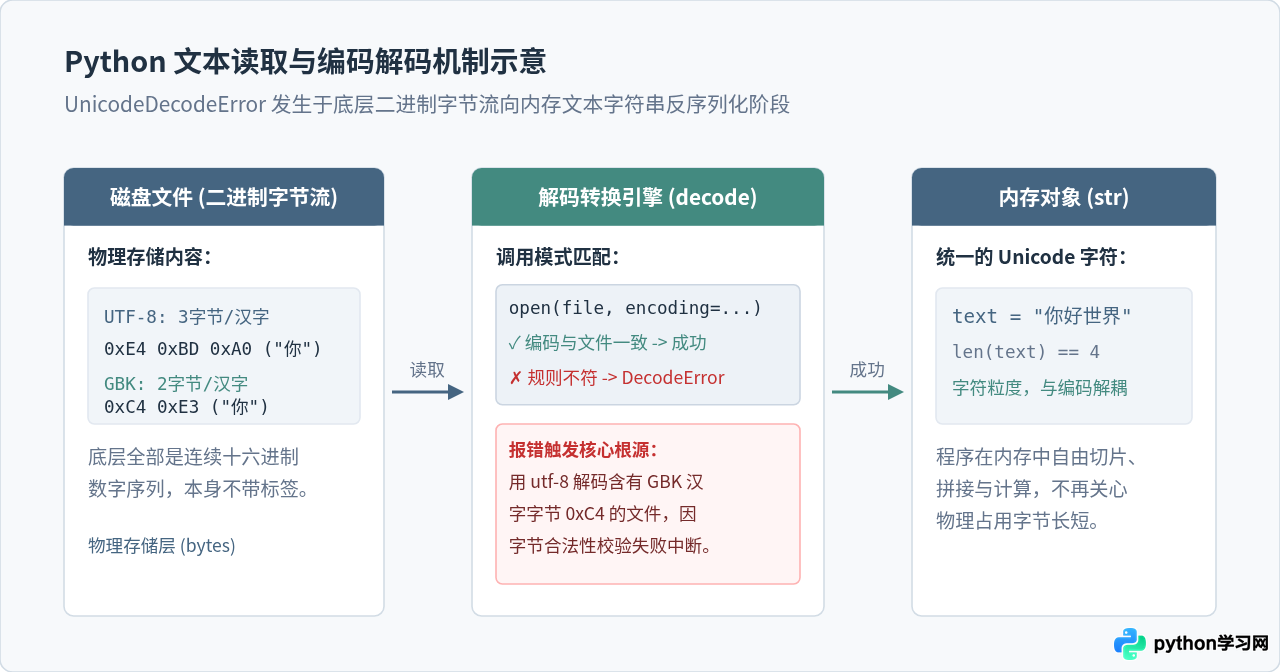
在 Python 3 中,语言对字符与字节做出了极其严谨的区分:内存中所有的文本均表示为 str 对象,内部采用 Unicode 统一字符集;而磁盘文件、网络传输或输入输出设备中传输的则是原始的二进制数据流,类型为 bytes。
从磁盘上的二进制字节还原为内存中的文本字符串的过程被称为解码(Decode);反之,将内存字符串保存为二进制文件的过程被称为编码(Encode)。最常见的报错正是发生在这个“解码”阶段:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc4 in position 0: invalid continuation byte这个报错的核心含义是:Python 正试图用 utf-8 的编码规范去逐个字节解析文件,但在遇到 0xc4 这个十六进制字节时,发现它完全不符合 UTF-8 编码的多字节前缀规则,于是立即抛出解码失败。
在 Windows 操作系统环境下,初学者极易遇到此类问题。这是因为 Windows 简体中文版系统的默认文件编码长期以来是 GBK / CP936,而现代开发工具与代码编辑器(如 VS Code、Sublime)默认使用 UTF-8 编码。当开发者在 Python 中使用内置的 open("data.txt") 打开文件但没有显式指定编码时,Python 会自动采用系统的默认编码(在 Windows 上默认往往是 gbk,在 macOS / Linux 上默认是 utf-8)。一旦文件的实际保存编码与 open() 默认采用的编码不一致,解码崩溃就会立刻发生。
四、编码报错的排查与标准化修复方案
理解了编码的映射机制后,修复编码问题就有了清晰的行动路径。通常需要从“代码文件本身”与“读写外部文件”两个场景分别落实:
1. 读写文本文件时显式声明编码(最佳实践)
在调用 open() 打开任何包含中文的文本文件时,永远不要省略 encoding 参数。显式传入 encoding='utf-8',可以避免代码在不同操作系统间迁移时依赖平台环境:
# 规范写法:显式指定 UTF-8 编码读取与写入
with open("dataset.txt", "r", encoding="utf-8") as f:
    content = f.read()

with open("output.txt", "w", encoding="utf-8") as f:
    f.write("输出中文结果")
如果读取由特定旧系统生成的 GBK 编码文件时报错,只需将参数明确指定为 encoding='gbk' 即可顺利解析:
# 处理特定 GBK 文件时的显式指定
with open("legacy_gbk.txt", "r", encoding="gbk") as f:
    content = f.read()
2. 容错回退机制(应对不规整或受损数据)
在网络爬虫或批量处理第三方日志时,文件内部可能偶尔夹杂一两个损坏的残缺字节。若不希望程序因为个别脏字节整体中断退出,可以通过 errors 参数设置容错策略:
errors='ignore':直接忽略无法解码的非法字节,跳过并继续向后解析。errors='replace':将无法识别的字节替换为标准替换符号?或,保留上下文位置。
# 使用 replace 保留大部分内容并避免崩溃
with open("messy_log.txt", "r", encoding="utf-8", errors="replace") as f:
content = f.read()errors='ignore' 只应作为读取非关键数据时的应急手段。对于关键业务数据,首选方案永远是查明文件的真实编码并精确匹配,否则可能导致数据无感知静默丢失。
3. Python 源码文件本身的编码声明
若在 .py 脚本源码中直接编写中文字符串或中文注释时提示 SyntaxError: Non-UTF-8 code present,说明代码文件本身未以 UTF-8 格式存储。虽然 Python 3 默认源码编码即为 UTF-8,但部分老版本编辑器可能将脚本存为 ANSI/GBK。此时可在脚本第一行显式添加魔法注释:
# -*- coding: utf-8 -*-
# 该声明告知 Python 解释器使用 UTF-8 规范来解析本脚本源码
name = "张三"
五、常见报错快速排查速查表与决策树
为了让读者在实际编码遇到报错时能以最短时间定位并解决问题,本节梳理出以下诊断决策树与高频报错特征对照表。
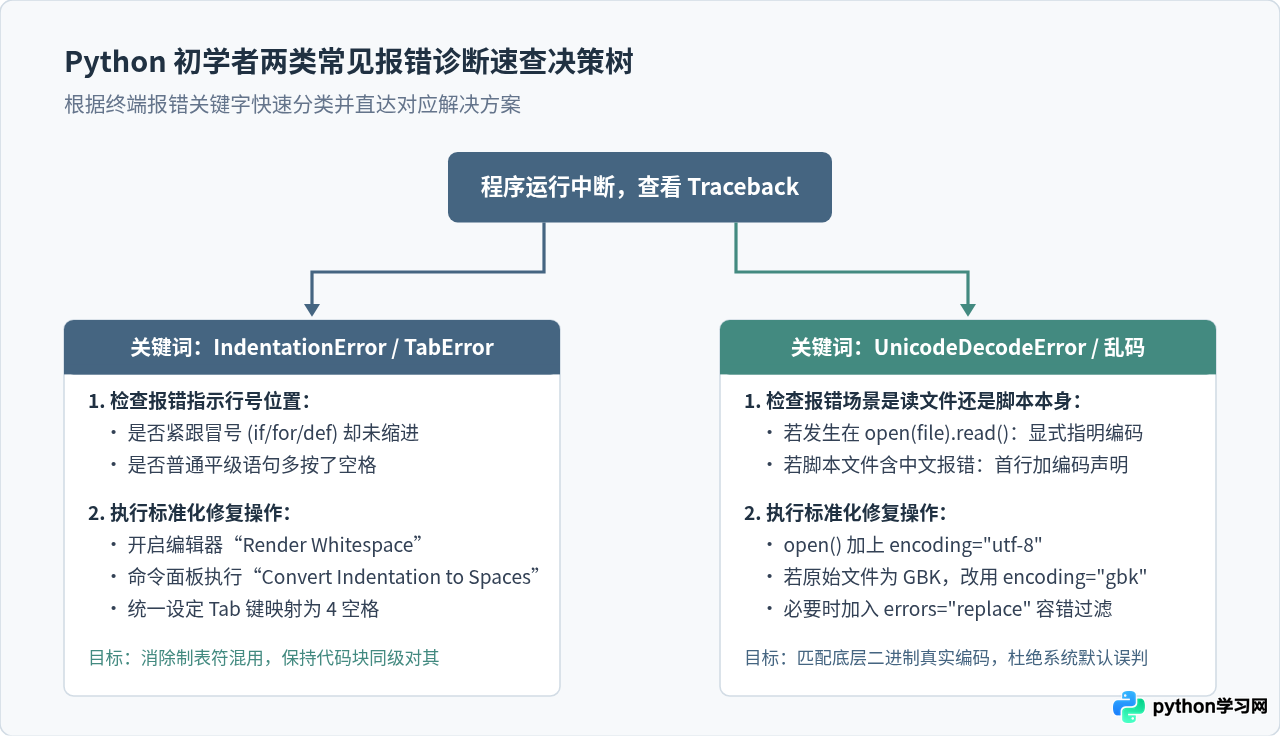
| 报错类型 | 典型错误提示信息 | 根本原因 | 直接修复对策 |
|---|---|---|---|
| 块缺失错误 | expected an indented block |
冒号后第一行未缩进,或分支内无内容 | 缩进 4 空格,或补充 pass 占位语句 |
| 意外缩进错误 | unexpected indent |
行首误加空格,或平级代码未对齐 | 删除行首多余空格,与前一行保持对齐 |
| 制表符混用 | inconsistent use of tabs and spaces |
同一层级代码中 Tab 与空格并存 | 执行全文件“Convert Indentation to Spaces” |
| 文件解码错误 | 'utf-8' codec can't decode byte ... |
以 UTF-8 方式读取了 GBK 或 ANSI 编码文件 | 在 open() 中显式传入正确的 encoding |
| 源码编码错误 | Non-UTF-8 code present ... |
.py 脚本源码文件本身非 UTF-8 编码 |
在脚本文件第一行添加 # -*- coding: utf-8 -*- |
总结来说,Python 的缩进要求和编码机制虽然在一开始显得有些苛刻,但其核心初衷是为了保证代码库的可读性与跨平台文本处理的一致性。初学者只要在日常开发中养成开启空白字符显示、全局统一 4 空格以及凡文件读写必显式传入 encoding 的好习惯,这两类报错便能从根本上得到彻底解决。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









