

云函数怎么执行python脚本阿里云函数计算
详细讲解在阿里云函数计算(Function Compute)中执行Python脚本的完整方法与底层逻辑,涵盖函数入口Handler配置、现有脚本无侵入接入、三方依赖打包、常见混淆点辨析及故障排查指南。
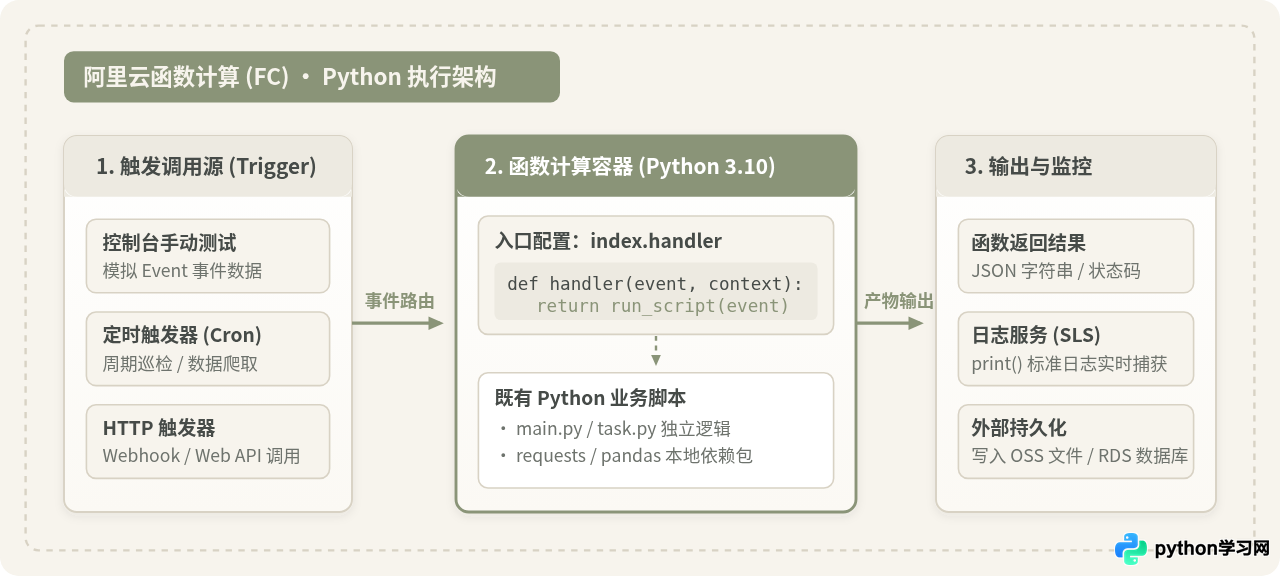
python script.py,而是由云平台在接收到调用事件后,动态导入你的代码模块并执行预先指定的函数入口(Handler)。要把本地或既有的 Python 脚本搬到云函数上运行,关键在于三个环节:在代码中声明合规的入口函数、把原业务脚本与第三方依赖合理打包,以及在控制台根据业务诉求选定对应的触发方式(如控制台手动测试、定时调度或 HTTP 接口调用)。
一、核心机制:云函数如何调用 Python 代码
很多开发者在初次将 Python 脚本部署到云函数时,最大的困惑往往在于:明明脚本在本地终端里运行正常,上传到云函数后却没有按预期执行,甚至直接报错退出。这背后的根源在于宿主执行机制的转变。
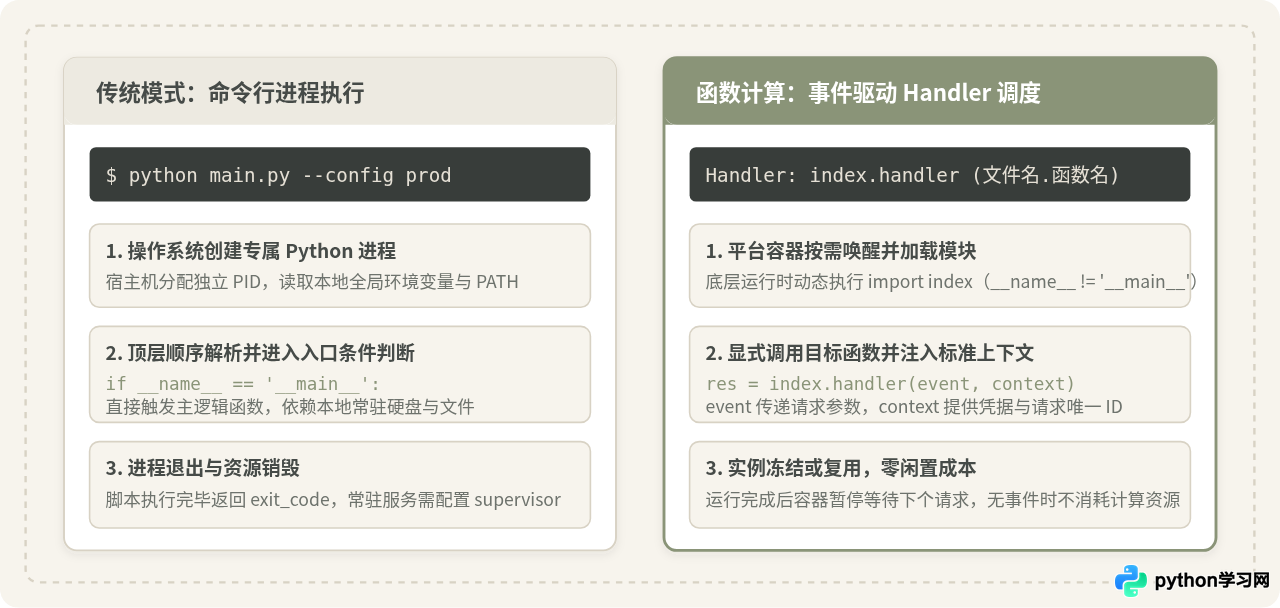
在常规服务器或本地电脑上,我们执行 Python 脚本的路径是:操作系统启动 Python 解释器进程,从上至下加载文件并执行顶层代码,通常由 if __name__ == '__main__': 条件块触发主逻辑。而在阿里云函数计算这样的 Serverless 环境中,底层实例由云平台统一维护与调度。当有请求到来时,平台运行时容器会像第三方模块一样执行 import 操作,并直接调用你在控制台配置的 Handler 函数。
为什么这种想法看似合理:因为在日常开发中,我们习惯于双击或通过命令行运行脚本,主入口都在该判断下方,本地测试顺理成章。
在云函数中为什么失效:函数计算环境是通过 Python 动态加载机制(如 importlib)加载你的脚本文件。在被其他程序导入时,模块的 __name__ 变量被赋值为模块文件名(例如 index),绝不会等于 '__main__'。因此,该判断块内的所有代码都会被直接略过。云函数执行完顶层变量声明后发现没有调用实际业务,表现为“毫秒级成功退出,但没有任何实际业务输出”。
正确的修正方式:将 if __name__ == '__main__': 下的核心逻辑抽离成独立的函数(例如 run_task()),并在云函数配置的 Handler 函数体内显式调用。
函数入口 Handler 的命名规则与参数约定
阿里云函数计算默认的入口格式为:文件名.函数名(例如 index.handler)。
- 文件名(index):代表代码包根目录下的
index.py文件(不需要写.py后缀)。 - 函数名(handler):代表
index.py内部定义的一个函数,通常形式为def handler(event, context):。
入口函数接收两个固定参数:
event(字节串或字符串):触发函数执行时传递的数据载荷。如果通过定时触发器执行,它包含定时器配置信息;如果是 HTTP 触发器,它包含请求正文或查询参数;如果是控制台测试,则是你在测试框中填写的 JSON 文本。context(对象):由函数计算运行时提供的上下文对象,包含当前请求的唯一 ID(context.request_id)、当前函数的临时访问密钥凭据(STS Token)以及函数运行剩余时间等信息。
二、控制台操作指南:从零创建并执行 Python 脚本
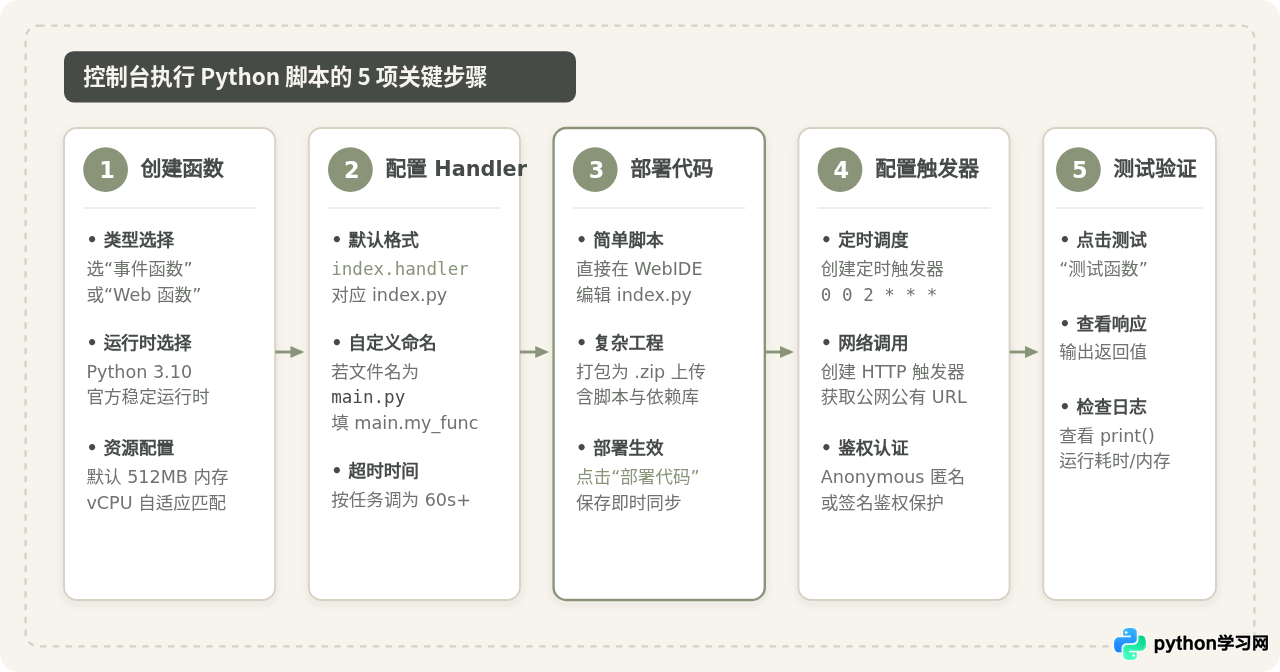
对于初次使用的开发者,直接使用阿里云函数计算 3.0 控制台是最直观的操作方式。以下是标准的操作顺序:
步骤 1:创建函数并选择运行时
登录阿里云控制台,搜索并进入“函数计算 FC”。在函数列表页面点击“创建函数”。在创建向导中,选择“事件函数”(适用于周期任务、离线批处理、爬虫脚本)或“Web 函数”(适用于对外暴露 HTTP 服务)。在运行时选项中,推荐选择官方稳定支持的 Python 3.10 或 Python 3.9。内存规格对于一般爬虫或处理脚本,设置 512 MB 即可满足需求。
步骤 2:配置函数入口与执行超时时间
在环境配置栏目中,确认“函数入口”项。如果使用默认模版,保持 index.handler 不变。若你的主脚本文件命名为 main.py,且内部执行函数名为 start_job,则需要在此处明确填入 main.start_job。
同时务必检查执行超时时间(Timeout)。函数计算新建时默认超时时间往往很短(通常为 3 秒或 60 秒)。若你的 Python 脚本涉及网络请求抓取、大规模数据计算或文件上传,执行时长超过设定值就会被系统强行终止并报超时错误。建议根据脚本预估时长将其调整为 120 秒至 300 秒。
步骤 3:在 WebIDE 中编写代码并部署
函数计算控制台内嵌了功能完备的 WebIDE。展开代码编辑器,找到 index.py,编写基础入口示例:
# -*- coding: utf-8 -*-
import json
import logging

# 初始化标准日志记录
logging.basicConfig(level=logging.INFO)
logger = logging.getLogger()

def handler(event, context):
    logger.info("云函数开始执行 Python 脚本...")

    # 解析传入事件(若有)
    evt_data = {}
    if event:
        try:
            evt_data = json.loads(event.decode('utf-8') if isinstance(event, bytes) else event)
        except Exception:
            evt_data = {"raw": str(event)}

    # 模拟业务处理
    processed_count = 42
    logger.info(f"成功处理任务,处理条数: {processed_count}")

    # 返回执行结果
    return {
        "statusCode": 200,
        "body": json.dumps({
            "message": "脚本执行完毕",
            "request_id": context.request_id,
            "processed": processed_count
        })
}代码编写完成后,点击编辑器上方的“部署代码”按钮。控制台会将代码即时保存到底层实例中。
步骤 4:执行测试与结果验证
在 WebIDE 界面上方点击“测试函数”。系统会立即发起一次调用。几秒钟后,下方“执行结果”标签页将展示执行状态:
- 状态:显示“成功”或“失败”。
- 函数日志:实时打印
logger.info()或print()的输出文本。 - 摘要指标:展示本次实际执行耗时(例如
Duration: 120 ms)与实际占用内存(例如Max Memory Used: 38 MB),这是后续评估运行成本的重要依据。
三、既有脚本接入:如何不改或少改原有代码
很多开发者手中已经有写好的独立业务脚本(比如 spider.py 或 export_report.py),重新按云函数语法大改代码往往费时费力。实际工程中,最推荐的做法是“轻量桥接模式”。
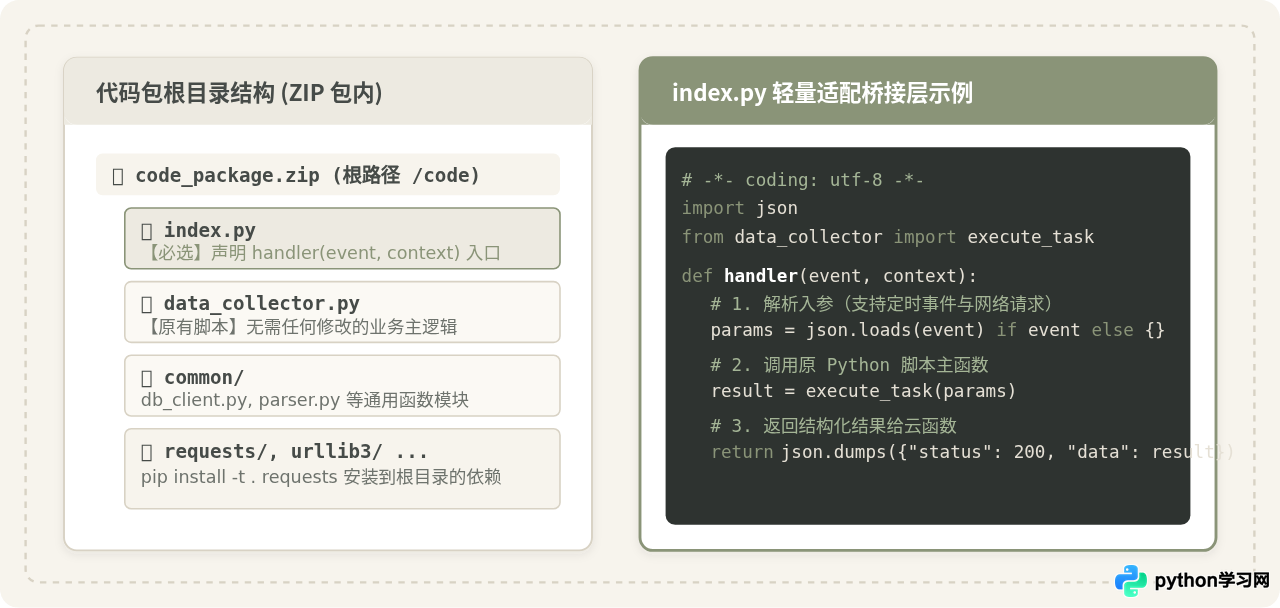
方案对比:改造方式与适用场景
| 方案类型 | 代码改造幅度 | 组织方式 | 适用场景 |
|---|---|---|---|
| 直接整合模式 | 中等:需将所有业务代码放入 handler 中 |
单文件(如仅保留一个 index.py) |
小于 100 行的轻量脚本,无复杂外部模块 |
| 适配桥接模式(推荐) | 极低:原脚本完全不改,只写 5 行桥接代码 | 多文件(index.py 作为调度网关导入既有脚本) |
已有完整业务脚本、依赖辅助工具类的工程项目 |
桥接模式具体实现
假设你的既有脚本为 export_report.py,其原始内容如下:
# export_report.py(既有业务脚本,保留不变)
import datetime

def generate_excel(task_type):
    print(f"[业务] 正在生成 {task_type} 报表,当前时间: {datetime.datetime.now()}")
    # 模拟耗时生成操作
    file_path = f"/tmp/report_{task_type}.xlsx"
    return file_path

if __name__ == '__main__':
    generate_excel("monthly")
接入云函数时,你不需要去动 export_report.py 的一行代码。只需在同级目录下新建一个 index.py 文件充当适配器:
# index.py(云函数专用入口文件)
import json
from export_report import generate_excel

def handler(event, context):
    # 解析传入的任务类型参数
    task_type = "daily"
    if event:
        try:
            payload = json.loads(event)
            task_type = payload.get("type", "daily")
        except Exception:
            pass

    # 直接调用原有脚本内的函数
    output_path = generate_excel(task_type)

    return {
        "code": 0,
        "message": "生成成功",
        "saved_path": output_path
    }
这样既保留了本地独立调试运行 python export_report.py 的能力,又能在云函数中由 index.handler 顺利调度。
四、第三方依赖包(pip)的安装与打包方式
当 Python 脚本需要用到 requests、pymysql 或 pandas 等外部三方库时,直接在代码里 import requests 会报 ModuleNotFoundError,因为云函数标准环境仅包含 Python 基础标准库。
方法一:本地安装到根目录并打包为 ZIP(最通用)
在本地终端中进入项目代码所在文件夹,使用 pip 的 -t . 参数将依赖直接安装到当前代码根目录下:
# 1. 进入脚本目录
cd my_fc_project

# 2. 将依赖库直接下载安装到当前文件夹内
pip install -t . requests pymysql

# 3. 检查目录结构,确认 requests 等文件夹已位于根目录下
ls -la

# 4. 压缩为 zip 文件(注意:必须在文件夹内部打包所有文件,不能将外层父目录打进去)
zip -r code.zip ./*
打包完成后,进入阿里云函数计算控制台,在代码页面选择“上传代码” -> “上传 ZIP 代码包”,上传刚生成的 code.zip 即可。
纯 Python 编写的库(如
requests、urllib3)在 Windows 或 macOS 上通过 pip -t . 下载可以直接在 Linux 云函数中运行。但如果依赖包含 C/C++ 编译扩展的库(例如 numpy、cryptography、gevent),在 Windows 或 Mac 本地下载的是对应系统的动态链接库(.dll 或 .dylib),上传到基于 Linux 系统的阿里云函数计算容器时会因架构不匹配而报错。对于此类依赖,建议在控制台直接使用“官方公共层(Layer)”,或者使用 Docker 的 Linux 容器执行 pip 安装后再打包。
方法二:使用函数计算的“层(Layer)”功能
在控制台函数配置界面的“层”配置项中,阿里云官方提供了大量开箱即用的公共依赖层,例如预置了常用科学计算包的 Python 运行库环境。绑定公共层后,你的业务代码包只需包含 index.py 和业务脚本,无需重复打包数十兆的庞大依赖,部署效率显著提高。
五、三种常用触发方式的配置
脚本部署就绪后,云函数不会无缘无故自行运转,必须为其配置触发器(Trigger)。根据业务场景的不同,主要分为以下三类:
1. 定时触发器(Timer Trigger):自动化定时任务
适合数据巡检、定时报表抓取、定期心跳打卡等离线场景。在控制台“触发器管理”中新建定时触发器,使用标准的 Cron 表达式指定周期。例如:
0 0 2 * * *:每天凌晨 2:00 自动触发执行一次;0 */30 * * * *:每隔 30 分钟周期性执行一次。
2. HTTP 触发器:构建对外 Web API 或接收 Webhook
适合需要由外部系统(如 GitHub Webhook、企业微信机器人回调、自建网站后台)主动通知执行的场景。创建 HTTP 触发器后,阿里云会分配一个专属的公网域名 URL。外部系统只需向该 URL 发起 POST 或 GET 请求,云函数就会立刻拉起实例执行 Python 脚本,并将 handler 的返回值响应给请求方。
3. 对象存储(OSS)事件触发器:自动化数据处理流水线
当有新文件(例如图片、CSV 数据表、日志归档)上传到绑定的 OSS Bucket 目录时,函数计算会自动捕获 oss:ObjectCreated:* 事件,将新文件的 Bucket 名称和 ObjectKey 通过 event 参数注入,触发 Python 脚本完成自动化解压、转码或清洗。
六、常见问题与排查指南
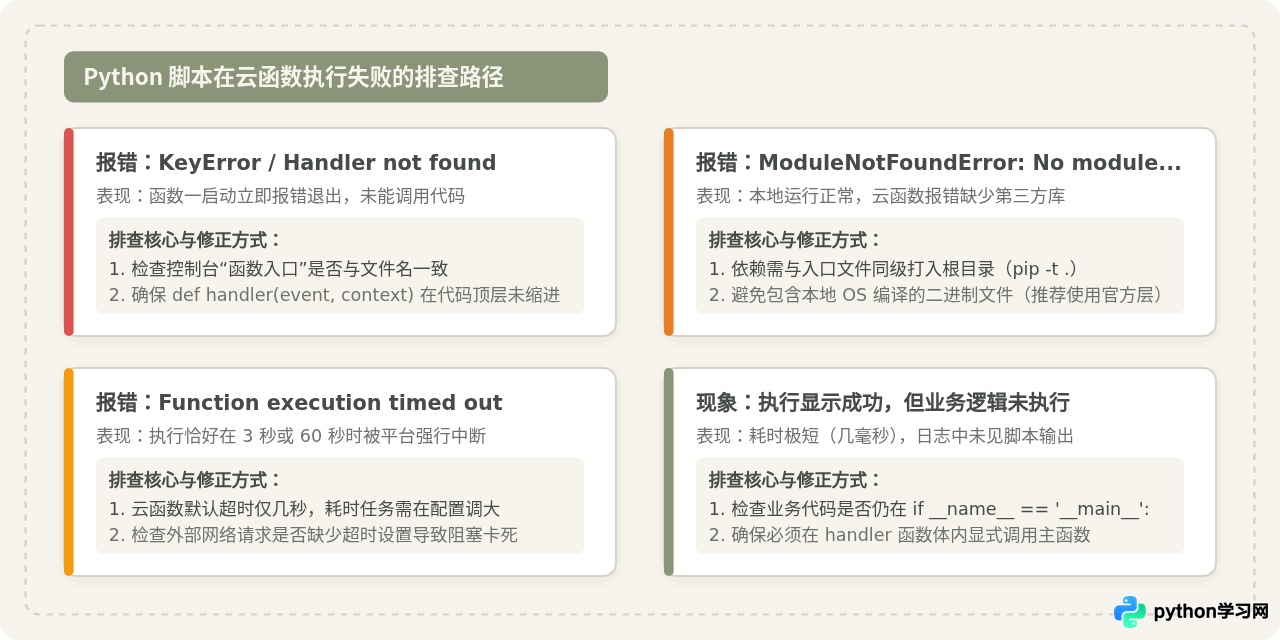
1. 报错 KeyError: 'handler' 或 Handler not found
原因:控制台配置的函数入口与实际代码定义不符。例如配置的是 index.handler,但你的文件名叫 main.py,或者 index.py 里写的函数名叫 def main(event, context):。
排查:核对控制台的“函数入口”字段,确保左半部分与根目录主文件名完全一致,右半部分与入口函数名大小写完全吻合;同时检查函数定义是否处于最外层顶格,未被错误缩进在其他类或代码块内。
2. 报错 Function execution timed out
原因:脚本未能在函数计算规定的 Timeout 窗口内完成。
排查:首先检查脚本内部是否有未加超时的外部 HTTP 请求(例如使用 requests.get(url) 未指定 timeout 参数),导致网络波动时线程永久阻塞;其次若业务本身为长耗时计算(如导出海量数据),在控制台基本设置中将超时时间调大(最大支持数千秒),并适当调大实例内存以获得更强的单核 CPU 性能。
3. 磁盘写入报错 Read-only file system
原因:在本地执行时,很多脚本习惯在当前工作目录下写日志或临时缓存文件(如 open("cache.txt", "w"))。在函数计算运行时中,代码根目录 /code 处于只读挂载状态以保证安全性,任何对当前目录的写操作都会被系统拒绝。
排查:云函数只开放了 /tmp 目录的临时可写权限。所有临时文件生成、Excel 导出、解压缓存均应放置在 /tmp/ 下(例如 open("/tmp/cache.txt", "w"))。需要注意的是,/tmp 目录随实例销毁而重置,若需长效保留数据,必须在脚本中上传至阿里云 OSS 或存入数据库。
总结
在阿里云函数计算中执行 Python 脚本是一套标准化的工程过程:理解底层以 Handler 函数代替传统命令行入口 的调用逻辑,通过轻量级包装保持既有业务代码的解耦与整洁,规范打包三方依赖,并结合具体业务选配合适的触发器。掌握这套机制后,无论是定时数据抓取、报表生成,还是轻量 Web 接口,都可以摆脱繁琐的服务器配置与常驻进程维护,平稳高效地运行在云端。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









