

Python中将字符串列转换为日期类型并提取数据的方法
本文系统讲解在Python数据分析中如何将DataFrame的文本字符串列高效转换为标准datetime64日期时间类型,并利用.dt访问器向量化提取年、月、日、时、分、星期及季度等核心特征。
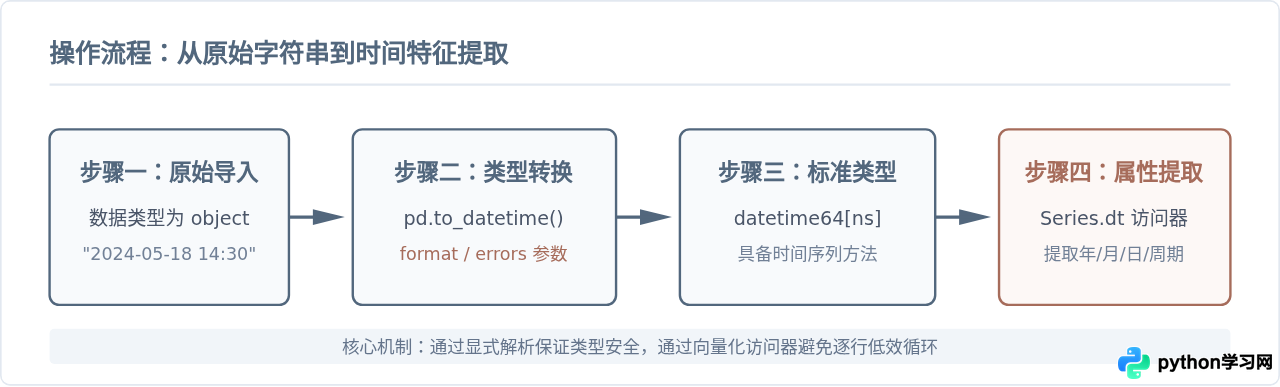
在处理外部表格、CSV文件或数据库导出的日志时,时间字段通常会以无序的纯文本形式载入为Pandas中的object或string类型。这种格式不仅占用更多内存,还无法直接进行日历运算、时间范围筛选与趋势聚合。解决该问题的标准路径是:先利用Pandas提供的pd.to_datetime()函数将目标字符串列转为标准的datetime64[ns]类型,再借助专门的时间序列访问器.dt向量化提取所需的年、月、日、时间刻度或日历周期。本文将通过具体的操作步骤、参数细节与常见异常诊断,完整说明从类型转换到数据提取的操作方法。
一、构建示例环境与识别原始数据类型
首先准备一段包含不同表现形式的示例数据。通过pandas.DataFrame创建一个包含注册时间、最后登录日期的表格,并查看各列的数据类型:
import pandas as pd

# 创建包含字符串日期的示例数据集
data = {
    'user_id': [1001, 1002, 1003, 1004],
    'register_time': ['2023-01-15 08:30:00', '2023-03-22 14:15:20', '2023-07-08 19:45:10', '2023-11-30 23:59:59'],
    'payment_date': ['2023/01/20', '2023/03/25', '2023/07/15', '2023/12/05']
}
df = pd.DataFrame(data)

# 打印各列原始类型
print(df.dtypes)
终端输出结果表明,register_time与payment_date均为object类型(在较新版本的Pandas中若启用PyArrow后端可能显示为string类型)。在object状态下,如果尝试使用切片字符串提取年份(例如df['register_time'].str[:4]),虽然能获得文本片段,但无法保证解析正确性,也无法直接执行求星期、计算时间差、判断季度等日历运算。
二、使用 pd.to_datetime 进行类型转换
将字符串转换为标准日期时间对象的核心函数是pd.to_datetime()。在实际业务中,由于原始数据格式各异并可能包含缺失或乱码文本,需要针对不同场景配置相应参数。
1. 基础自动推断与显式格式指定
对于符合ISO 8601标准格式(如YYYY-MM-DD HH:MM:SS)的文本,Pandas能够自动推断并转换:
# 自动推断转换
df['register_time'] = pd.to_datetime(df['register_time'])
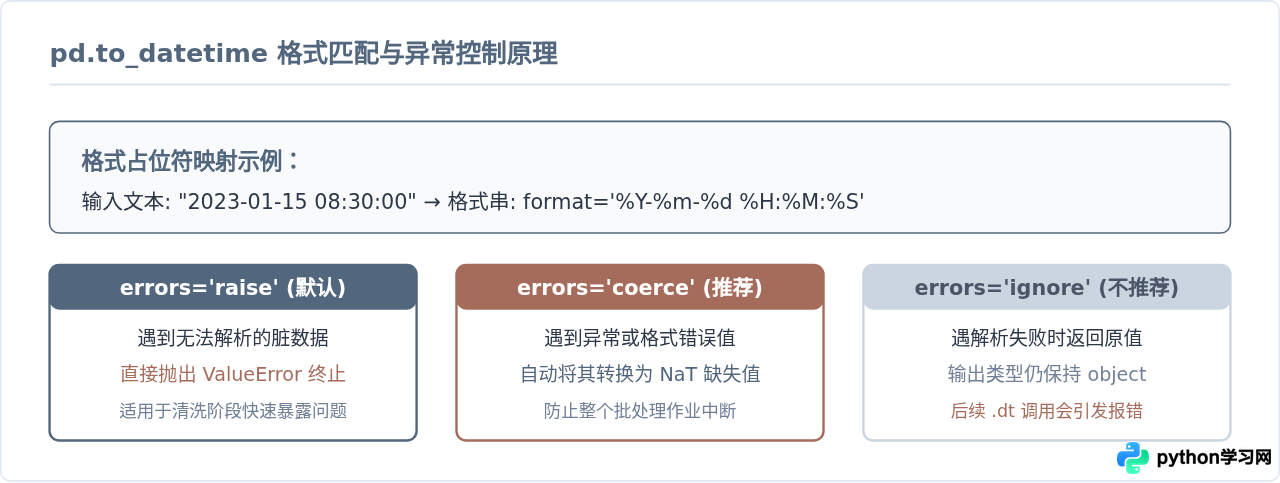
然而,当处理百万行级别的大型数据表时,自动推断会抽样分析字符串结构,造成明显的额外计算开销。此时显式传递format参数,不仅解析速度能提升数倍至数十倍,还能避免因日月顺序产生歧义(例如区分03/04/2023到底是3月4日还是4月3日):
# 显式指定匹配格式,兼具性能与精确度
df['payment_date'] = pd.to_datetime(df['payment_date'], format='%Y/%m/%d')
2. 容错转换:处理包含异常字符的脏数据
生产环境中的数据源常含有"无"、"null"或格式损坏的字符串。如果使用默认行为,程序会直接报错。配置errors='coerce'是数据清洗中的标准做法:
dirty_series = pd.Series(['2023-01-01', 'invalid_date', '2023-05-12'])
clean_dates = pd.to_datetime(dirty_series, errors='coerce')
print(clean_dates)
# 输出示例:
# 0   2023-01-01
# 1          NaT
# 2   2023-05-12
# dtype: datetime64[ns]
其中NaT(Not a Time)是Pandas中专门表示时间缺失值的标量,在后续数值统计时会自动忽略,不会破坏整列的数据类型。
三、使用 .dt 访问器提取日期时间数据
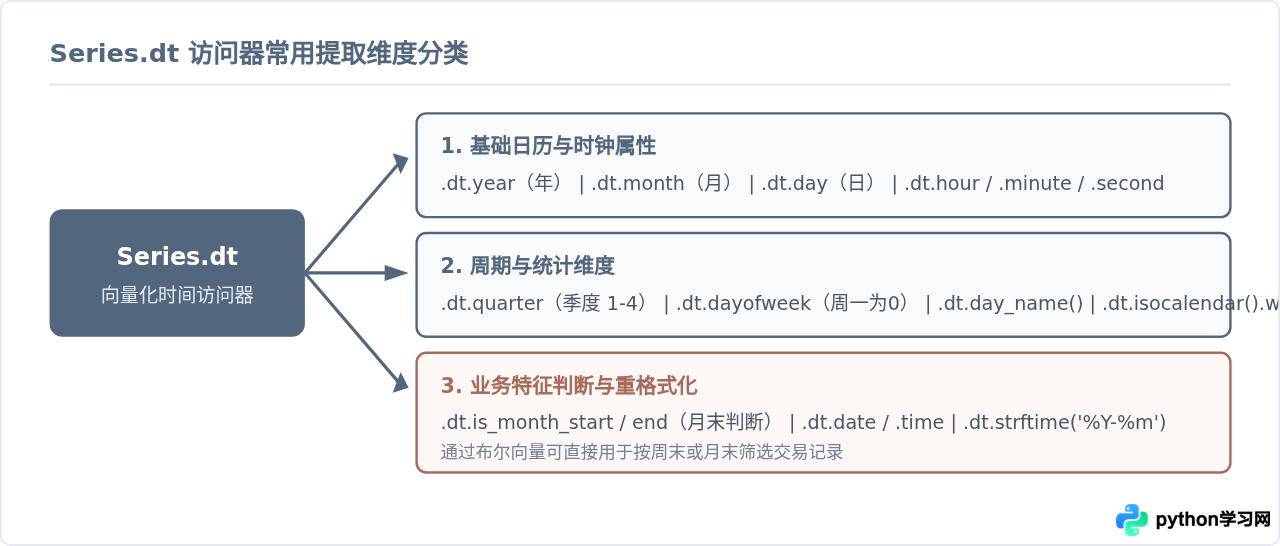
当某一列成功转换为datetime64[ns]类型后,该Series会获得名为.dt的专用访问器命名空间。它允许我们以高效的底层向量化方式,直接提取各类时间分量或衍生属性,完全不需要编写apply(lambda x: ...)或Python原生for循环。
1. 提取基础年月日与时间数值
提取后的新列为标准的整型数值(`int32`或`int64`),可以直接用于数值大小比较与分组汇总:
# 提取年份、月份、日期与小时
df['reg_year'] = df['register_time'].dt.year
df['reg_month'] = df['register_time'].dt.month
df['reg_day'] = df['register_time'].dt.day
df['reg_hour'] = df['register_time'].dt.hour

# 仅保留纯日期对象(类型变为 object 中的 datetime.date)
df['pure_date'] = df['register_time'].dt.date
2. 提取业务周期(星期、季度、周数)
在用户留存分析、节假日销量建模等场景中,需要进一步挖掘日期背后的周期属性:
# 提取所属季度(1, 2, 3, 4)
df['quarter'] = df['register_time'].dt.quarter

# 提取星期几:0 代表星期一,6 代表星期日
df['day_of_week'] = df['register_time'].dt.dayofweek

# 提取星期英文名称(如 Monday, Sunday)
df['day_name'] = df['register_time'].dt.day_name()

# 衍生特征:判断是否为周末(周六与周日返回 True)
df['is_weekend'] = df['register_time'].dt.dayofweek.isin([5, 6])

# 提取 ISO 标准周数
df['iso_week'] = df['register_time'].dt.isocalendar().week
3. 自定义格式化与周期截断
如果需要将日期重新输出为特定展示文本(如报表需要的“年月”聚合键),可以使用.dt.strftime();若需要对齐到月初或规范化去除时间分量,则可使用截断方法:
# 输出形如 "2023年01月" 的字符串
df['year_month_str'] = df['register_time'].dt.strftime('%Y年%m月')

# 将时分秒统一抹零(对齐到当天的 00:00:00)
df['date_normalized'] = df['register_time'].dt.normalize()

# 转换为 Period 周期类型以便进行月度聚合
df['month_period'] = df['register_time'].dt.to_period('M')
四、关键细节与避坑总结
在实际使用中,有几个细节往往会导致隐蔽的性能或逻辑错误:
避坑提示:避免对整个列执行 apply(lambda x: datetime.strptime(...))。Python层面的循环解析不仅会丢失Pandas向量化底层C实现的优化,还会使数百万行数据的处理耗时增加数十倍。始终优先使用 pd.to_datetime(df['col'], format='...')。
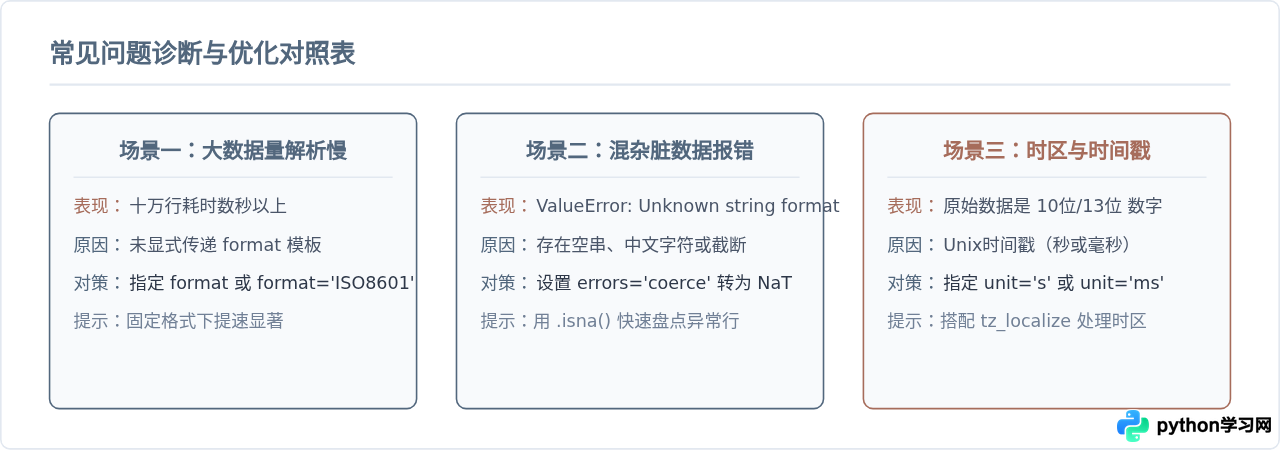
另外,当原始序列含有NaT缺失值时,提取出的整型分量(如年份、月份)在旧版Pandas中可能会被强制降级为浮点数(float64),这是因为原生的NumPy整型不支持NaN。若需要保留纯整数类型,可以在提取后将其转换为可空整型(如.astype('Int64'),注意大写I)。
掌握“pd.to_datetime(format=..., errors='coerce')进行规范化类型转换”与“.dt向量化属性访问提取特征”这两个核心步骤,就能安全、高效地应对数据分析项目中几乎所有与日期字符串相关的清洗与特征工程需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









