

NumPy2.5新增的降序排序函数在哪用?
全面解析NumPy 2.5中降序排序功能的使用位置、API架构与实战场景,解答为什么没有独立函数而是通过descending参数支持,以及如何在多维数组、Top-K与包含NaN的数据中正确调用。
np.sort_desc 或 np.descending_sort 的全新独立函数,但直接在命名空间中检索却一无所获。事实是:NumPy 2.5 并没有增加独立的新函数,而是直接在现有的排序核心接口(np.sort、np.argsort 以及数组对象的 ndarray.sort 方法)中正式引入了原生参数 descending=True。本文将详细说明这个功能的具体调用位置、解决的历史痛点以及在多维数组、Top-K 提取和含有缺失值时的典型使用方法。
核心解答:降序功能到底在哪个接口中?
在 NumPy 2.5 之前,NumPy 核心排序函数一直缺乏降序的直接原生参数。开发者要么先使用 np.sort() 正序排列后再通过 [::-1] 切片反转视图,要么通过将数值取负 np.argsort(-arr) 来曲线实现。随着 Python 数据 API 标准(Python Data API / Array API Standard)的推进,NumPy 2.5 正式将降序排序能力统一整合进现有排序族中。
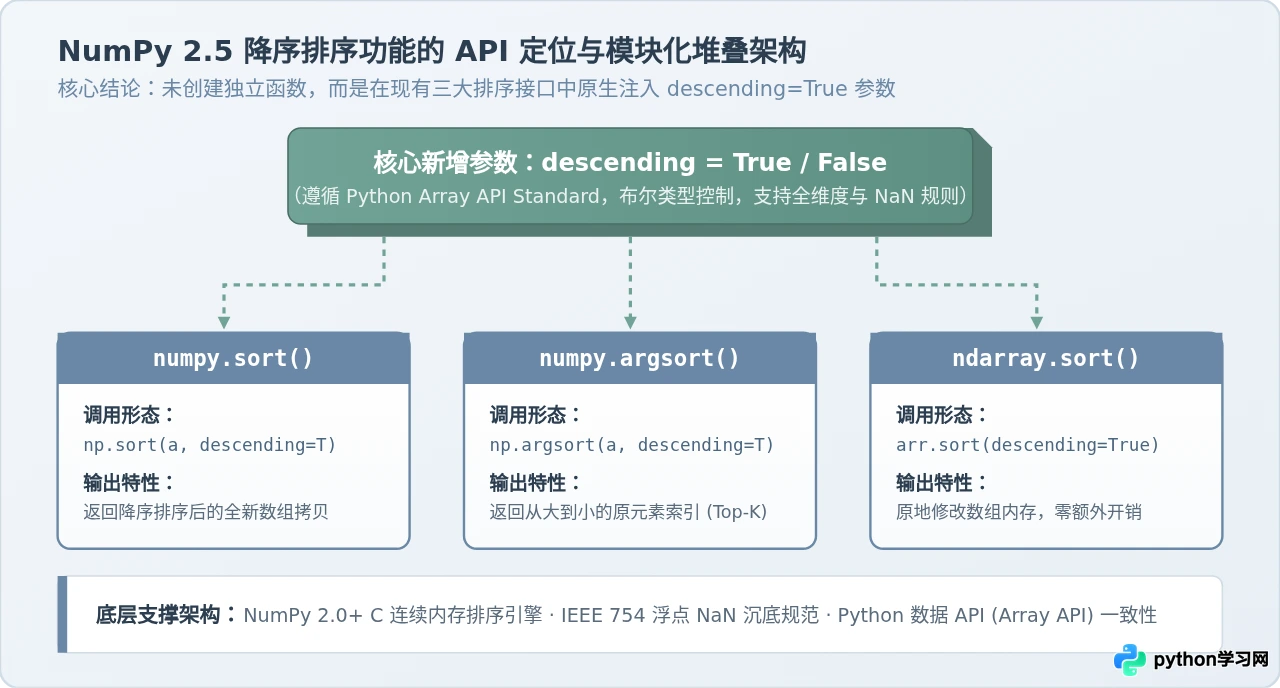
具体而言,你不需要导入任何新模块或寻找新函数名,降序能力直接体现在以下三个核心入口:
-
函数级数值排序:
numpy.sort(a, axis=-1, kind=None, order=None, stable=None, descending=False)
返回排序后的全新数组副本,当指定descending=True时,数组元素由大到小排列。 -
函数级索引排序:
numpy.argsort(a, axis=-1, kind=None, order=None, stable=None, descending=False)
返回由大到小排序对应的原始数据索引数组,直接服务于排名与关联重排。 -
数组实例原地方法:
ndarray.sort(axis=-1, kind=None, order=None, stable=None, descending=False)
直接在当前数组内存中原地执行降序修改,无需额外申请同等规模的内存空间。
降序排序在哪用?四大核心实战场景与代码示例
明确了参数位置后,更关键的问题是在日常数据处理中应该在哪里用它,以及它能解决哪些过去切片反转无法妥善处理的场景。
场景一:一维数组的直观单调降序
最基础的场景是对一维成绩、指标或时间戳进行逆序排列。以往使用 np.sort(scores)[::-1] 虽然代码看似简短,但本质上是两阶段操作(排序后生成负步长视图)。在 NumPy 2.5 中,直接通过参数一步到位:
import numpy as np

# 示例一维数组
scores = np.array([68.5, 92.0, 74.0, 88.5, 95.0, 81.0])

# 原生降序排序(示例输出)
sorted_scores = np.sort(scores, descending=True)
print(sorted_scores)
# [示例输出] array([95. , 92. , 88.5, 81. , 74. , 68.5])
场景二:多维数组沿特定轴降序(解决高维切片复杂性)
多维数组排序是旧写法最容易产生混淆的地方。例如对一个二维特征矩阵按每一行分别降序排列,过去如果写 np.sort(data, axis=1)[:, ::-1],必须手动在切片中对齐轴的位置;如果是三维或四维张量,手动书写负步长切片极其繁琐且极易出错。
使用 descending=True 参数,只需将 axis 与 descending 配合传入,内部排序引擎会自动在指定轴向量上完成逆序装配,不再需要任何维度的切片转换:
matrix = np.array([
    [12, 45, 23],
    [56, 18, 34]
])

# 沿每一行(axis=1)进行独立降序
row_desc = np.sort(matrix, axis=1, descending=True)
print(row_desc)
# [示例输出]
# array([[45, 23, 12],
#        [56, 34, 18]])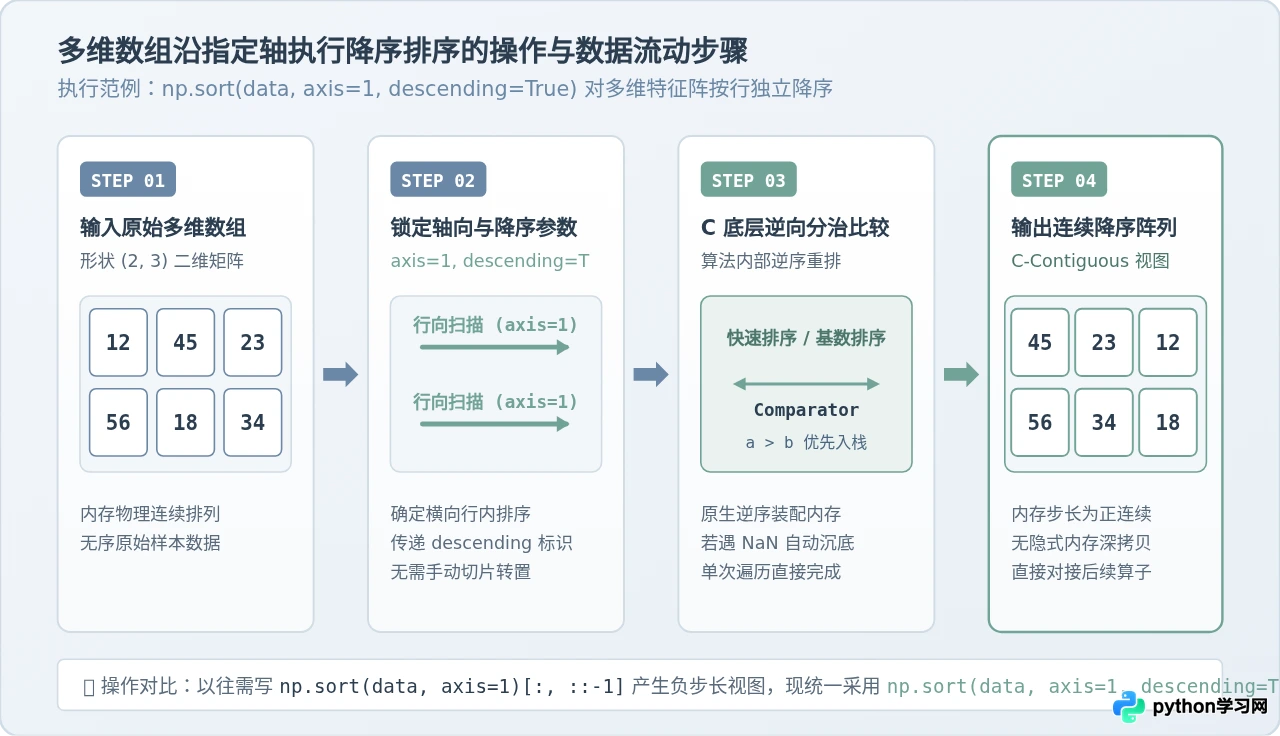
场景三:Top-K 样本提取与关联索引筛选
在推荐系统、排序模型和召回评估中,经常需要找出指标最高的前 $K$ 个样本并保留其在原数据中的索引。在旧版本中,开发者通常用 np.argsort(scores)[::-1][:k] 或者 np.argsort(-scores)[:k]。
这两种旧做法各有隐患:前者在截取前需要构造完整反向切片;后者对浮点数或整型可能产生意外溢出。通过 np.argsort(..., descending=True) 可以直接获取降序排列的原始序号,安全且直观:
feature_values = np.array([10.2, 55.4, 23.1, 89.0, 4.8, 77.3])

# 直接获取由大到小的排位索引,提取前 3 名
top_3_indices = np.argsort(feature_values, descending=True)[:3]
print("Top 3 索引:", top_3_indices)
print("对应数值:", feature_values[top_3_indices])
# [示例输出]
# Top 3 索引: [3 5 1]
# 对应数值: [89.  77.3 55.4]
场景四:含特殊值(NaN)的浮点数据降序(关键边界优势)
这是原生 descending=True 带来最根本质量提升的场景。在 IEEE 浮点规范中,NaN 无法与普通数值进行常规大小比较。在 NumPy 升序排序中,NaN 默认会被放置在数组的末尾。
如果你在旧版本中使用 np.sort(arr)[::-1],逆序切片会将原本放在末尾的 NaN 强行反转到了序列的最开头,导致最大值变成了 NaN,这在统计与过滤任务中是致命的逻辑错误;若使用 -arr 取负,-np.nan 依然是 NaN,排序逻辑彻底混乱。
NumPy 2.5 的 descending=True 严格遵守 Array API 规范:无论升序还是降序,所有 NaN 均固定排在有效数值之后(即数组最末尾):
data_with_nan = np.array([3.2, np.nan, 15.6, 1.4, np.nan, 8.9])

# 原生降序:有效数值从大到小,NaN 依然沉底在末尾
clean_desc = np.sort(data_with_nan, descending=True)
print(clean_desc)
# [示例输出] array([15.6,  8.9,  3.2,  1.4,  nan,  nan])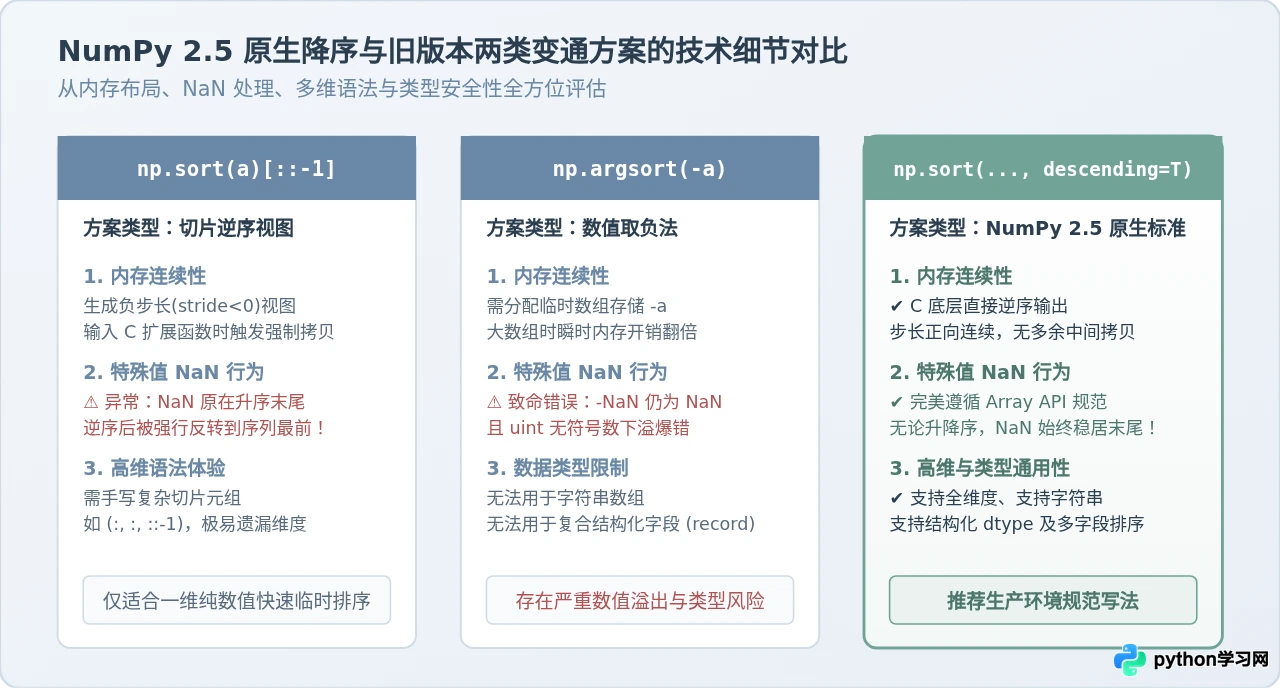
深层机制:为什么原生参数优于切片反转?
除了语法清晰与 NaN 边界安全外,NumPy 官方引入 descending 还有深层次的底层内存与执行效率考虑:
-
内存布局与连续性(Contiguity):
arr[::-1]返回的是步长为负数(负 stride)的非连续视图(Non-contiguous view)。当该视图后续传递给依赖 C-Contiguous 内存的高性能计算库(如 Cython 扩展、PyTorch 张量转换或 BLAS 底层库)时,系统往往不得不隐式调用ascontiguousarray进行一次全量数据拷贝,抵消了切片看似零拷贝的优势。而descending=True直接在 C 排序引擎输出时生成正步长的连续内存。 -
原地排序内存节省: 对于数十 GB 的超大数组,过去无法直接实现原地降序,必须先升序后再反转视图赋值。现在通过
arr.sort(descending=True),能够在原内存块上就地完成降序重排,完全不占用额外内存。 -
跨库生态统一: PyTorch、JAX 等现代深度学习计算框架遵循 Array API 规范,广泛支持
descending=True参数。NumPy 2.5 的对齐使得同一套数据管道代码可以无缝跨设备与框架复用。
避坑提醒与版本兼容写法
在使用该功能时,有两个非常容易犯错的细节需要注意:
Python 内置列表的排序方法是 list.sort(reverse=True) 或 sorted(iterable, reverse=True),但 NumPy 遵循的是 Array API 规范,参数名称严格为 descending。如果写成 np.sort(a, reverse=True),解释器会抛出 TypeError: sort() got an unexpected keyword argument 'reverse'。
如果在生产代码库中需要同时兼容 NumPy 1.x、NumPy 2.0~2.4 与 NumPy 2.5+,直接传入 descending=True 会在旧版本中报错。建议在基础工具库中封装兼容函数:
def safe_sort_desc(arr, axis=-1):
    """兼顾 NumPy 新旧版本的安全降序排序"""
    try:
        # 优先尝试 NumPy 2.5 原生参数
        return np.sort(arr, axis=axis, descending=True)
    except TypeError:
        # 旧版本降级策略:沿指定轴反转切片并确保连续内存
        sorted_asc = np.sort(arr, axis=axis)
        slice_tuple = [slice(None)] * arr.ndim
        slice_tuple[axis] = slice(None, None, -1)
        return np.ascontiguousarray(sorted_asc[tuple(slice_tuple)])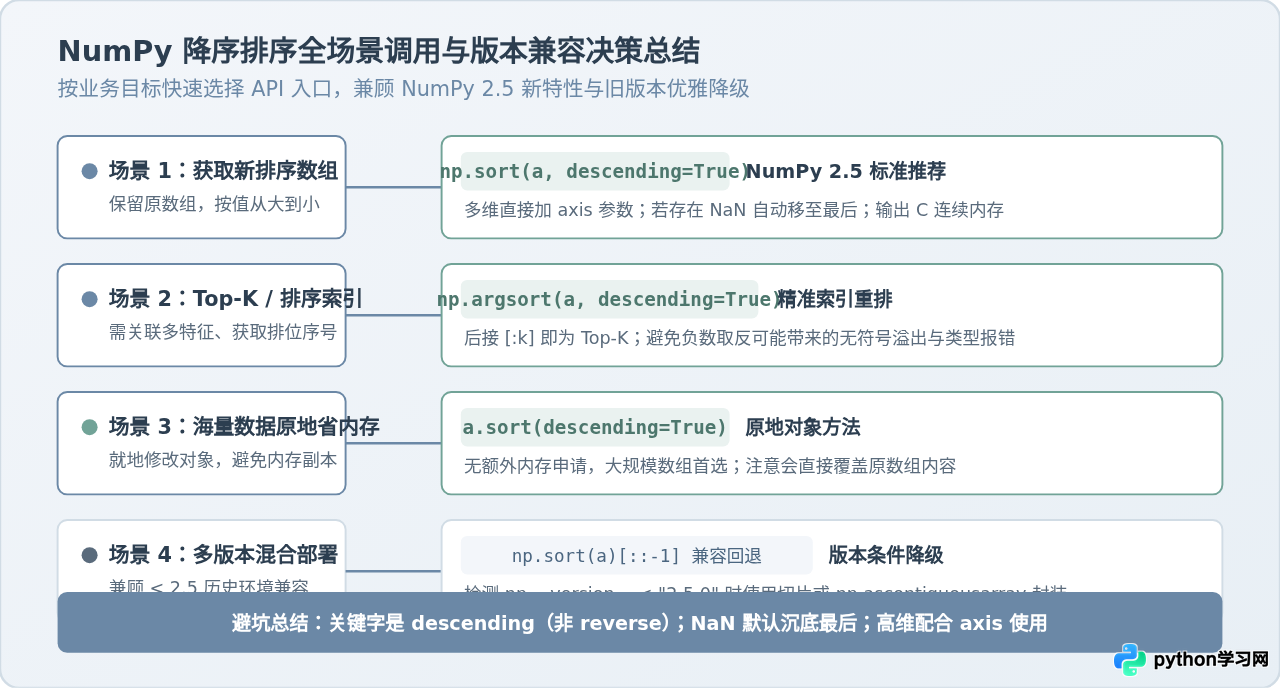
常用排序操作速查表
| 需求场景 | NumPy 2.5+ 推荐写法 | 旧版本兼容替代 | 内存行为 |
|---|---|---|---|
| 一维数组降序 | np.sort(a, descending=True) |
np.sort(a)[::-1] |
返回全新连续数组 |
| 多维沿行降序 | np.sort(a, axis=1, descending=True) |
np.sort(a, axis=1)[:, ::-1] |
正步长 C 连续输出 |
| Top-K 索引提取 | np.argsort(a, descending=True)[:k] |
np.argsort(a)[::-1][:k] |
整数索引数组 |
| 原地省内存降序 | a.sort(descending=True) |
a.sort(); a[:] = a[::-1] |
就地修改,零额外内存 |
| 含 NaN 数据降序 | np.sort(a, descending=True) |
需先掩码隔离 NaN 才能反转 | NaN 自动保证沉底末尾 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









