

pandas2.1到2.3期间Copy-on-Write是怎么逐步推进的?
全面梳理 pandas 2.1 到 2.3 期间 Copy-on-Write(写时复制)机制的演进历程与推进策略。详细讲解 warn 模式探测、inplace 参数弃用、链式赋值拦截与内存优化机制,并提供系统化的存量代码平滑迁移指南。
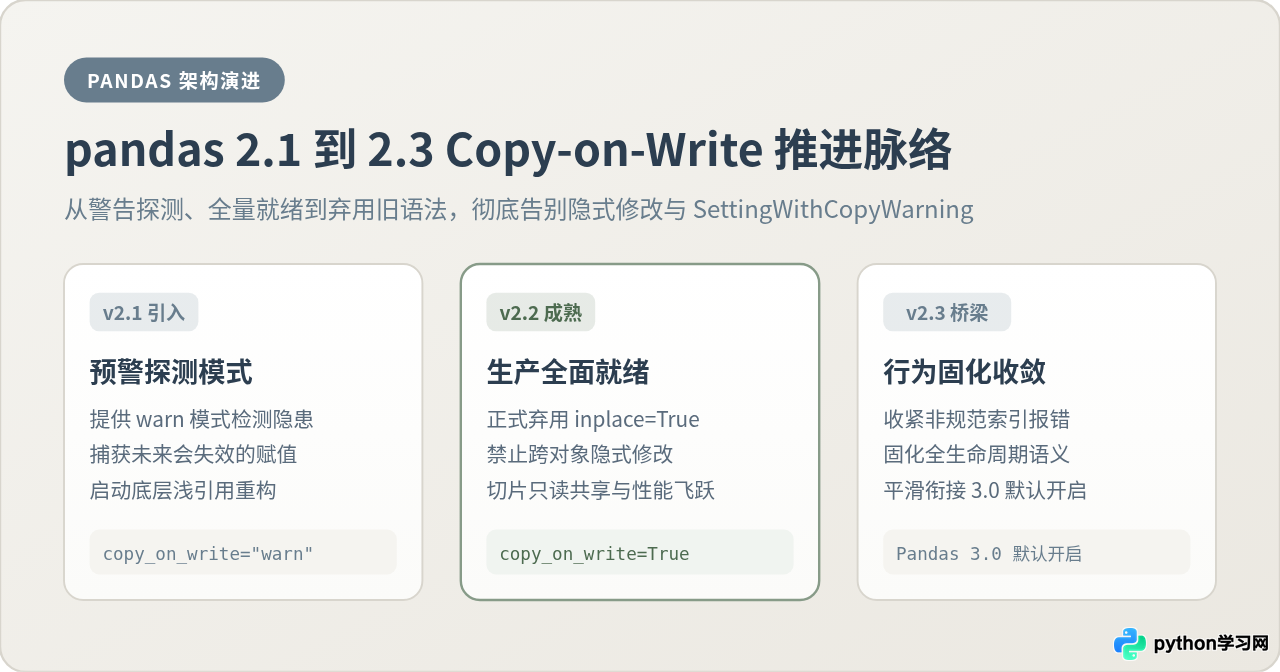
SettingWithCopyWarning。从 2.1 到 2.3 版本,pandas 团队采取了“警告探测—全面稳定与弃用旧语法—平滑过渡至默认”的三阶段递进策略:2.1 引入 "warn" 模式帮助开发者定位隐患代码,2.2 达到生产可用并系统性弃用 inplace=True 与链式赋值,2.3 进一步收紧行为预期并完善向 3.0 默认开启的迁移支持。
一、为什么需要 CoW:传统机制与 CoW 的核心差异对照
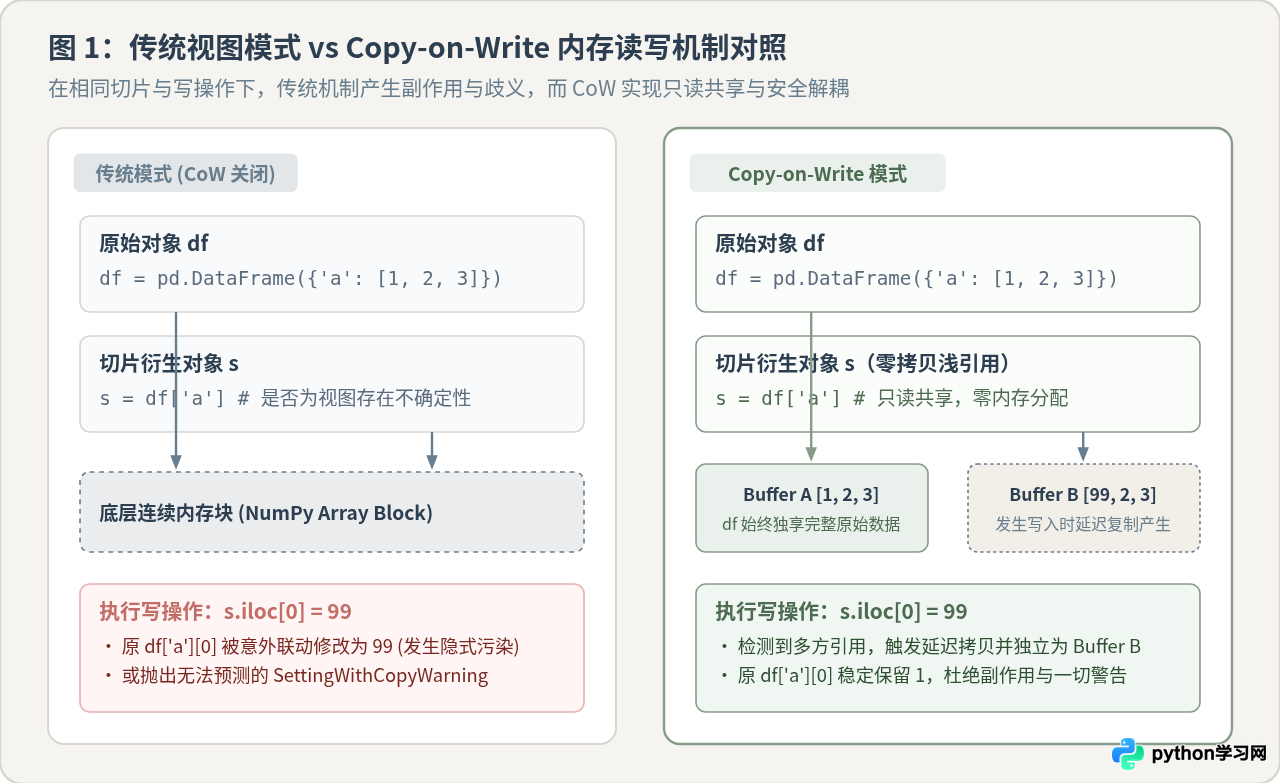
长期以来,pandas 的索引与切片机制一直困扰着开发者:对一个 DataFrame 执行切片并修改时,它究竟返回底层数据的“视图(View)”还是独立的“副本(Copy)”?在传统实现中,这一行为是不确定的——当底层连续内存布局匹配时可能是视图,而发生多列拼接或类型非对齐时又会退化为深拷贝。这种不确定性导致了令人费解的 SettingWithCopyWarning 以及难以追查的跨对象数据污染 bug。
为了直观理解这一痛点,我们选择“子集切片后直接修改元素”这一标准场景,在相同的运行输入下对比传统模式与 Copy-on-Write 模式的关键差异:
| 对比维度 | 传统模式(CoW 关闭) | Copy-on-Write 模式 |
|---|---|---|
| 切片创建语义 | subset = df['col'] 内部行为不透明,既可能共享内存,也可能在毫无提示下发生浅拷贝或深拷贝。 |
subset = df['col'] 严格为零拷贝引用,立即建立轻量引用计数指针,完全共享底层只读 Buffer。 |
| 写操作后果 | 执行 subset.iloc[0] = 99 时,若原为视图,将直接篡改母表 df 的数值;若原为副本则不影响母表,极易造成静默隐患。 |
写操作发生时,检测到引用计数大于 1,立即触发单列延迟拷贝。母表 df 维持原样,subset 拥有独立新内存。 |
| 警告与稳定性 | 频繁抛出语义模糊的 SettingWithCopyWarning,迫使开发者到处滥用 .copy() 防御性代码。 |
行为绝对可预测,完全废除 SettingWithCopyWarning,无跨对象副作用。 |
| 内存与执行效率 | 为防止隐式污染,链式操作中往往发生不必要的完整深拷贝,内存峰值居高不下。 | 所有派生对象默认共享内存,仅在发生写操作时按列复制,复杂管线内存开销显著降低 50% 以上。 |
这个差异之所以至关重要,是因为它从根本上重塑了 pandas 对象的生命周期。在 CoW 体系下,任何衍生对象在被修改时绝不会反向“污染”产生它的父级对象。这种不可变性保障了代码的数学确定性。
二、pandas 2.1:引入 warn 模式与潜在破坏性行为探测
在 2023 年秋季发布的 pandas 2.1 中,核心任务不是强行切换默认行为,而是提供无侵入的静态预警机制。为此,pandas 2.1 引入了 pd.options.mode.copy_on_write = "warn" 选项。
在 "warn" 模式下,代码仍旧按照传统模式执行原有逻辑,但一旦执行了在未来 CoW 默认开启后行为会发生改变的语句(例如链式索引赋值、或者切片修改依赖视图穿透),pandas 会立即抛出明确的运行期警告。这让大型数据工程团队能够在不改动线上输出的前提下,通过测试流水线快速定位存量项目中的隐患代码。
2.1 中的典型探测示例
import pandas as pd

# 开启 2.1 引入的预警探测模式
pd.options.mode.copy_on_write = "warn"

df = pd.DataFrame({"group": ["A", "A", "B"], "val": [10, 20, 30]})

# 场景 1:危险的链式赋值
# 在旧版中该语句可能成功修改 df,也可能因副本而失效
df["val"][0] = 999

# 场景 2:切片对象修改
subset = df[df["group"] == "A"]
subset["val"] = 0copy_on_write="warn" 时,警告信息的目的是定位问题而非直接修复。此时切勿仅通过 warnings.filterwarnings('ignore') 掩盖警告,否则在升级到未来版本时,代码中的隐式修改逻辑将直接失效。
三、pandas 2.2:生产就绪与系统性弃用 inplace=True
2024 年初发布的 pandas 2.2 标志着 Copy-on-Write 已经达到了生产级成熟度。核心开发团队完成了所有核心数据结构(BlockManager、SingleBlockManager)对引用计数和浅引用的重构,正式将 pd.options.mode.copy_on_write = True 推荐为生产候选配置。
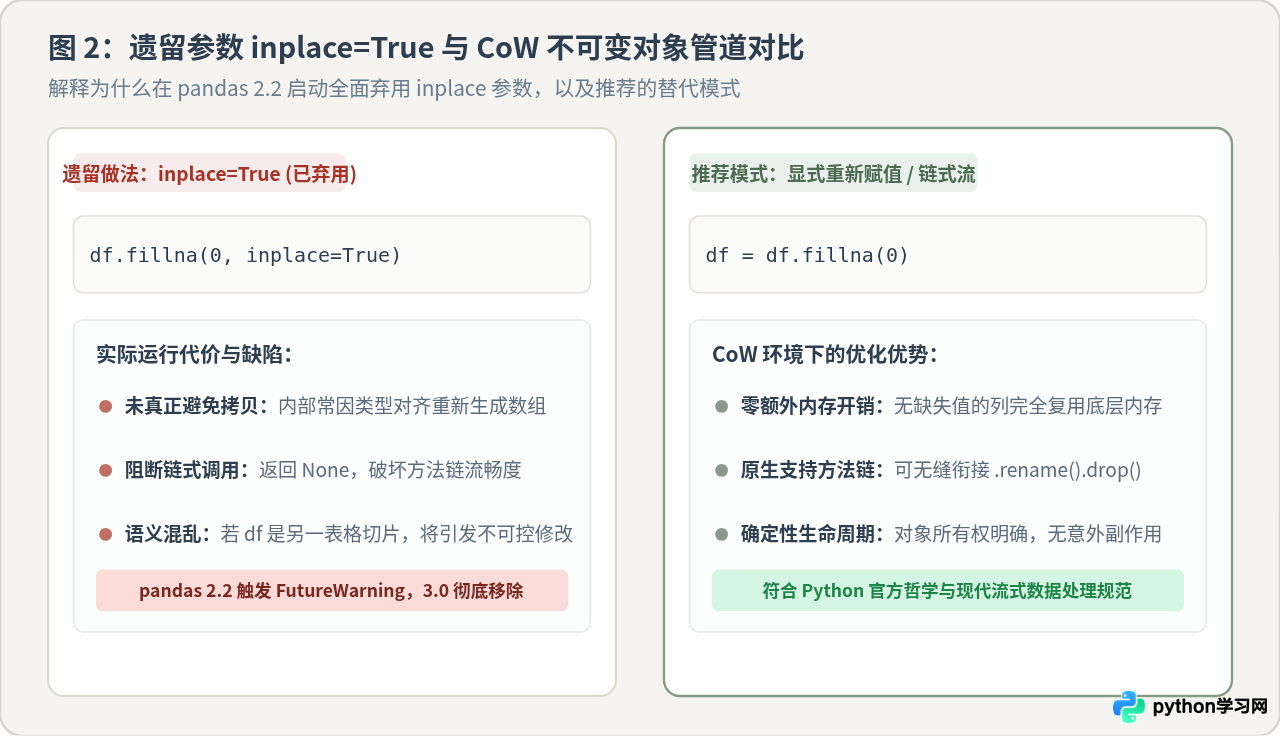
在这一阶段,最引人瞩目的关键变动是:全面弃用所有主要方法中的 inplace=True 参数,包括 fillna()、drop()、rename()、sort_values()、reset_index() 等。
为什么在 CoW 下必须淘汰 inplace=True?
许多开发者过去有一种误解,认为写 df.drop(columns=['x'], inplace=True) 可以节省内存、避免创建新表。但事实证明:
- 内存神话破灭:在传统底层架构中,
inplace=True往往也是先在内部生成新的数组块,再替换原 DataFrame 的指针,其内存开销与重新赋值几乎无异。 - 破坏链式调用与不可变性:
inplace=True会破坏方法链式调用(因其返回None),且容易引发非预期的隐式修改。 - CoW 实现了真·零拷贝更新:在 CoW 机制下,执行
df = df.drop(columns=['x'])时,未被删除的所有列直接复用原始底层数据指针,开销几乎为零!因此,inplace=True完全失去了存在的技术价值。
此外,在 pandas 2.2 开启 CoW 后,原先在 2.1 中仅仅警告的链式索引写入(Chained Assignment)会被强制拦截,抛出 ChainedAssignmentError,彻底禁止类似 df['a'][0] = 1 的写法。
四、pandas 2.3 阶段:固化迁移规则与衔接 3.0 默认落地
进入 pandas 2.3 演进阶段,Copy-on-Write 迎来了其在 2.x 时代的收敛阶段。作为通往 pandas 3.0 的最终桥梁,2.3 版本的主要目标不再是大幅添加新机制,而是固化行为边界与提供无缝的升级保障。
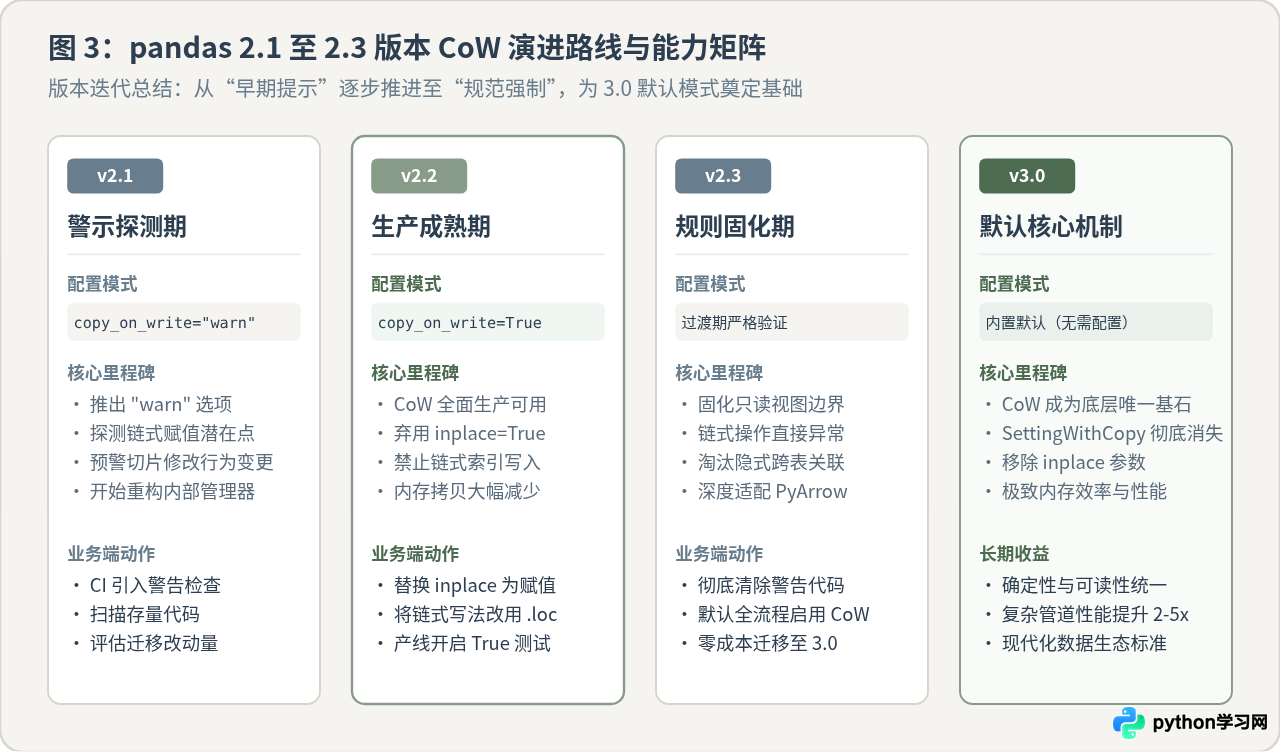
从 2.1 到 2.3 的功能演化脉络可清晰总结为四个阶梯:
- 2.1 探测期:引入
warn模式与ChainedAssignmentError预备,启动底层引用计数设计; - 2.2 成熟期:宣布 CoW 生产可用,系统性废弃
inplace=True,默认推荐通过True模式运行; - 2.3 固化期:全面收敛切片与复合索引的写时拷贝语义,深度集成 PyArrow 零拷贝后端,封死任何穿透原表修改的非正规接口;
- 3.0 落地目标:默认强制启用 Copy-on-Write,彻底废除全局开关与历史弃用方法,实现统一、纯粹且不可变的数据流模型。
五、存量工程实操指南:平滑迁移至 Copy-on-Write 的五步法
为了让已有业务管道在 pandas 升级过程中平稳过渡,推荐采用以下五个步骤逐步完成工程适配:
1开启预警模式,建立 CI 静态与动态检测
在本地开发环境或测试环境入口中开启预警模式,运行完整集成测试用例:
import pandas as pd
# 设置为 warn 模式以暴露出所有将在 3.0 改变行为的操作
pd.options.mode.copy_on_write = "warn"2全面消除链式索引赋值,规范使用 .loc
所有对表格子集的条件赋值或定位赋值,必须统一收敛为显式的单步 .loc[行选择器, 列选择器]:
# ❌ 错误示范:链式两步索引,CoW 下会直接抛出 ChainedAssignmentError
df[df["status"] == "pending"]["flag"] = 1

# ✅ 正确示范:单步精准定位,语义清晰无歧义
df.loc[df["status"] == "pending", "flag"] = 13清理 inplace=True,改写为显式变量赋值
遍历存量业务代码,检索所有 inplace=True 并替换为标准赋值或方法链调用:
# ❌ 遗留写法:将在 pandas 3.0 触发 TypeError 或被移除
df.dropna(subset=["key"], inplace=True)
df.sort_values(by="score", inplace=True)

# ✅ 现代写法:充分利用 CoW 底层列共享优化,速度更快
df = df.dropna(subset=["key"])
df = df.sort_values(by="score")4排查依赖“修改切片联动原表”的反模式设计
若业务逻辑中存在将 sub_df = df[...] 传递给子函数修改,并期望原 df 同步改变的代码,必须重构为返回新表或显式覆盖原列:
# ❌ 依赖隐式反向修改的旧模式
sub_df = df[df["score"] < 60]
sub_df["score"] = 60  # CoW 下这一步只修改 sub_df,原 df 的 score 不会变!

# ✅ 重构为显式合并或基于条件的赋值
df.loc[df["score"] < 60, "score"] = 605在生产环境中显式启用 True 模式
当测试套件在 "warn" 模式下零警告通过后,即可在生产配置文件中全面激活:
import pandas as pd
# 全量开启,彻底享受零拷贝性能红利并免疫 SettingWithCopyWarning
pd.options.mode.copy_on_write = True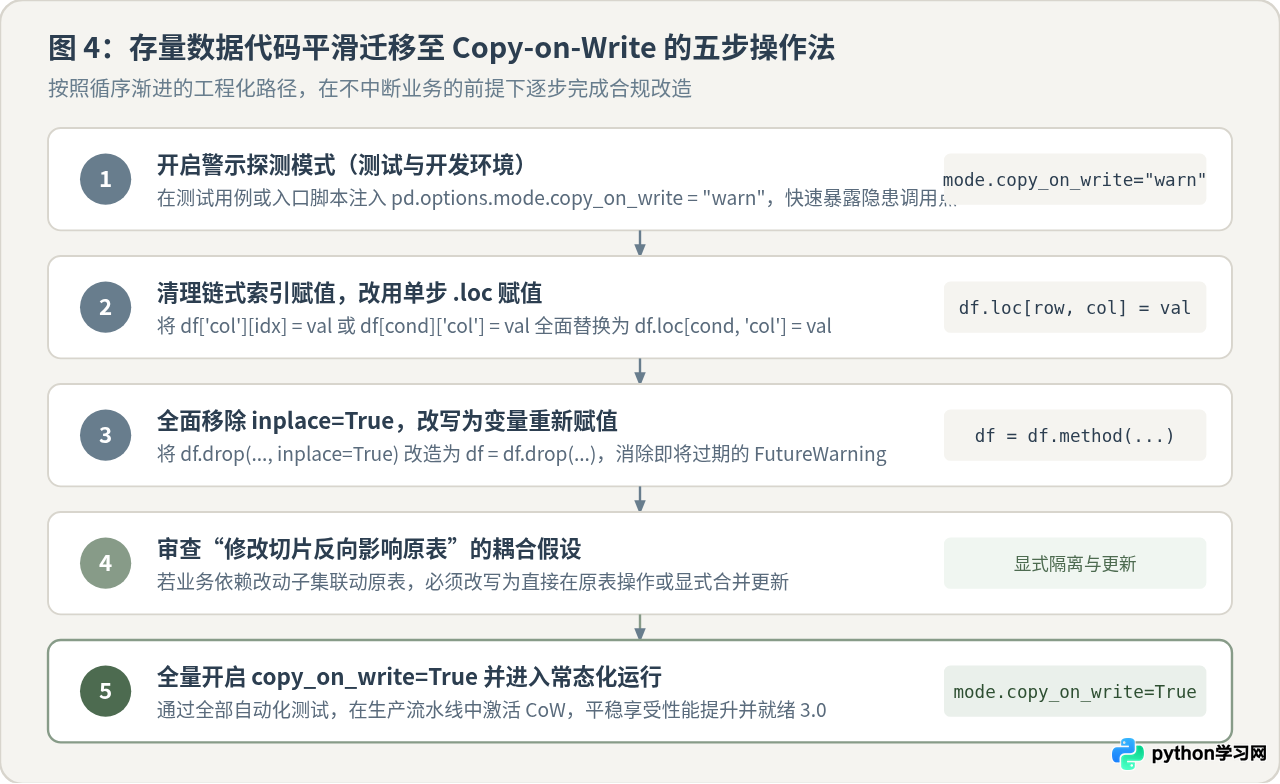
六、易混淆细节与避坑提醒
在传统 pandas 中,部分开发者习惯写
df2 = df.copy(deep=False) 并期望借此共享底层指针进行联动写入。在 CoW 下,即使使用浅拷贝,任何对 df2 元素的写入同样会立刻触发写时复制,绝对无法改动 df。浅拷贝在 CoW 下的含义仅为“在修改前共享内存以节省空间”。
若你的数据管道需要将 DataFrame 传递给 Scikit-learn、PyTorch 或自定义 Cython 扩展,请特别注意
df.to_numpy()。在 CoW 开启时,df.to_numpy() 默认返回具有只读标志(writeable=False)的 NumPy 数组。如果外部 C/C++ 扩展尝试在底层数组上执行原地写入,将会触发 ValueError: assignment destination is read-only。解决方法是在调用外部库前显式进行深拷贝:arr = df.to_numpy().copy()。
通过从 2.1 到 2.3 循序渐进的演进策略,pandas 成功化解了过去十年间数据科学界最大的设计隐患之一。采用这种可预测的不可变语义,开发者不仅摆脱了无休止的切片警告排查,更能让大规模数据处理管道运行得更加安全高效。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









