

python必背源代码argparse命令行解析代码
全面讲解Python标准库argparse命令行解析必背源代码模板,涵盖四步工作流、位置参数与可选参数对比、核心配置项数据流映射、互斥与子命令进阶及高频避坑指南。
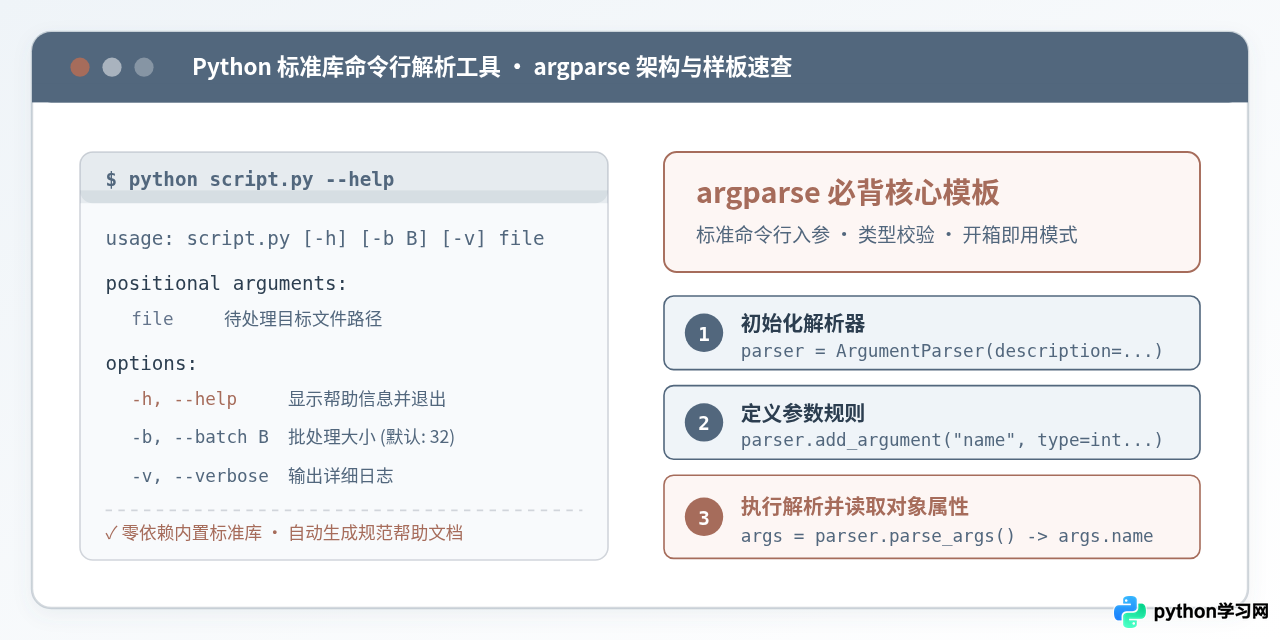
argparse 模块是处理终端传参的标准方式:它无需安装任何第三方库,开箱即用,能自动校验数据类型、设置默认值,并在用户输入错误或添加 -h/--help 时自动打印排版工整的使用指南。本文直接给出最核心、最常用的背诵级样板源代码,并深入剖析其生命周期、参数配置与工程避坑点。
一、最简标准必背模板(开箱即用代码)
在实际项目中最推荐的写法是将命令行解析封装进独立函数或主流程中。以下这段源代码涵盖了“位置必选参数”、“可选数值参数”、“布尔开关标志”三种最核心的传参形态,结构紧凑且可直接复制到任何工程中作为骨架:
# 文件名:cli_demo.py
import argparse

def parse_args():
    # 1. 实例化解析器对象,附带程序描述信息
    parser = argparse.ArgumentParser(
        description="数据批处理工具:演示 argparse 标准命令行参数解析"
    )

    # 2. 注册参数规则
    # [位置参数]:必需提供,按位置顺位解析
    parser.add_argument(
        "input_file",
        type=str,
        help="待处理的输入数据文件路径(例如: data.csv)"
    )

    # [可选参数]:带短选项与长选项,具备类型转换与默认回退值
    parser.add_argument(
        "-b", "--batch-size",
        type=int,
        default=32,
        help="单次批处理样本数量,整数类型,默认值为 32"
    )

    # [布尔开关]:使用 action='store_true',出现即为 True,缺省为 False
    parser.add_argument(
        "-v", "--verbose",
        action="store_true",
        help="开启详细执行日志输出模式"
    )

    # 3. 解析命令行传入的参数列表
    return parser.parse_args()

def main():
    args = parse_args()

    # 4. 提取属性并投入业务运行
    print(f"[执行中] 目标输入文件: {args.input_file}")
    print(f"[执行中] 批处理大小:   {args.batch_size} (类型: {type(args.batch_size).__name__})")
    print(f"[执行中] 详细输出模式: {args.verbose}")

if __name__ == "__main__":
    main()
1. 查看自动生成的帮助信息
当在终端执行 python3 cli_demo.py --help(或 -h)时,解析器会自动拦截并打印格式化文档,随后安全退出进程,无需手动编写帮助输出:
$ python3 cli_demo.py --help
# [示例输出]
usage: cli_demo.py [-h] [-b BATCH_SIZE] [-v] input_file

数据批处理工具:演示 argparse 标准命令行参数解析

positional arguments:
  input_file            待处理的输入数据文件路径(例如: data.csv)

options:
  -h, --help            show this help message and exit
  -b BATCH_SIZE, --batch-size BATCH_SIZE
                        单次批处理样本数量,整数类型,默认值为 32
  -v, --verbose         开启详细执行日志输出模式
2. 常见调用场景与执行结果
场景 A:标准传参,同时覆盖可选选项
$ python3 cli_demo.py train_set.csv --batch-size 128 -v
# [示例输出]
[执行中] 目标输入文件: train_set.csv
[执行中] 批处理大小:   128 (类型: int)
[执行中] 详细输出模式: True
场景 B:仅传必需的位置参数,可选参数使用默认值
$ python3 cli_demo.py raw_data.json
# [示例输出]
[执行中] 目标输入文件: raw_data.json
[执行中] 批处理大小:   32 (类型: int)
[执行中] 详细输出模式: False
场景 C:参数缺失或类型错误触发系统拦截
$ python3 cli_demo.py
# [示例输出]
usage: cli_demo.py [-h] [-b BATCH_SIZE] [-v] input_file
cli_demo.py: error: the following arguments are required: input_file

$ python3 cli_demo.py data.csv -b abc
# [示例输出]
cli_demo.py: error: argument -b/--batch-size: invalid int value: 'abc'
二、argparse 执行流程与生命周期四步法
理解 argparse 的本质,在于厘清它在脚本生命周期中所处的阶段。它本质上是一个配置规则的解释引擎,主要执行四个紧密相连的步骤:
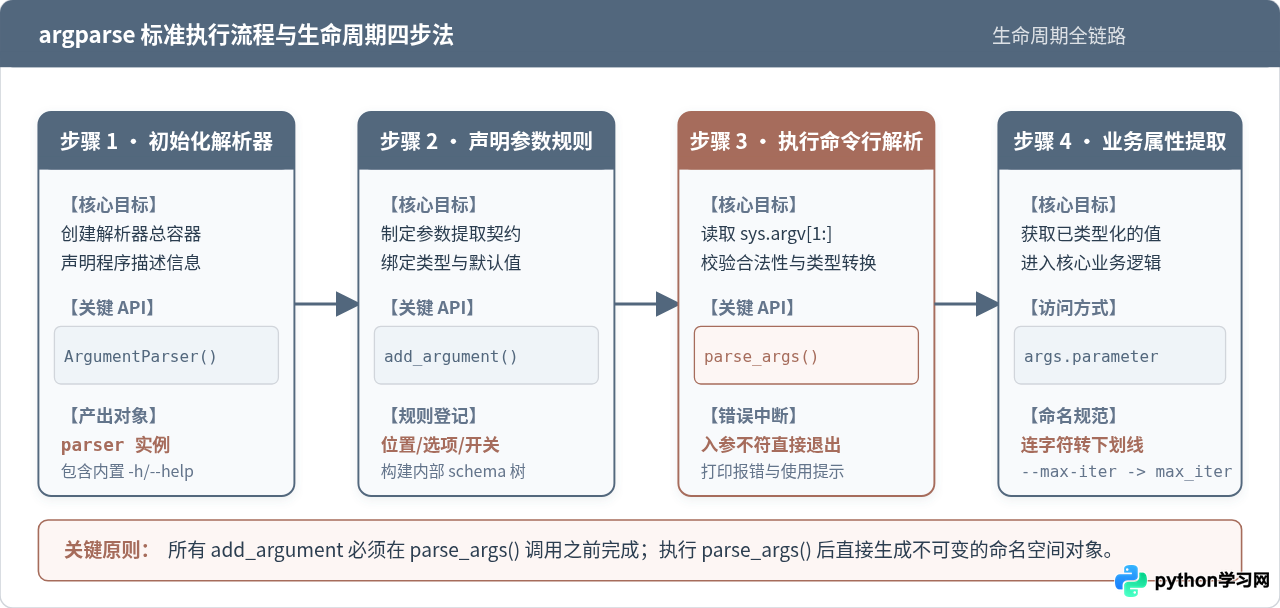
- 步骤 1:初始化解析器(ArgumentParser)。创建统一的解析容器,设定全局程序名称(
prog)和用途描述(description)。此步骤还会默认注入-h/--help选项。 - 步骤 2:注册参数规则(add_argument)。告诉解析器预期接收哪些参数名、参数属于必选还是可选、数据类型(如
int、str)、默认回退值以及提示信息。在此步骤中,解析器内部建立参数规则映射树。 - 步骤 3:执行参数解析(parse_args)。解析器读取
sys.argv[1:],逐项比对注册的规则,执行字符串提取、类型转换和合法性检验。若遇到未注册的异常选项或类型转换失败,直接打印错误信息并以状态码2退出脚本。 - 步骤 4:提取业务属性(Namespace 访问)。
parse_args()执行完毕后返回一个不可变的argparse.Namespace对象。参数值被绑定为该对象的普通属性,业务代码直接通过args.parameter_name读取。
三、位置参数与可选参数的深度对比
在 add_argument() 中,决定一个参数是“位置参数”还是“可选参数”的唯一标准是参数名是否以减号(-)开头。
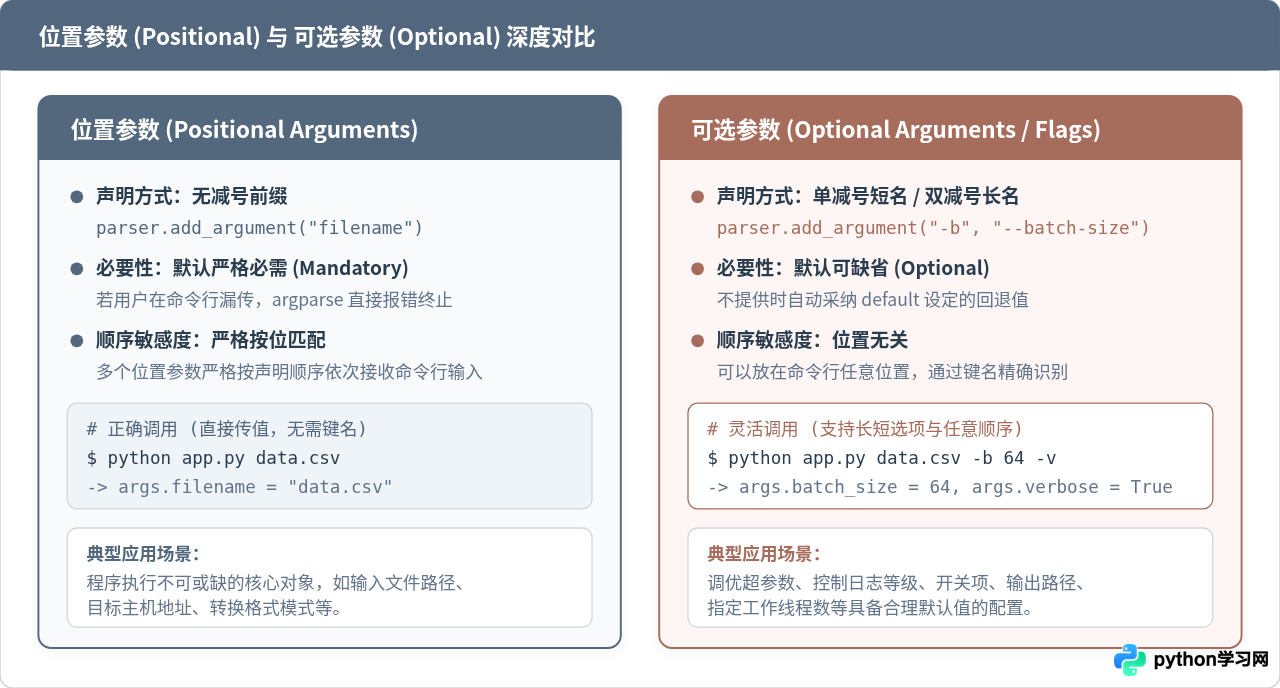
两者的具体技术特性与适用场景存在明确的边界划分:
| 对比维度 | 位置参数 (Positional) | 可选参数 (Optional / Flags) |
|---|---|---|
| 声明命名特征 | 无减号前缀,如 "file"、"mode" |
以单减号或双减号开头,如 "-b"、"--batch" |
| 是否必需 | 默认严格必填;缺失则直接报错 | 默认非必填;未传入时采纳 default 设定的值 |
| 命令行顺序 | 严格按位依赖;按声明顺序依次消耗传入值 | 顺序无关;支持与其它选项任意交错摆放 |
| 常用典型场景 | 核心处理对象,如源文件、数据库连接串、目标表 | 微调参数,如线程数、超时时间、日志级别、调试开关 |
四、add_argument 核心配置项与数据流映射
add_argument 拥有丰富的配置属性。掌握以下这几个关键参数的配合机制,即可覆盖 95% 以上的命令行开发需求:
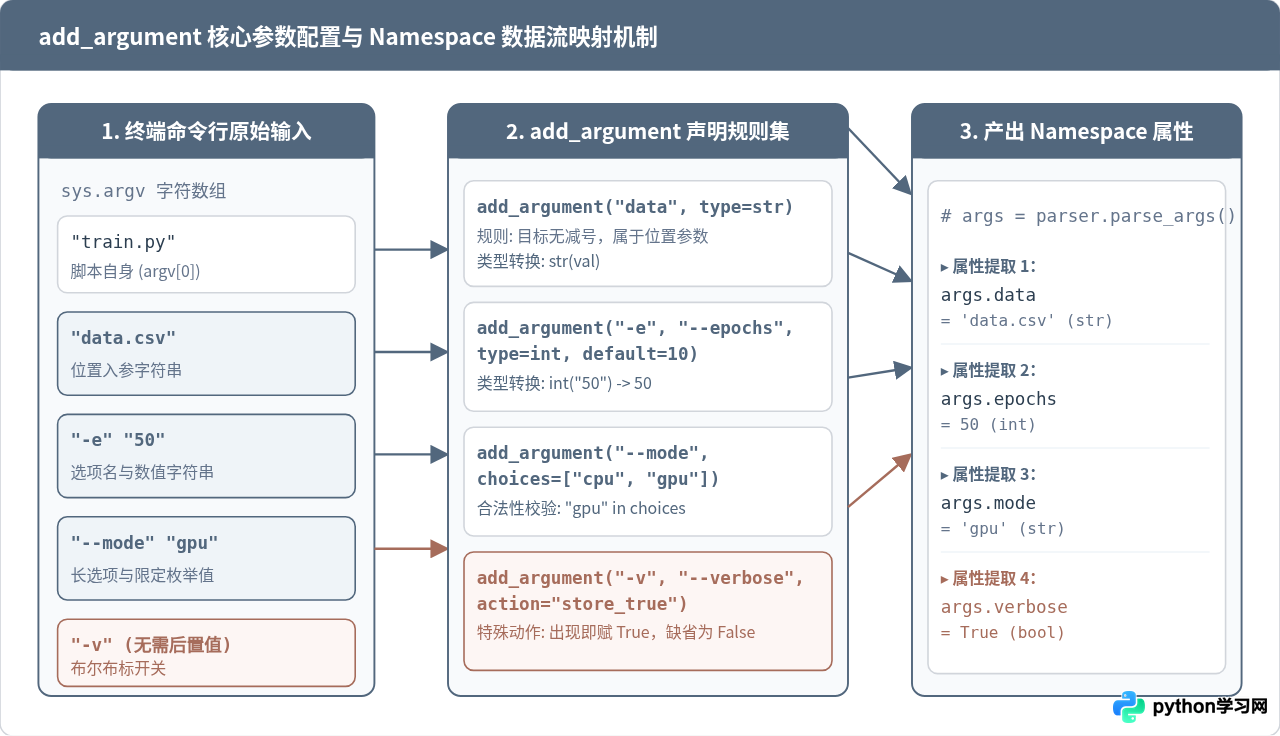
1. type:类型转换与校验函数
终端输入的命令行参数本质上都是字符串。通过指定 type=int、type=float,解析器在读取到字符后会自动调用对应的内置类型构造函数进行转换。不仅如此,type 还可以传入任何接收单个字符串参数的可调用对象(如自定义验证函数):
def check_positive(value):
    ivalue = int(value)
    if ivalue <= 0:
        raise argparse.ArgumentTypeError(f"{value} 不是合法的正整数")
    return ivalue

# 注册自定义类型校验
parser.add_argument("--workers", type=check_positive, default=4, help="工作线程数(必须大于0)")
2. default:缺省回退值
当可选参数在执行时被用户省略,解析器会将 default 指定的对象赋予该属性。如果未显式声明 default,其缺省值为 None。
3. choices:限定候选白名单
当希望限定用户只能在特定的有限集合内取值时,使用 choices 可以避免在业务逻辑中编写大量冗长的 if/else 校验:
parser.add_argument(
    "--format",
    choices=["json", "csv", "parquet"],
    default="json",
    help="输出文件格式(仅限 json, csv, parquet)"
)
4. action='store_true':布尔开关标志
命令行中常常需要 --debug 或 --force 这类无需在后面跟随具体参数值的纯开关。action="store_true" 表示:命令行中如果出现该参数,对应属性即设为 True;若不出现,对应属性设为 False。同理,action="store_false" 则逻辑相反。
5. nargs:接收变长或多个输入值
如果一个参数需要一次性接收多个值,可以使用 nargs:
nargs='+':至少需要 1 个值,解析为 Pythonlist。nargs='*':允许 0 个或多个值,解析为 Pythonlist。nargs=3:固定必须传入 3 个参数值。
6. dest 与命名自动规整机制
在长选项命名中,我们习惯使用符合 Unix 规范的连字符(例如 --output-dir)。由于 Python 的变量名不允许包含减号,argparse 会自动将连字符替换为下划线,最终通过 args.output_dir 读取。如果想自定义生成的属性名,可显式传入 dest="my_custom_var"。
五、工程进阶场景:互斥参数组与子命令架构
1. 互斥参数组(add_mutually_exclusive_group)
在某些业务场景下,两个参数在语义上是相互排斥的。例如在日志输出中,安静模式 --quiet 和详细模式 --verbose 不允许同时生效。使用互斥组可以让解析器自动代为拦截:
parser = argparse.ArgumentParser(description="互斥参数组示例")
# 创建互斥组
group = parser.add_mutually_exclusive_group()
group.add_argument("-v", "--verbose", action="store_true", help="详细日志")
group.add_argument("-q", "--quiet", action="store_true", help="静默模式")

args = parser.parse_args()
# 如果用户同时输入 -v 和 -q,argparse 将直接报错:
# error: argument -q/--quiet: not allowed with argument -v/--verbose
2. 多级子命令架构(add_subparsers)
当脚本逐步演化为一个综合性 CLI 工具(类似 git commit、git push 或 docker run、docker ps)时,可以利用子命令解析器进行模块化分流:
import argparse

def main():
    parser = argparse.ArgumentParser(prog="mytool", description="多功能数据运维工具")
    subparsers = parser.add_subparsers(dest="subcommand", required=True, help="可执行的子命令")

    # 注册子命令 1: build
    parser_build = subparsers.add_parser("build", help="构建数据包")
    parser_build.add_argument("--target", required=True, help="构建产物目标目录")

    # 注册子命令 2: deploy
    parser_deploy = subparsers.add_parser("deploy", help="部署服务")
    parser_deploy.add_argument("--env", choices=["test", "prod"], default="test", help="部署环境")

    args = parser.parse_args()

    # 根据子命令分发逻辑
    if args.subcommand == "build":
        print(f"正在执行构建,目标路径: {args.target}")
    elif args.subcommand == "deploy":
        print(f"正在执行部署,目标环境: {args.env}")

if __name__ == "__main__":
    main()
六、高频避坑指南与速查总结
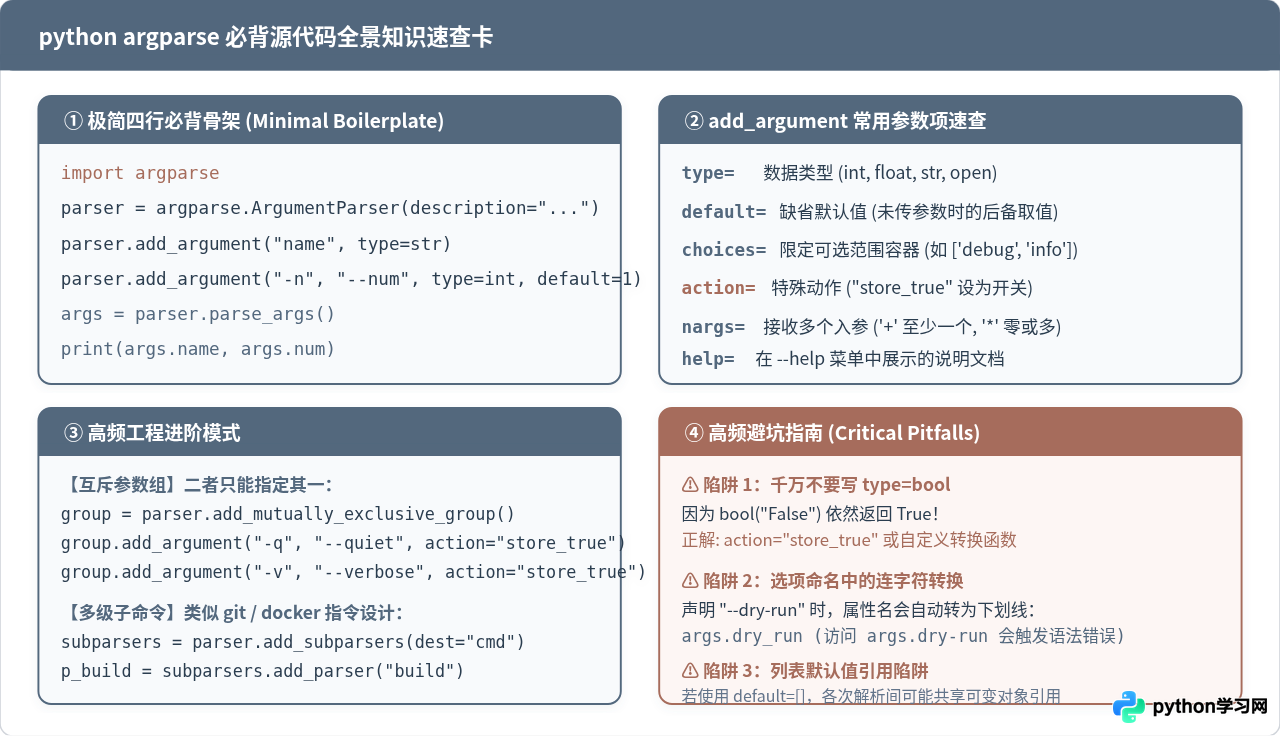
在实际编写与维护 argparse 代码时,有三个极易踩中的高频细节需要特别注意:
type=bool!初学者常常误写
parser.add_argument("--enable", type=bool)。在 Python 中,bool("False") 会返回 True(因为任何非空字符串经 bool() 转换后都为真)。这意味着用户在终端输入 --enable False 时,脚本得到的依然是 True!正确解法:需要布尔开关时,直接使用
action="store_true";若需要显式传递 "true"/"false" 字符串并转布尔值,应编写自定义类型转换函数。
在命令行参数中声明
--max-retries 时,解析器绑定到 Namespace 的属性名为 args.max_retries(减号变下划线)。如果写成 args.max-retries,Python 解释器会将其识别为减法表达式并报语法错误 SyntaxError。
在 Notebook 环境下直接运行
parser.parse_args() 时常报错 unrecognized arguments: -f ...。这是因为 Notebook 自身启动时带有内核参数,默认传入了 sys.argv。在交互式环境中测试时,应显式传入空列表或测试参数列表:parser.parse_args(args=['my_file.csv', '-b', '64'])。
通过掌握上述最简四步必背模板与核心参数用法,开发者能够在面对不同复杂度的 Python 脚本时,以极低的代码量快速搭建出健壮、严谨且符合工业级标准的命令行交互接口。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









