

Python模块导入时怎么过滤以下划线开头的变量
详细讲解在Python模块导入时如何过滤以下划线开头的变量,涵盖from module import *默认机制、__all__白名单机制、动态导入反射过滤及包级__init__.py的最佳实践。
在 Python 中过滤以下划线开头的变量,解决方案取决于具体的导入方式:使用常规语法 from module import * 时,Python 默认就会自动忽略所有以下划线开头的名称;在模块定义端,通过声明 __all__ 列表可以精确控制对外公开的符号白名单;若在运行时采用 importlib 或 dir() 动态反射加载模块,则需要利用列表推导式配合 not name.startswith('_') 进行程序化过滤。
一、语法层面的默认行为:from module import * 的过滤规则
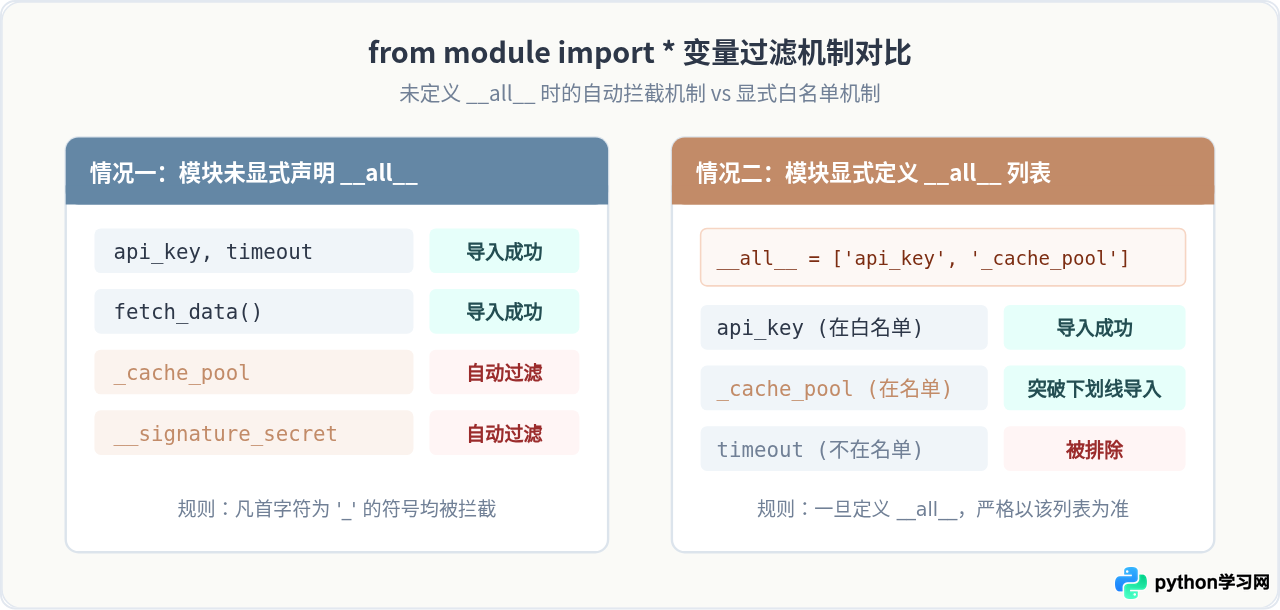
许多开发者在编写模块时,习惯将仅在内部使用的工具函数、缓存字典或私有配置命名为以下划线开头(例如 _cache 或 __internal_helper)。当调用方使用星号导入语法时,Python 解释器在语言规范层面已经内置了针对下划线的过滤机制。
假设存在一个名为 service.py 的模块,内容如下:
# service.py
api_key = "public_service_key"
timeout = 30

_cache_pool = {}
__signature_secret = "system_internal_sign"

def fetch_data():
    return "ok"

def _calc_token():
    return "internal_token"
当在另一个脚本中执行导入操作时:
# main.py (示例代码)
from service import *

# 检查当前命名空间中成功导入的变量
print([name for name in dir() if not name.startswith("__")])
# 示例输出: ['api_key', 'fetch_data', 'timeout']
在没有显式声明 __all__ 的情况下,执行 from service import * 只会将 api_key、timeout 与 fetch_data 注入当前作用域,而以单下划线开头的 _cache_pool、_calc_token 以及双下划线开头的 __signature_secret 会被解释器直接跳过。
import service 不会发生过滤如果直接使用
import service,整个模块对象会被完整绑定到当前环境,通过属性访问 service._cache_pool 依然可以读取内部变量。下划线属于 Python 社区约定的私有标记,解释器仅在 * 通配导入时做符号过滤,并不会硬性阻止点号属性访问。
二、模块服务端的控制方案:显式维护 __all__
若要在模块开发端主动确保下划线变量不被外部使用者导入,最严谨的做法是在模块顶层定义 __all__。__all__ 是一个字符串序列,显式声明了当外部执行 from module import * 时允许导出的符号名。
1. 手动声明导出白名单
只将明确对外部公开的函数与常量放入 __all__,所有未被包含的变量都会被阻隔在外:
# config.py
__all__ = ['ENV_NAME', 'load_config']

ENV_NAME = "production"
load_config = lambda: {"status": "ready"}

# 内部使用变量,未列入 __all__,调用方无法通过 * 导入
_internal_db_uri = "sqlite:///:memory:"
debug_flag = False  # 即便没有下划线,不在 __all__ 也会被过滤
2. 模块内自动化构建 __all__
如果模块内部包含大量合法公开变量,手动更新 __all__ 容易遗漏,可以在模块文件的末尾利用推导式动态生成 __all__:
# generator.py
def generate_order_id():
    return 1001

def create_bill():
    return "bill_content"

_db_connection = "active_conn"
_salt_key = "abc123xyz"

# 自动扫描当前模块作用域,过滤所有以下划线开头的变量及内置魔术属性
__all__ = [name for name in dir() if not name.startswith('_')]
通过这种方式,后续在该模块中新增的以字母开头的公共函数会自动进入导出列表,而所有以下划线打头的辅助变量均被排除。
三、动态导入与反射场景:程序化过滤下划线变量
在编写插件系统、微服务路由注册或配置中心时,通常需要在代码运行期动态载入模块并提取其暴露的对象。此时不能使用静态的 from module import *,必须通过程序化方式过滤掉以下划线开头的变量及内置属性。
常见实现:importlib 配合推导式过滤
通过标准库 importlib 动态加载模块后,结合 dir() 或 vars() 获取成员字典,再通过 startswith('_') 判定条件过滤出目标组件。
import importlib

def load_public_attributes(module_path: str) -> dict:
    """动态载入指定模块,并过滤掉所有以下划线开头的私有变量与内置属性"""
    module = importlib.import_module(module_path)

    # 提取所有不以下划线开头的属性名
    public_names = [name for name in dir(module) if not name.startswith('_')]

    # 提取对应的对象组装为字典
    public_objects = {
        name: getattr(module, name)
        for name in public_names
    }
    return public_objects

# 使用示例
if __name__ == "__main__":
    components = load_public_attributes("math")
    print(f"成功提取公开函数与常量数: {len(components)}")
    # 示例输出: 成功提取公开函数与常量数: 63
    # 其中内置的 __name__、__doc__、__spec__ 以及私有下划线函数已被完整过滤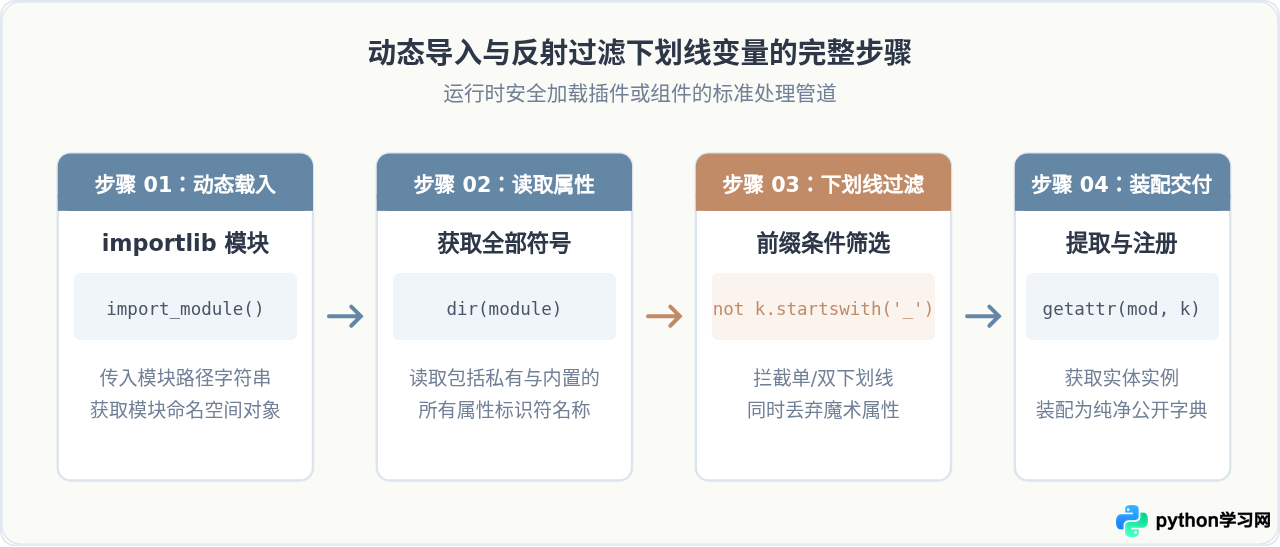
四、包级架构实践:在 __init__.py 中隔离私有变量
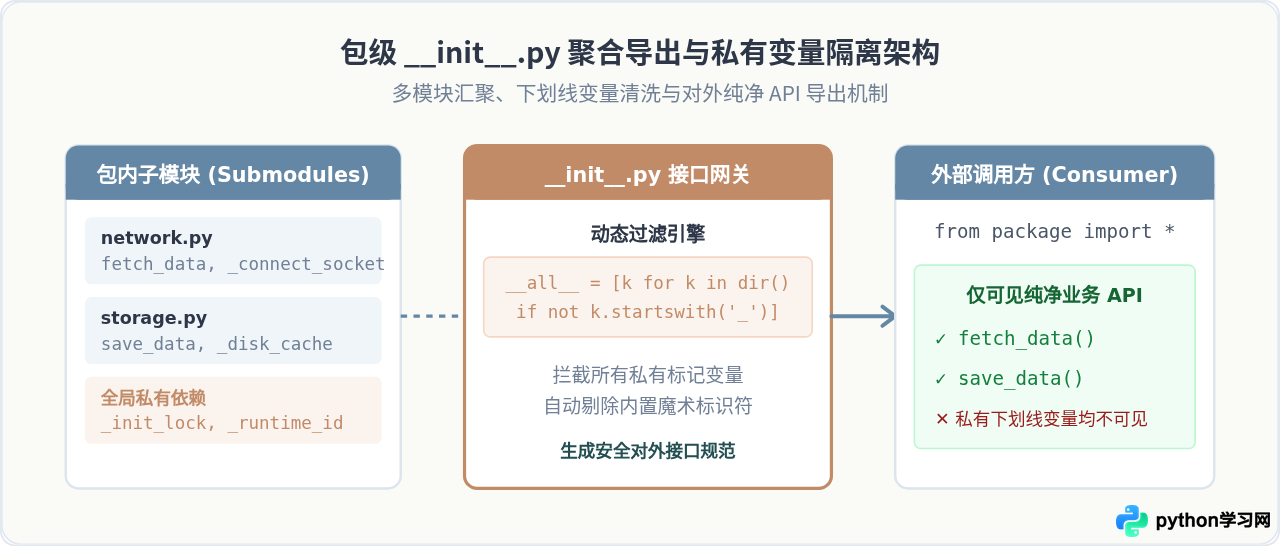
在大型工程中,通常会把多个子模块组织成 Python 包。为了给调用方提供简洁友好的 API,开发者通常会在包的根文件 __init__.py 中统一引入子模块的函数。如果直接在 __init__.py 中写入普通 import 语句,导入本身也会成为该命名空间的全局变量。
例如,当我们在 __init__.py 中引入了标准库 os 或辅助变量 _temp_helper 时,若不加控制,外部使用 from my_package import * 就会误导入这些不需要的内容。
# my_package/__init__.py
from .network import fetch_remote_data
from .storage import save_to_disk

# 内部辅助逻辑
import os
_init_lock = True

def _verify_env():
    return bool(os.getenv("APP_ENV"))

# 方案:动态生成仅包含业务公开函数的导出列表
__all__ = [
    name for name in dir()
    if not name.startswith('_') and name not in ('os',)
]
五、使用场景对比与决策建议
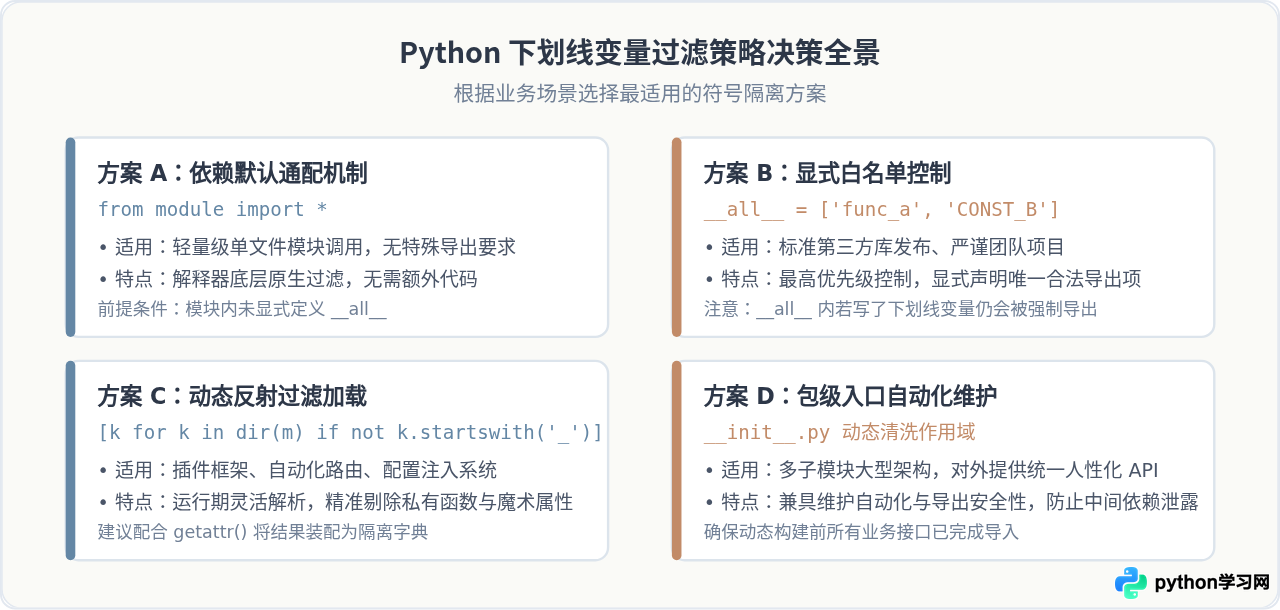
针对不同开发需求与技术场景,过滤下划线开头变量的处理策略有着清晰的适用边界。下面的对照表总结了常见场景下的推荐做法:
| 应用场景 | 主要实现手段 | 下划线过滤机制 | 优势与适用考量 |
|---|---|---|---|
| 常规单模块导入 | from module import * |
Python 语法解析器自动拦截 | 零配置成本,适合日常脚本快速编写 |
| 公共库/API 发布 | 显式定义 __all__ 列表 |
白名单机制覆盖默认下划线规则 | 契约清晰严谨,彻底杜绝意外暴露 |
| 包根导出管理 | 在 __init__.py 动态生成 __all__ |
基于 dir() 提取并排除 _ |
聚合多个子模块时减少重复手工维护 |
| 插件化/反射载入 | importlib + 字典/列表推导式 |
运行期 not k.startswith('_') 筛选 |
高度灵活,可在动态加载时隔离系统与私有属性 |
六、常见问题与注意事项
1. 过滤条件是否会误伤双下划线魔术属性?
使用 not name.startswith('_') 时,不仅单下划线变量(如 _helper)会被过滤,双下划线变量(如 __secret)以及 Python 内置的魔术属性(如 __name__、__doc__、__file__、__package__ 等)也会被一并过滤。在动态加载与公开组件扫描场景中,这正是预期的理想行为,因为外部调用者通常并不需要这些解释器元信息。
2. 避免在运行时直接污染 globals()
在编写动态导入代码时,部分开发者习惯直接调用 globals()[name] = getattr(module, name) 将对象强制注入当前全局命名空间。这种做法容易导致变量覆盖与难以排查的命名冲突。更推荐的做法是将过滤后的对象维护在一个专用字典或命名空间对象(例如 types.SimpleNamespace)中,既保留了隔离性,又方便代码检查工具识别。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









