

Python元组有哪些常用方法?仅count和index详解
全面解析Python元组的内置方法,深入探讨为何元组仅拥有count与index两个方法,并通过语法解析、执行图解、边界陷阱与实战代码详解其使用技巧。
很多刚接触 Python 的开发者在学完列表(List)的各种增删改查方法后,翻看元组(Tuple)的文档时常会感到困惑:元组到底提供了哪些常用方法?答案非常直接:Python 元组原生仅提供了两个内置方法——count() 和 index()。 除此之外,元组没有任何可以原地修改数据、追加项或删除项的类方法。本文将直接从元组的设计哲学出发,深入拆解这两个仅存方法的语法细节、底层逻辑、边界陷阱及在生产开发中的标准用法。
一、为什么元组仅保留 count 与 index 两个方法?
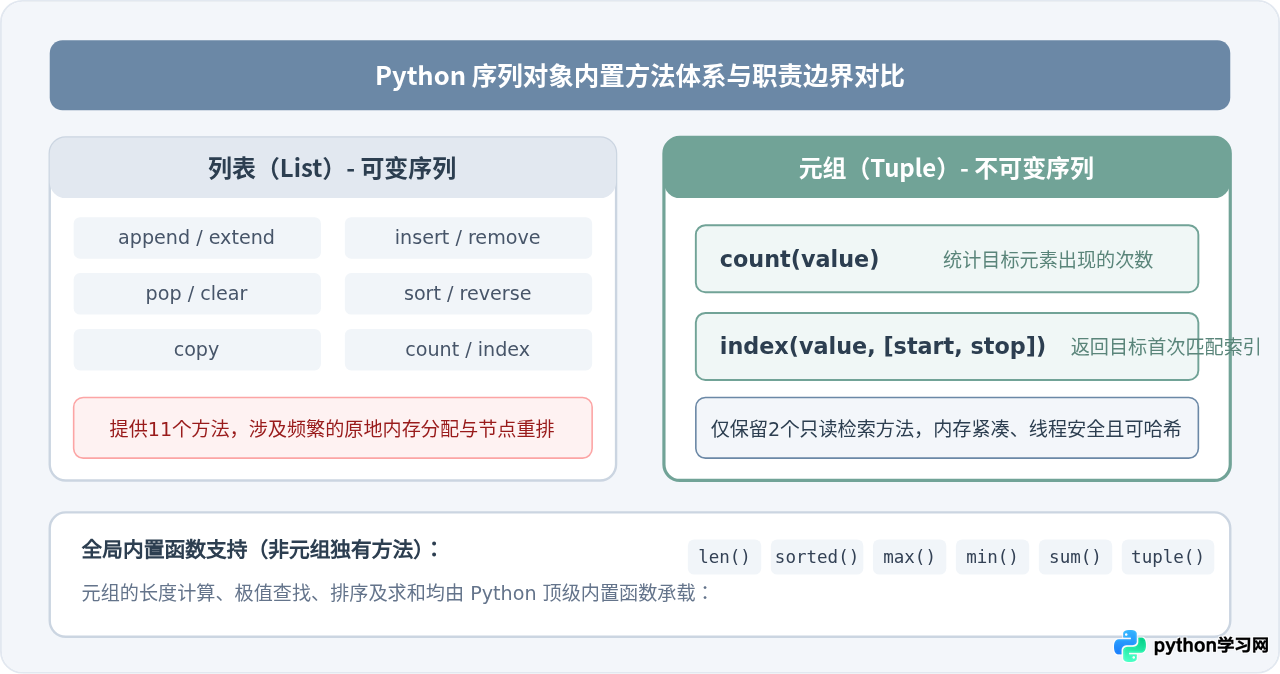
在 Python 中,元组与列表同样属于序列(Sequence)数据类型,均支持按位置索引访问、切片操作和迭代遍历。然而,两者的根本区别在于可变性(Mutability):
- 列表是可变序列(Mutable Sequence): 允许在内存地址不变的前提下原地增删元素、调整顺序,因此提供了
append()、extend()、insert()、remove()、pop()、clear()、sort()、reverse()等大量写操作方法。 - 元组是不可变序列(Immutable Sequence): 元组一旦在内存中初始化完成,其长度和每个位置所指向的对象引用便不可变更。任何修改元组内容的操作在语法层面均被彻底禁止。
正因为元组拒绝一切写操作,所有可能改变自身状态的方法都被裁撤;同时,切片截取、拼接并产生新元组的操作通常由操作符(+、*)和系统内置函数承载。最终保留在元组对象实例上的方法,就只剩下两个最纯粹的只读检索方法:用来统计某个元素出现次数的 count(),以及定位某个元素第一次出现索引的 index()。
二、count() 方法详解:统计元素出现的次数
count() 方法用于检索元组中与指定参数相等的元素总数。其核心设计目标是安全、明确地反馈出现频次。
1. 语法与参数
tuple.count(value)- 参数
value: 需要在元组中进行比对的目标对象。 - 返回值: 整数(
int)。若元组包含该元素,返回出现的总次数;若不存在,直接返回0,不会抛出异常。 - 时间复杂度: $O(N)$。底层需要从元组头部线性扫描至尾部完成逐项比对。
2. 典型使用代码示例
# 基础用法示例
colors = ("red", "green", "blue", "red", "yellow", "red")

# 统计存在元素
print(colors.count("red"))    # 示例输出:3

# 统计不存在的元素
print(colors.count("black"))  # 示例输出:0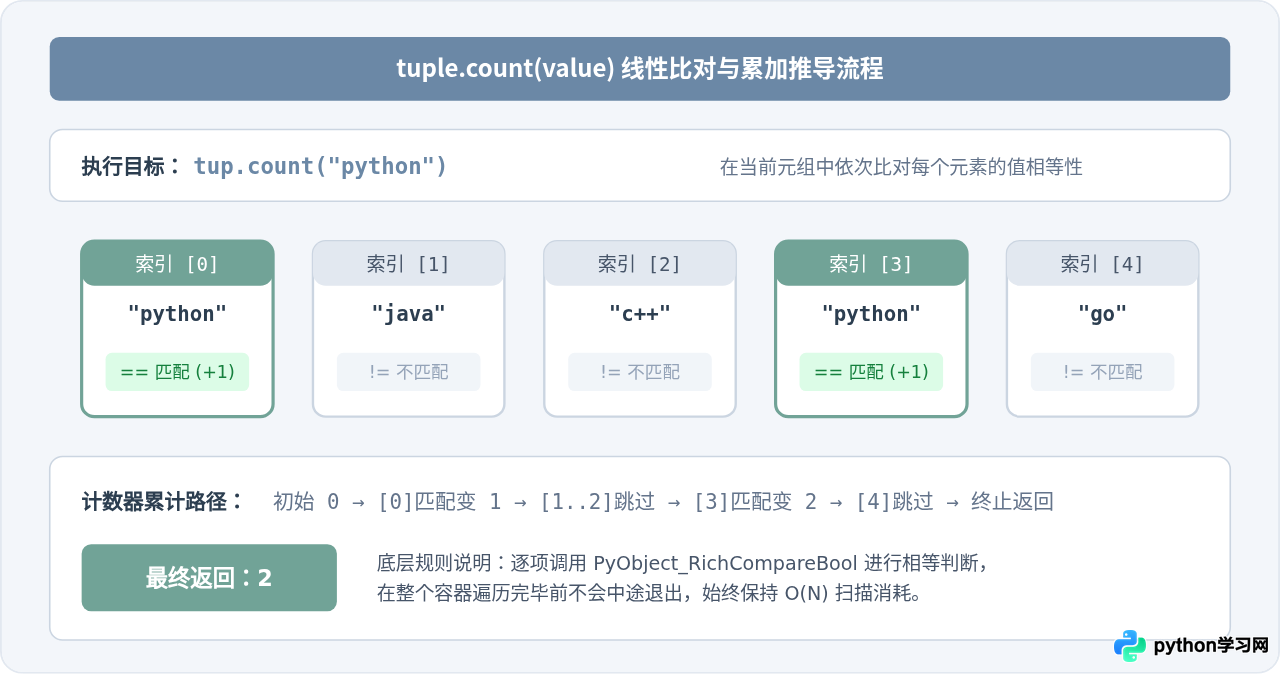
3. 开发者容易忽视的细节
注意:布尔值与整型数值的等值判定
在 Python 中,bool 是 int 的子类,且 True == 1 以及 False == 0 的比较结果均为真。如果元组中混合存储了数字与布尔值,count() 会依据等值性(==)而非身份唯一性(is)进行统计:
mixed_tuple = (1, True, 0, False, "1")

# True == 1 成立,因此 1 的计数包含自身与布尔 True
print(mixed_tuple.count(1))     # 示例输出:2
print(mixed_tuple.count(True))  # 示例输出:2

# False == 0 成立
print(mixed_tuple.count(0))     # 示例输出:2

# 字符串与数字类型不同,不成立
print(mixed_tuple.count("1"))   # 示例输出:1
三、index() 方法详解:查找元素的索引位置
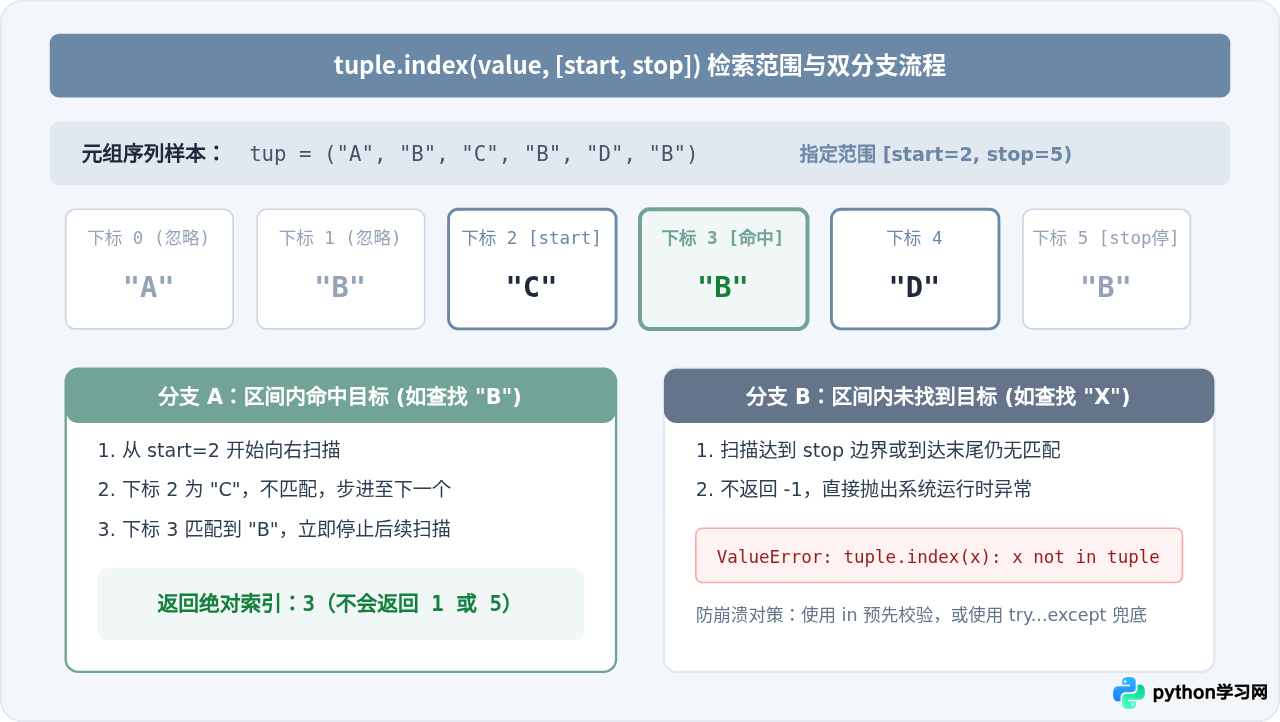
index() 方法用于查找指定元素在元组中第一次出现的索引下标。与大多数语言中的简单查找不同,Python 的 index() 支持切片区间的范围界定,同时在未找到目标时采用了严谨的异常机制。
1. 语法与参数
tuple.index(value, [start, [stop]])value: 必选参数,需要查找的目标值。start(可选): 查找区间的起始下标(包含该下标,默认值为0)。stop(可选): 查找区间的结束下标(不包含该下标,默认值为元组长度len(tuple))。- 返回值: 整数下标。返回目标值在指定区间内首次匹配到的绝对索引值(基于元组整体从
0开始的下标)。
关键机制:未找到目标时抛出 ValueError
不同于某些字符串方法(如 str.find() 会在未找到时返回 -1),元组的 index() 方法如果未在指定范围中找到目标,会立即抛出 ValueError 异常。因此,直接调用未加保护的 index() 具有潜在的崩溃风险。
2. 安全调用 index() 的两类工程实践
在实际项目开发中,如果不能 100% 确保元组中一定含有待查询项,必须使用以下两种方式之一来保证程序健壮性:
方式一:使用 in 关键字进行前置成员判断(推荐直观场景)
languages = ("Python", "Go", "Rust", "TypeScript")
target = "Java"

if target in languages:
    idx = languages.index(target)
    print(f"找到目标,索引位于: {idx}")
else:
    print(f"元组中未包含 {target}")
方式二:使用 try...except ValueError 结构(推荐高并发或性能优先场景)
# 当目标大概率存在时,直接 try 查找避免了 in 操作的双重遍历消耗
target = "Rust"

try:
    idx = languages.index(target)
    print(f"目标索引为: {idx}")
except ValueError:
    print("未找到指定元素,进入降级处理逻辑")
3. 指定 start 和 stop 参数的精确检索
nums = (10, 20, 30, 20, 40, 20, 50)

# 从头查找首个 20
print(nums.index(20))          # 示例输出:1

# 从索引 2 开始往后查找下一个 20
print(nums.index(20, 2))       # 示例输出:3

# 在切片区间 [2, 5) 中查找 20
print(nums.index(20, 2, 5))    # 示例输出:3

# 在切片区间 [4, 5) 即元素 (40,) 中查找 20(将引发 ValueError)
try:
    nums.index(20, 4, 5)
except ValueError as e:
    print("指定区间内无匹配项")   # 示例输出:指定区间内无匹配项
四、常见延伸问题与操作决策
正因为元组本身的方法极其克制,许多在列表中习惯的操作需要转由内置函数或推导式来完成。以下是开发中读者最常遇到的需求与解决方案:
1. 如果需要获取某个元素出现的所有索引位置该怎么办?
index() 遇到第一个匹配项就会立即返回,无法获取后续重复项的索引。对于元组中多次出现的元素,推荐使用内置函数 enumerate() 配合列表推导式或生成器表达式提取全部匹配索引:
data = ("a", "b", "c", "a", "d", "a")
target = "a"

# 获取 "a" 出现的所有位置
all_indices = [idx for idx, val in enumerate(data) if val == target]
print(all_indices)  # 示例输出:[0, 3, 5]
2. 元组没有 sort() 和 reverse(),如何进行排序或反转?
列表的 sort() 和 reverse() 属于原地变异方法。元组不支持原地操作,但可以通过 Python 提供的顶级函数生成新的排序副本或切片反转:
raw_tuple = (5, 2, 8, 1, 9)

# 1. 升序排序:使用 sorted() 返回新列表,再视需求转回元组
sorted_list = sorted(raw_tuple)
sorted_tuple = tuple(sorted_list)
print(sorted_tuple)  # 示例输出:(1, 2, 5, 8, 9)

# 2. 序列反转:最 Pythonic 的方式是步长为 -1 的切片
reversed_tuple = raw_tuple[::-1]
print(reversed_tuple)  # 示例输出:(9, 1, 8, 2, 5)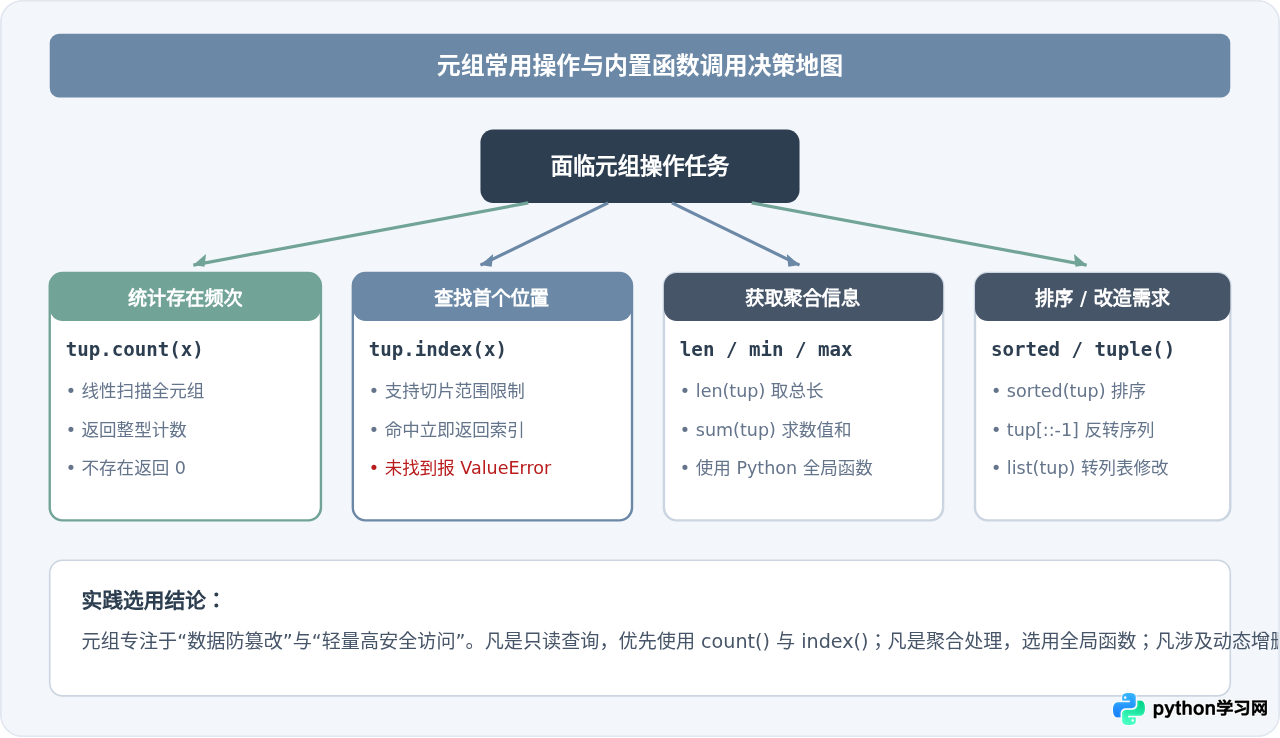
五、核心要点总结
| 方法名 | 参数格式 | 返回值类型 | 未找到目标时的表现 | 典型应用场景 |
|---|---|---|---|---|
count() |
(value) |
int |
返回 0(无异常) |
统计出现频次、快速判断是否包含、多重状态校验 |
index() |
(value, [start, [stop]]) |
int |
抛出 ValueError |
定位元素位置、局部切片区间快速查重 |
掌握元组“仅有两个内置方法”的本质,有助于理解 Python 标准库的设计纯粹度:将易变行为限制在可变容器中,而为元组赋予极简的内存结构、高效的遍历速度以及充当字典键(Hashable)的能力。在日常编写代码时,凡需统计用 count(),凡需定位用 index() 并配好异常处理,即可规范、安全地使用好元组。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









