

Python系统维护脚本:磁盘清理与日志分析小工具实现
介绍如何使用Python编写实用的系统维护脚本,涵盖基于文件修改时间的安全磁盘清理机制与基于流式读取的大日志分析统计工具。
在日常 Linux 或类 Unix 服务器维护中,磁盘空间被历史缓存填满、核心服务因大日志文件写满分区而中断,是系统管理员和运维人员经常遭遇的实际痛点。虽然通过 find、du、grep 和 awk 能够临时排查问题,但在面对多环境统一管理、定期清理和自动化审计时,使用统一的 Python 脚本能提供更可控的异常捕获机制、跨平台兼容性以及结构化的输出统计。本文将构建一套专为系统维护设计的轻量级工具,涵盖磁盘冗余扫描清理与生产访问日志的高频分析两个核心功能。
一、整体架构与模块设计
为了让脚本易于维护且能通过定时任务(Cron)或命令行按需调用,我们将整个工具划分为三个关键组成部分:命令行参数解析入口、磁盘安全清理器(DiskCleaner)以及大文件流式日志分析器(LogAnalyzer)。两个业务模块彼此解耦,既能单独执行,也能在综合巡检模式下连续运行并输出汇总报告。
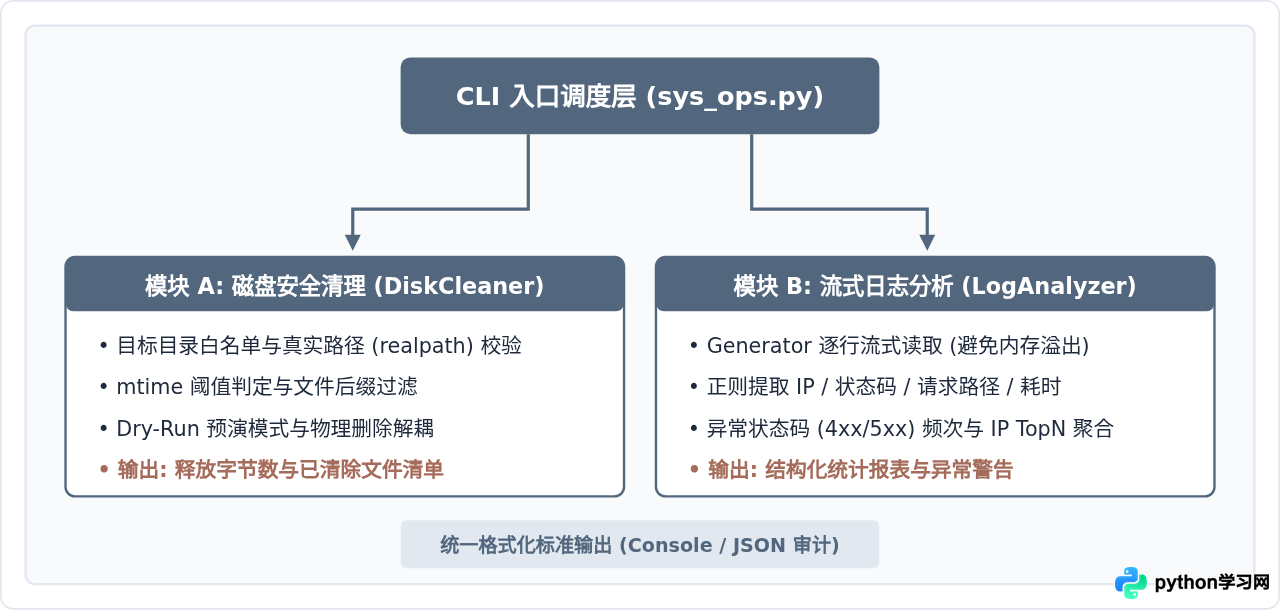
二、磁盘清理模块:安全机制与实现
编写自动化清理脚本最忌讳的是“误删”。为了保证生产环境的绝对安全,清理逻辑必须遵循三项刚性原则:第一,必须设定严格的路径白名单与真实路径解析,防止路径穿越(例如 ../)或误入系统级根目录;第二,具备默认开启的 --dry-run(预演)模式,让管理员先核实待删除列表;第三,针对文件最后修改时间(mtime)做绝对值运算,确保只清理过期归档。
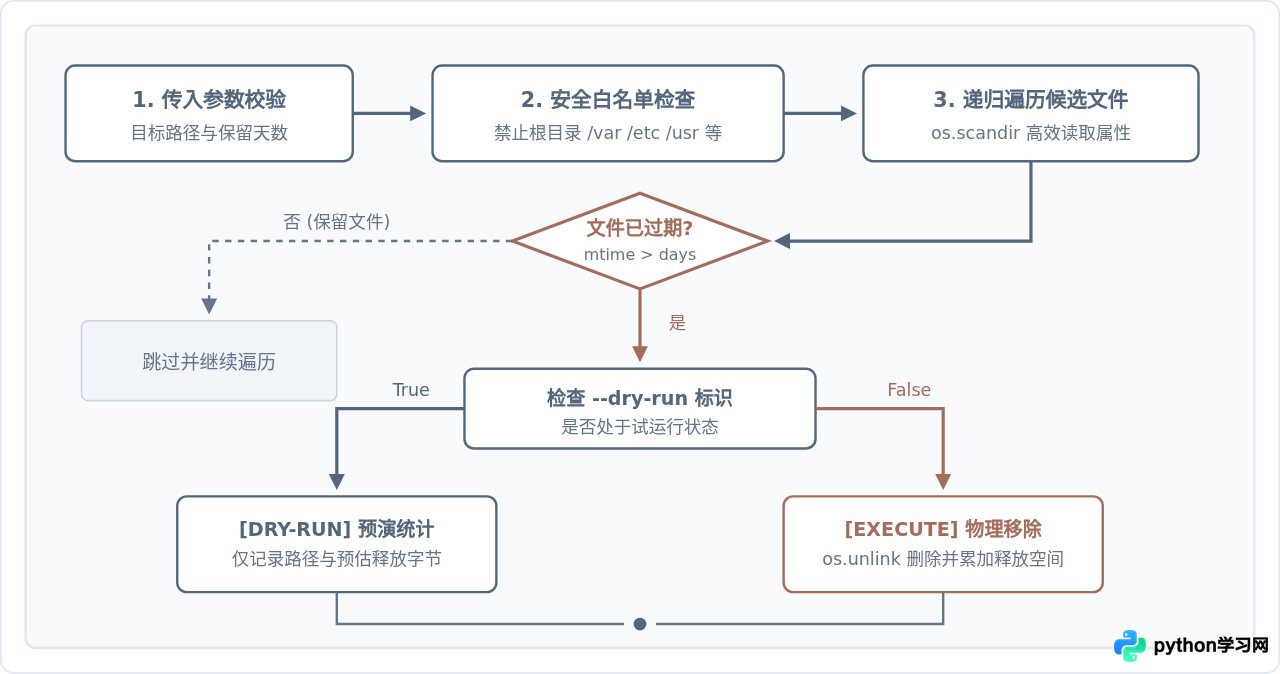
下面是磁盘清理模块的具体代码实现。我们使用 Python 内置的 pathlib.Path 与 os.scandir,在保障遍历性能的同时,对不可读或权限受限的目录做静默捕获,防止异常中断整个脚本。
import os
import sys
import time
from pathlib import Path
from typing import List, Dict, Tuple

class DiskCleaner:
    # 明确禁止作为清理目标的危险系统路径
    FORBIDDEN_ROOTS = {"/", "/root", "/bin", "/boot", "/dev", "/etc", "/lib", "/usr", "/proc", "/sys"}

    def __init__(self, target_dir: str, days_threshold: int = 7, extensions: List[str] = None):
        self.target_path = Path(target_dir).resolve()
        self.days_threshold = days_threshold
        self.extensions = set(ext.lower() if ext.startswith('.') else f".{ext.lower()}" for ext in extensions) if extensions else None
        self._validate_path()

    def _validate_path(self):
        resolved_str = str(self.target_path)
        if resolved_str in self.FORBIDDEN_ROOTS:
            raise ValueError(f"安全拒绝:禁止清理核心系统目录 {resolved_str}")
        if not self.target_path.exists():
            raise FileNotFoundError(f"目标目录不存在:{resolved_str}")
        if not self.target_path.is_dir():
            raise NotADirectoryError(f"目标路径并非有效目录:{resolved_str}")

    def scan_and_clean(self, dry_run: bool = True) -> Dict[str, any]:
        now = time.time()
        cutoff_seconds = now - (self.days_threshold * 86400)

        scanned_count = 0
        matched_files: List[Tuple[Path, int]] = []
        total_reclaimed_bytes = 0

        # 递归遍历目录
        for root, _, files in os.walk(self.target_path):
            for filename in files:
                scanned_count += 1
                file_path = Path(root) / filename

                # 后缀过滤
                if self.extensions and file_path.suffix.lower() not in self.extensions:
                    continue

                try:
                    stat_res = file_path.stat()
                    # 仅处理常规文件,排除管道、软链接等特殊文件
                    if not file_path.is_file() or file_path.is_symlink():
                        continue

                    if stat_res.st_mtime < cutoff_seconds:
                        matched_files.append((file_path, stat_res.st_size))
                        total_reclaimed_bytes += stat_res.st_size

                        if not dry_run:
                            file_path.unlink()
                except (PermissionError, FileNotFoundError) as err:
                    # 忽略临时文件消失或无权限的情况
                    continue

        return {
            "target": str(self.target_path),
            "dry_run": dry_run,
            "scanned_total": scanned_count,
            "matched_count": len(matched_files),
            "reclaimed_bytes": total_reclaimed_bytes,
            "reclaimed_human": self._format_size(total_reclaimed_bytes),
            "files": [str(p) for p, _ in matched_files]
        }

    @staticmethod
    def _format_size(size_bytes: int) -> str:
        for unit in ['B', 'KB', 'MB', 'GB', 'TB']:
            if size_bytes < 1024.0:
                return f"{size_bytes:.2f} {unit}"
            size_bytes /= 1024.0
        return f"{size_bytes:.2f} PB"
三、日志分析模块:流式读取与聚合分析
服务日志(如 Nginx、Apache、应用日志)往往达到数百兆甚至数十吉字节(GB)。如果直接使用 file.readlines() 将全部日志载入内存,极易触发操作系统的 OOM Killer,直接击垮维护脚本甚至影响在线业务。因此,处理日志的核心原则是流式处理(Streaming):通过 Python 生成器逐行读取,提取出所需结构后立即进行增量聚合,将内存占用严格限定在 $O(1)$ 常数级别。
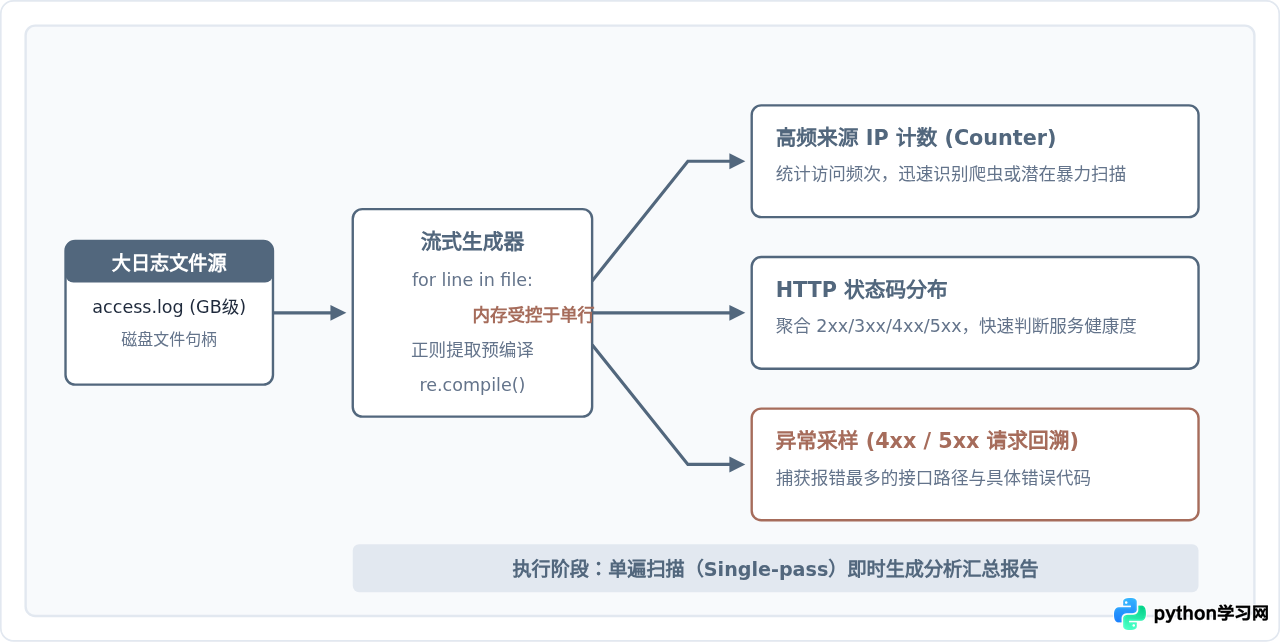
下面是日志分析器核心逻辑。针对常见的 Web 组合访问日志(Nginx Combined Format),使用预编译正则表达式提取 IP、请求路径、HTTP 状态码和响应大小,并利用 collections.Counter 提取 Top 统计。
import re
from collections import Counter
from typing import Dict, Any

class LogAnalyzer:
    # 匹配通用 Nginx/Apache Combined 格式日志
    # 示例: 192.168.1.10 - - [10/Oct/2026:06:15:32 +0800] "GET /api/v1/health HTTP/1.1" 200 128
    LOG_PATTERN = re.compile(
        r'^(?P<ip>[\d\.:a-fA-F]+)\s+-\s+\S+\s+\[(?P<time>[^\]]+)\]\s+"(?P<method>[A-Z]+)\s+(?P<uri>\S+)\s+[^\"]+"\s+(?P<status>\d{3})\s+(?P<bytes>\d+)'
    )

    def __init__(self, log_path: str):
        self.log_path = Path(log_path)
        if not self.log_path.exists():
            raise FileNotFoundError(f"日志文件不存在:{log_path}")

    def analyze(self, top_n: int = 10) -> Dict[str, Any]:
        total_lines = 0
        parsed_lines = 0
        ip_counter = Counter()
        status_counter = Counter()
        uri_counter = Counter()
        error_uris = Counter()

        with open(self.log_path, 'r', encoding='utf-8', errors='ignore') as f:
            for line in f:
                total_lines += 1
                match = self.LOG_PATTERN.match(line.strip())
                if not match:
                    continue

                parsed_lines += 1
                data = match.groupdict()
                ip = data['ip']
                status = data['status']
                uri = data['uri']

                ip_counter[ip] += 1
                status_counter[status] += 1
                uri_counter[uri] += 1

                # 记录 4xx 与 5xx 错误请求
                if status.startswith(('4', '5')):
                    error_uris[f"[{status}] {uri}"] += 1

        total_errors = sum(count for status, count in status_counter.items() if status.startswith(('4', '5')))
        error_rate = (total_errors / parsed_lines * 100) if parsed_lines > 0 else 0.0

        return {
            "file": str(self.log_path),
            "total_lines": total_lines,
            "parsed_lines": parsed_lines,
            "parse_success_rate": f"{(parsed_lines / total_lines * 100):.2f}%" if total_lines else "0.00%",
            "top_ips": ip_counter.most_common(top_n),
            "status_distribution": dict(status_counter),
            "error_rate": f"{error_rate:.2f}%",
            "top_errors": error_uris.most_common(top_n)
        }
四、CLI 整合与完整脚本编排
为了让运维人员方便地在终端执行不同维护指令,我们通过标准库 argparse 引入子命令(Subparsers),将磁盘清理(clean)与日志分析(analyze)统一收敛到一个可执行文件 sys_ops.py 中。以下是整合后的完整运行脚本:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
Python 系统维护脚本:磁盘清理与日志分析小工具
"""

import argparse
import json

def format_clean_report(result: dict):
    print("=" * 60)
    print(f"磁盘清理报告 [{'DRY RUN (预演模式)' if result['dry_run'] else '已实际执行'}]")
    print("=" * 60)
    print(f"目标目录: {result['target']}")
    print(f"扫描文件总数: {result['scanned_total']}")
    print(f"命中过期文件: {result['matched_count']}")
    print(f"释放空间总量: {result['reclaimed_human']} ({result['reclaimed_bytes']} Bytes)")
    if result["files"]:
        print("\n待处理/已处理文件列表 (前 10 项):")
        for item in result["files"][:10]:
            print(f"  - {item}")
        if len(result["files"]) > 10:
            print(f"  ... 另有 {len(result['files']) - 10} 项省略")
    print("=" * 60)

def format_log_report(result: dict):
    print("=" * 60)
    print("日志分析汇总报告")
    print("=" * 60)
    print(f"日志文件: {result['file']}")
    print(f"总读取行数: {result['total_lines']} (有效解析: {result['parsed_lines']}, 成功率: {result['parse_success_rate']})")
    print(f"整体异常率: {result['error_rate']}")

    print("\nHTTP 状态码分布:")
    for status, count in sorted(result["status_distribution"].items()):
        print(f"  状态 {status}: {count} 次")

    print("\n高频访问 IP Top 5:")
    for ip, count in result["top_ips"][:5]:
        print(f"  {ip:<20} {count} 次")

    if result["top_errors"]:
        print("\n高频异常请求 Top 5:")
        for uri, count in result["top_errors"][:5]:
            print(f"  {uri:<35} {count} 次")
    print("=" * 60)

def main():
    parser = argparse.ArgumentParser(description="系统维护小工具:磁盘清理与日志分析")
    subparsers = parser.add_subparsers(dest="subcommand", required=True)

    # 磁盘清理子命令
    clean_parser = subparsers.add_parser("clean", help="扫描并清理过期文件")
    clean_parser.add_argument("-d", "--dir", required=True, help="要清理的目标目录路径")
    clean_parser.add_argument("--days", type=int, default=7, help="保留最近 N 天内的文件,超出者清理 (默认 7)")
    clean_parser.add_argument("--ext", nargs="*", default=None, help="限定文件后缀,例如 --ext log gz tmp")
    clean_parser.add_argument("--execute", action="store_true", help="显式加上此参数才会真实删除,否则默认为 dry-run 预演")
    clean_parser.add_argument("--json", action="store_true", help="以 JSON 格式输出结果")

    # 日志分析子命令
    log_parser = subparsers.add_parser("analyze", help="流式分析 Web 访问日志")
    log_parser.add_argument("-f", "--file", required=True, help="日志文件路径")
    log_parser.add_argument("--top", type=int, default=10, help="输出 Top N 统计项 (默认 10)")
    log_parser.add_argument("--json", action="store_true", help="以 JSON 格式输出结果")

    args = parser.parse_args()

    if args.subcommand == "clean":
        cleaner = DiskCleaner(target_dir=args.dir, days_threshold=args.days, extensions=args.ext)
        # 未指定 --execute 时保持 dry_run=True
        report = cleaner.scan_and_clean(dry_run=(not args.execute))
        if args.json:
            print(json.dumps(report, ensure_ascii=False, indent=2))
        else:
            format_clean_report(report)

    elif args.subcommand == "analyze":
        analyzer = LogAnalyzer(log_path=args.file)
        report = analyzer.analyze(top_n=args.top)
        if args.json:
            print(json.dumps(report, ensure_ascii=False, indent=2))
        else:
            format_log_report(report)

if __name__ == "__main__":
    main()
五、实际执行与结果验证
在不同运维场景中,可以采用不同的参数组合执行工具。以下是具体命令及其典型的控制台执行输出示例:
1. 磁盘清理预演与正式执行
首先对 /data/logs/nginx 目录进行安全预演,查找 14 天前的压缩日志:
# 试运行模式:检查 14 天以前的 .gz 和 .log 文件
python3 sys_ops.py clean -d /data/logs/nginx --days 14 --ext gz log
终端返回的示例结果如下,展示了命中的文件数与预估释放空间,此时物理磁盘未做任何变动:
============================================================
磁盘清理报告 [DRY RUN (预演模式)]
============================================================
目标目录: /data/logs/nginx
扫描文件总数: 84
命中过期文件: 12
释放空间总量: 4.82 GB (5175782144 Bytes)

待处理/已处理文件列表 (前 10 项):
  - /data/logs/nginx/access.2026-09-01.log.gz
  - /data/logs/nginx/access.2026-09-02.log.gz
  - /data/logs/nginx/access.2026-09-03.log.gz
============================================================
核对列表无误后,添加 --execute 开关执行真实物理删除:
# 正式物理清理
python3 sys_ops.py clean -d /data/logs/nginx --days 14 --ext gz log --execute
2. 大日志文件分析
直接对数十万行的线上日志文件进行分析:
# 分析 Nginx 访问日志并输出 Top 10
python3 sys_ops.py analyze -f /var/log/nginx/access.log --top 5
控制台将实时生成直观的指标卡片:
============================================================
日志分析汇总报告
============================================================
日志文件: /var/log/nginx/access.log
总读取行数: 352840 (有效解析: 352840, 成功率: 100.00%)
整体异常率: 1.42%

HTTP 状态码分布:
  状态 200: 341200 次
  状态 304: 6620 次
  状态 404: 4120 次
  状态 502: 900 次

高频访问 IP Top 5:
  192.168.10.15        42100 次
  10.0.4.88            31200 次
  114.240.8.12         15800 次
  182.92.140.9         12400 次
  203.208.60.1         9800 次

高频异常请求 Top 5:
  [404] /wp-login.php               1850 次
  [404] /.env                       1120 次
  [502] /api/v1/payment/checkout    900 次
============================================================
六、生产环境自动化与巡检闭环
单次手动运行小工具能够满足应急排查,但运维的核心价值在于将其融入系统生命周期的自动化与监控闭环。通过配置系统的定时任务调度器(如 Linux 的 crontab 或 systemd.timer),结合脚本原生的 --json 参数,可无缝对接监控系统(如 Zabbix、Prometheus Pushgateway 或报警 Webhook)。
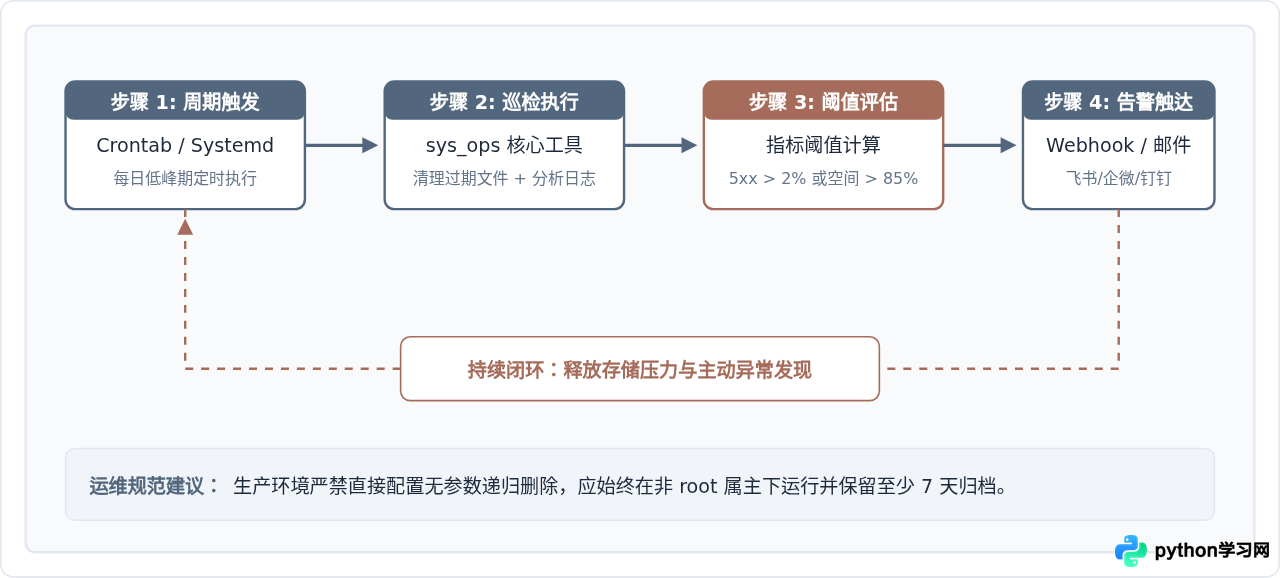
- 权限最小化:运行该维护脚本时,建议创建专用的系统运维账户(如
sysops),仅授予目标日志目录的读取权限和归档清理目录的写入权限,避免使用root执行。 - 与 logrotate 协同:磁盘清理工具主要清理的是带有时间戳或已压缩的历史切片(如
*.gz、*.log.1)。活跃写入中的主日志文件(如access.log)应当交由操作系统的logrotate执行轮转与重载,切勿直接删除正在被进程占用写入的文件句柄。 - 审计日志归档:在使用
--execute删除文件时,可将清理报告重定向至统一审计日志(如/var/log/sys_ops_audit.log),便于追溯空间释放历史。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









