

python-mtimeit怎么给代码段计时?
详细讲解如何使用 python -m timeit 命令行工具为 Python 代码段及多行代码计时,包含准备代码分离、多参数传递、缩进处理、核心参数调优及常见陷阱防范。
time.time() 往往容易受到单次系统负载抖动和垃圾回收(GC)的干扰。Python 内置的 timeit 命令行工具(通过 python -m timeit 调用)是进行微基准测试的标准方式。本文将直接讲解如何在终端中对单行语句、多行代码段、含准备数据的代码进行精确计时,并说明关键参数的搭配与常见避坑要点。
一、基础理解:什么是 python -m timeit?
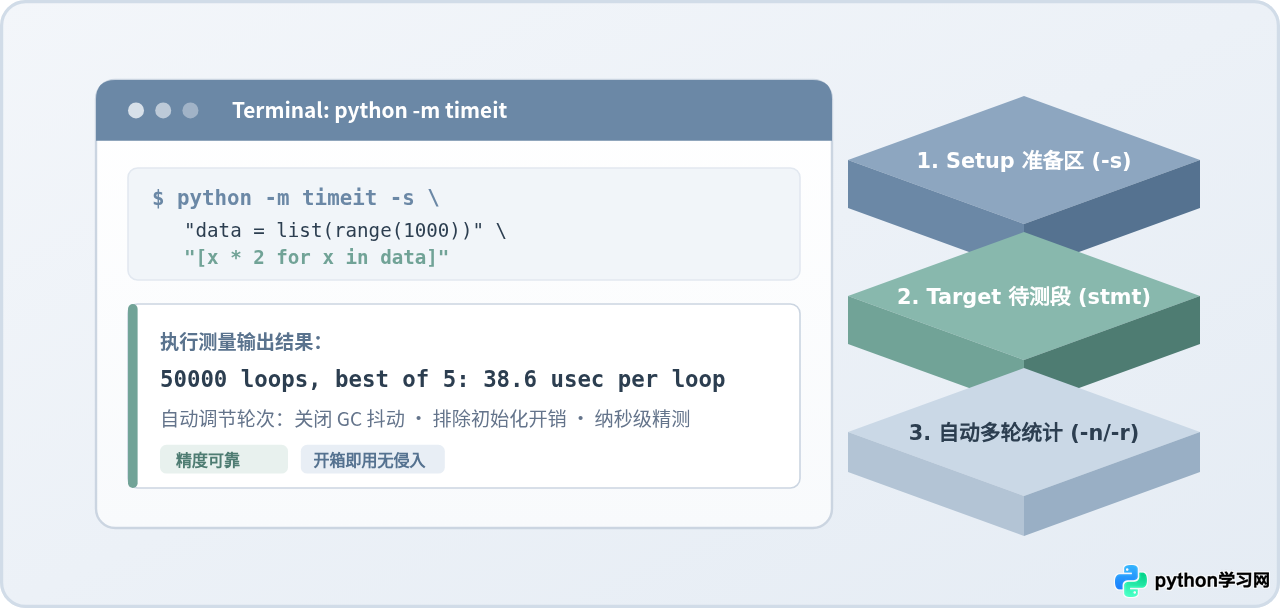
在终端命令行中,-m 参数表示将指定的 Python 模块作为独立脚本启动。python -m timeit 调用的正是标准库中的 timeit 模块。它具备以下专门为“测量性能”设计的特性:
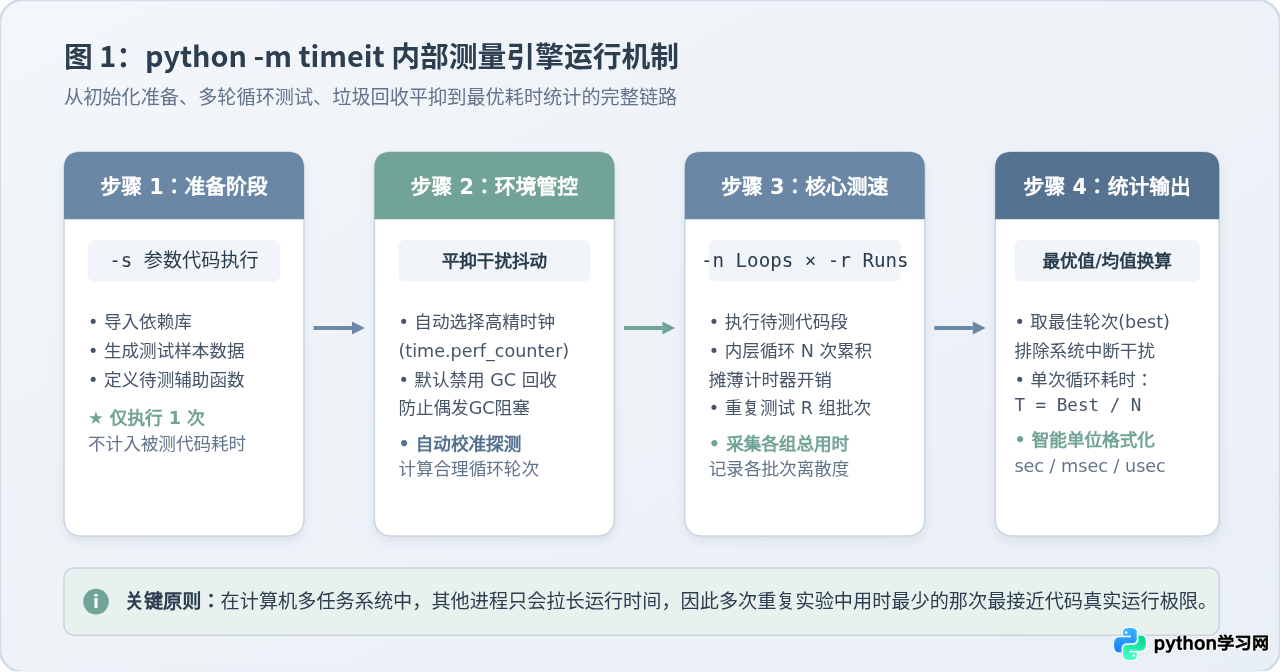
- 自动消除单次测量误差:它会通过内层循环执行成千上万次代码,计算总时间后再求平均值,避免操作系统上下文切换带来的偶然波动。
- 平抑垃圾回收干扰:在计时循环期间,它会自动暂时禁用 Python 垃圾回收机制(GC),确保不会因为某一次循环恰巧触发 GC 导致测速结果严重偏大。
- 独立命名空间:它在一个相对干净、隔离的命名空间中运行,不会遗留污染当前交互环境中的全局变量。
最简单的单行代码测速形式如下。直接在命令后传入用引号包裹的待测表达式即可:
# 示例:测量生成一个包含 100 个数字的列表切片耗时
python -m timeit "list(range(100))[:50]"
终端会输出类似下面的结果:
100000 loops, best of 5: 1.12 usec per loop这行输出的含义是:该代码段在 5 组独立测试中,每组自动执行了 100,000 次循环;在这 5 组结果中,表现最优的一组平均每次循环仅耗时 1.12 微秒(usec)。
二、核心重点:如何给“多行代码段”计时?
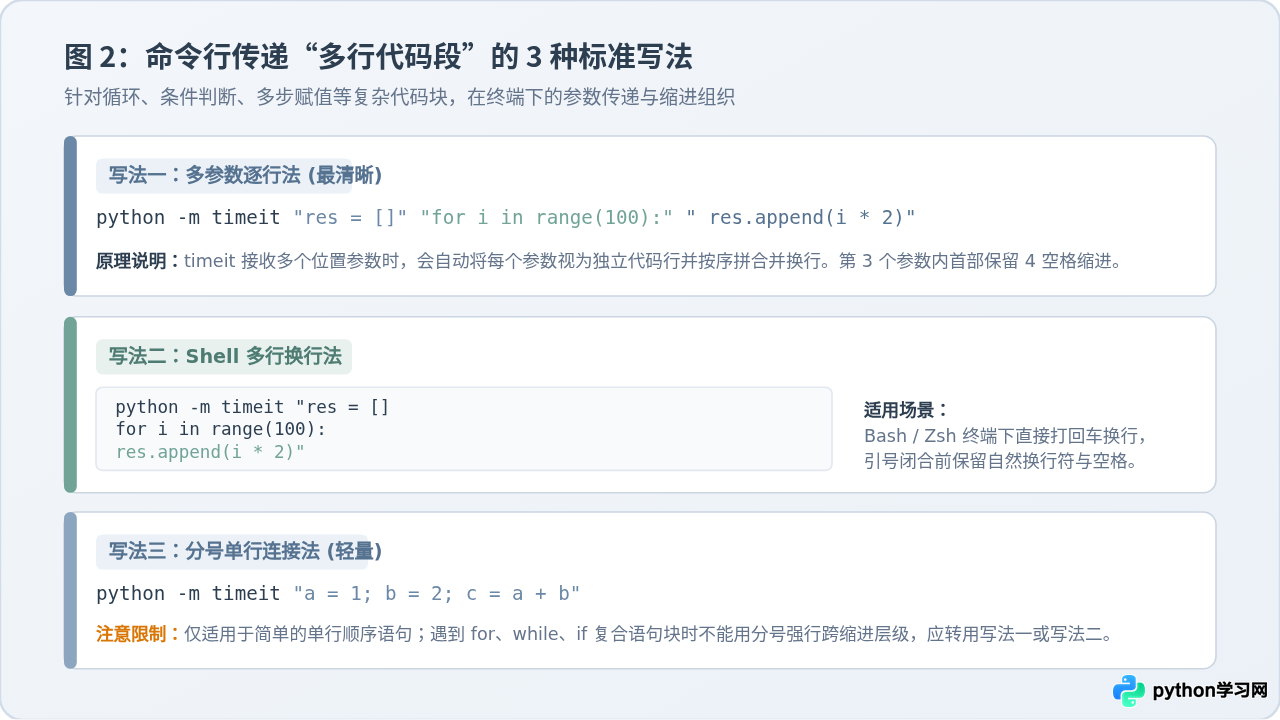
许多开发者在初次尝试对包含 for 循环、分支判断或多行赋值的代码段计时时,常因引号闭合或缩进报错而受阻。在命令行中给多行代码段计时,通常有以下 3 种规范处理方式:
方法 1:多位置参数传递法(推荐写法)
timeit 命令行的参数解析规则非常灵活:如果命令行中传入了多个位置参数字符串,timeit 会将每一个参数视为新的一行,并自动用换行符连接。
这种写法在各种操作系统(Windows cmd/PowerShell、macOS 与 Linux 的 Bash/Zsh)中兼容性最好,排版也最易读。需要注意的是,循环体内部有缩进的行,在字符串内部开头必须显式保留 4 个空格:
# 测量一个累加计算的多行代码段
python -m timeit "total = 0" "for x in range(100):" "    total += x"
这里传了 3 个独立的参数字符串:
"total = 0" 为第一行;
"for x in range(100):" 为第二行;
" total += x" 为第三行,前置 4 个空格作为循环体。
方法 2:Shell 物理多行换行法
在类 Unix 系统(如 Linux、macOS 的 Bash 或 Zsh)下,直接在未闭合的双引号或单引号内敲击回车,终端会自动保持换行输入状态。你可以在整个字符串内部直接书写符合 Python 语法的完整代码段:
python -m timeit "
total = 0
for x in range(100):
    total += x
"只要起始双引号和结束双引号之间保留了合法的缩进与换行,timeit 便能将其作为一个完整的模块代码执行。
方法 3:分号并列单行法(仅限简单语句)
如果待测代码段由多条简单的赋值或表达式构成,且彼此之间没有复合控制流(例如没有 for、while、try、if-else 结构),可以直接使用 Python 的语句分隔符分号 ;:
python -m timeit "a = 10; b = 20; c = a * b + 5"for i in range(10): s += i; print(s) 会引发语法错误或逻辑混淆。一旦涉及缩进块,请务必使用前述的方法 1 或方法 2。
三、关键机制:用 -s 参数分离“准备工作”与“待测代码”
在基准测试中,一个最容易犯的错误就是把数据生成的开销也算进了算法本身的运行耗时中。例如你想测试对一个包含 10,000 个随机数的列表进行排序的速度,如果把“生成随机列表”也放在被测代码段中,实际测出来的就是“生成数据 + 排序”的总时间,完全掩盖了排序算法的真实开销。
-s(即 --setup)参数正是用于解决此问题的关键机制。-s 指定的语句只在整个测试开始前执行 1 次(每个批次前初始化),且其执行耗时绝不计入循环统计结果中。
# 正确范例:在 -s 中导入模块并生成数据,在待测语句中只测试排序
python -m timeit -s "import random; data = [random.random() for _ in range(1000)]" "sorted(data)"
在上面的命令中:
-s "import random; data = [random.random() for _ in range(1000)]":负责把random库加载好,并在内存中构造出包含 1000 个浮点数的列表data;"sorted(data)":这是唯一的待测目标。timeit在数十万次循环中仅仅对sorted(data)进行高精计时。
此外,可以在一条命令中传入多次 -s 参数,它们会按先后顺序依序执行。例如:
python -m timeit -s "import math" -s "x = 45.0" "math.sin(x) + math.cos(x)"四、调控计时精度:核心参数 -n、-r、-u 的搭配
默认情况下,timeit 会自动尝试探测合适的循环次数,但在科学对比或编写自动化测试脚本时,我们通常需要显式指定循环与重复批次,以保持各组对比在同一标尺下。
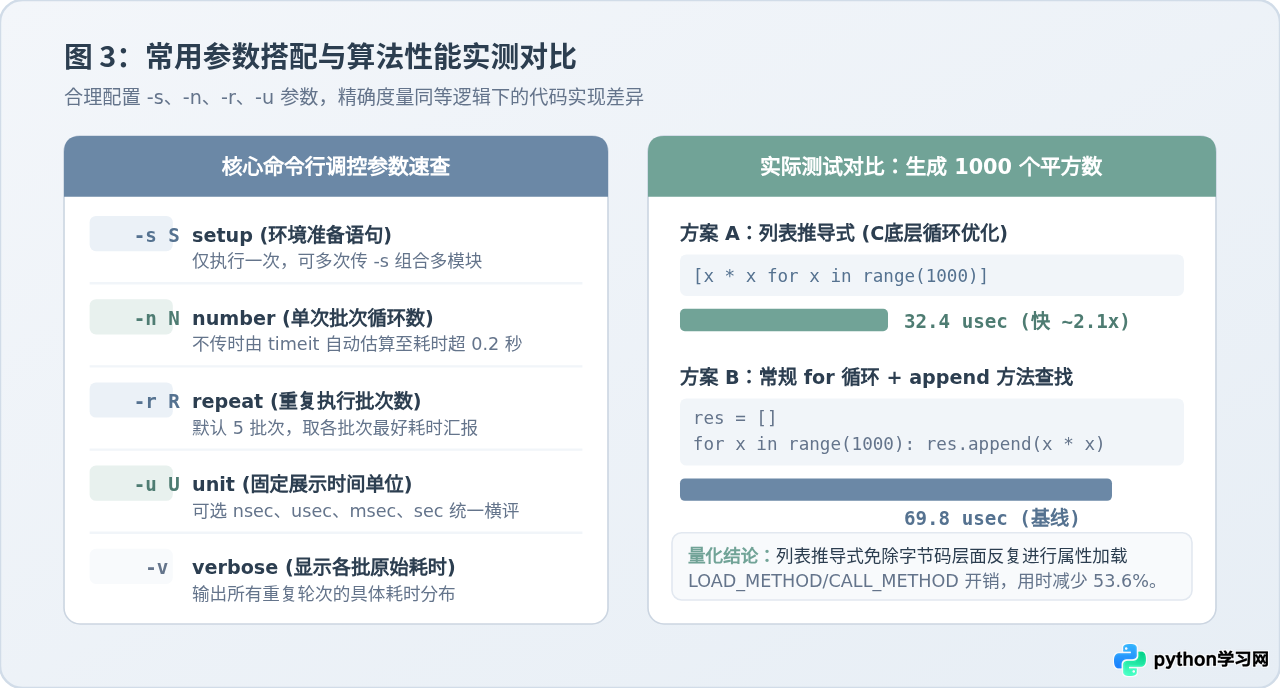
| 参数 | 完整名称 | 默认行为 | 作用与使用建议 |
|---|---|---|---|
-s S |
--setup=S |
pass |
准备语句,导入依赖、定义变量或函数,耗时不计入结果。 |
-n N |
--number=N |
自动估算 | 单批次内循环执行被测语句的次数。代码越快,N 应设置得越大(如 100000)。 |
-r R |
--repeat=R |
5 | 重复测量多少个独立批次。默认 5 批,最终输出各批次中表现最好的一次。 |
-u U |
--unit=U |
自动选择 | 时间显示单位,可选 sec、msec、usec、nsec。对比多组数据时建议统一指定。 |
-v |
--verbose |
关闭 | 详细模式,会打印每一组批次的原始总耗时,便于排查数据离散度。 |
精准控制的典型命令示例:
# 设定每个批次循环 10,000 次,共重复 7 轮,时间单位固定显示为微秒 (usec)
python -m timeit -n 10000 -r 7 -u usec "sum(range(500))"
输出示例:
10000 loops, best of 7: 6.42 usec per loop五、实战示例:列表推导式与 for 循环的性能对比
为了直观感受 python -m timeit 如何给多行代码段进行对比测量,我们来对比两种构造 1000 个偶数列表的写法:一种是使用 Python 习惯的“列表推导式”,另一种是传统的“多行 for 循环配合 append”。
测试 1:列表推导式
python -m timeit "[x * 2 for x in range(1000)]"测试输出:
20000 loops, best of 5: 35.8 usec per loop测试 2:多行 for 循环代码段
python -m timeit "res = []" "for x in range(1000):" " res.append(x * 2)"测试输出:
10000 loops, best of 5: 68.4 usec per loop通过清晰的参数传递,我们在完全一致的机器环境和测量标尺下得出了确凿的结论:在构造列表场景下,列表推导式依靠 C 语言层面的字节码优化,比在 Python 层面反复查找并调用 append 方法快了将近一倍(35.8 微秒 vs 68.4 微秒)。
六、高频踩坑与注意事项
在实际使用 python -m timeit 时,如果不了解其底层机制,容易得到误导性的性能数据或遇到运行时错误。以下是需要重点防范的四项原则:
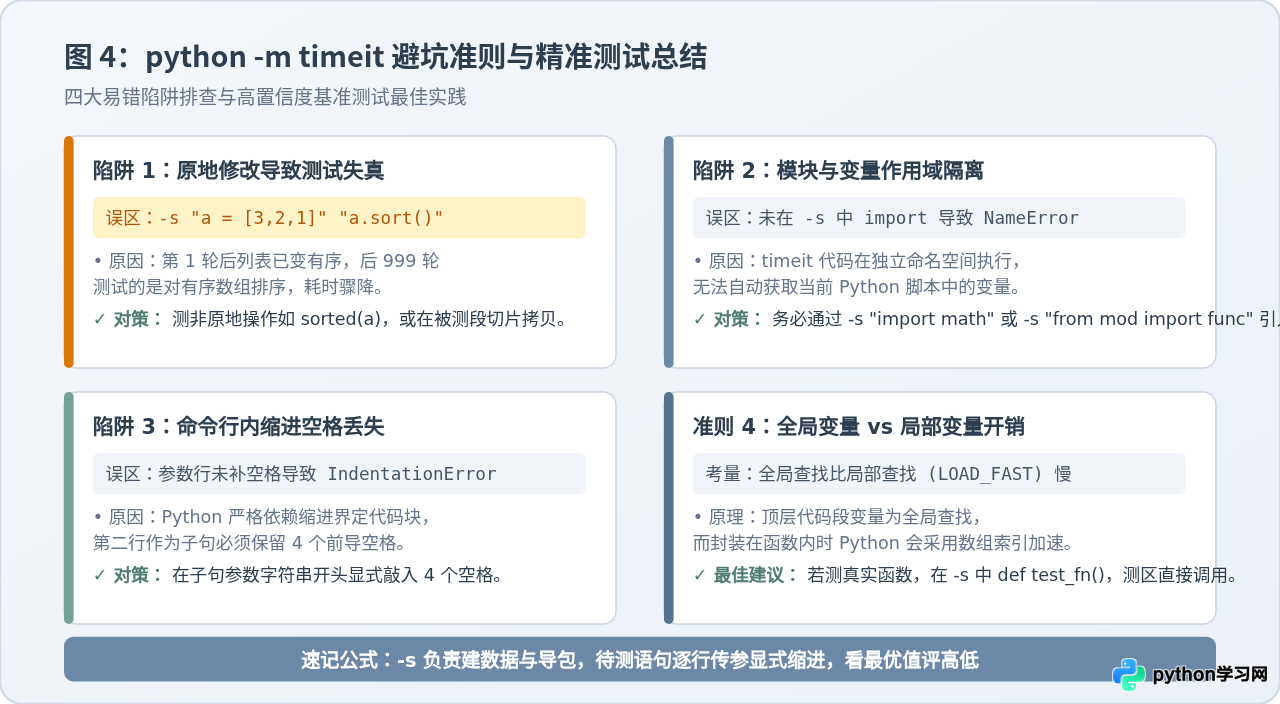
1. 警惕“原地修改”让测试失效
如果被测语句会对在 -s 中创建的容器进行“原地修改”(例如 list.sort()、list.pop() 或字典删除),在第一轮循环执行后,原本的数据状态就已经被破坏了:
# 错误示范:除了第 1 轮是在给逆序列表排序,后面数十万轮都是在给已经有序的列表排序!
python -m timeit -s "a = list(range(1000, 0, -1))" "a.sort()"正确对策:应测试非破坏性操作(如 sorted(a)),或者在被测语句中进行浅拷贝后再操作(如 a[:].sort(),或在测试段中复制测试数据)。
2. 命名空间隔离与自定义函数的引入
在当前目录下有一个自己写的 utils.py,里面定义了 process_data() 函数,直接执行 python -m timeit "process_data()" 会报错 NameError: name 'process_data' is not defined。
正确对策:必须在 -s 参数中显式导入当前模块:
python -m timeit -s "from utils import process_data" "process_data()"3. 全局查找与局部查找的差异
在模块顶层直接执行的代码,其变量属于全局变量(在 Python 虚拟机中使用 LOAD_GLOBAL 字节码指令);而封装在函数内部的代码,其局部变量使用的是经过数组索引优化的 LOAD_FAST 指令,速度通常明显更快。
如果你测试的最终用途是放在一个函数内部,建议在 -s 中直接定义一个测试函数,在被测语句中仅调用它:
python -m timeit -s "
def benchmark():
    total = 0
    for i in range(1000):
        total += i
    return total
" "benchmark()"
4. 终端特殊字符转义
在 Linux / macOS 的某些 Shell(如 Zsh、Fish)中,双引号内的特殊符号(如 $、!、反斜杠 \)可能被 Shell 预先解释。如果代码段中包含复杂字符串格式化(如 f-string f"{val}"),建议外层使用单引号包裹,防止 Shell 提前对变量符号或大括号进行替换展开。
七、总结与常用速查
掌握 python -m timeit 可以极大提升我们排查性能瓶颈和验证优化思路的效率。在日常使用中,牢记以下核心要领即可:
- 准备与被测分离:数据准备、模块导入写在
-s中,不污染计时。 - 多行代码逐参数写:每个新行用独立引号包起来,缩进处在字符串开头显式敲入 4 个空格。
- 定标尺:需要横向对比时,通过
-n和-r锁定轮次,使用-u统一度量单位。 - 看最好的一轮:以输出的
best of R为准,因为多任务系统中其他干扰只会使时间变长,最好的一次最接近无干扰的真实性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









