

Python urllib与requests处理URL有什么区别
深入对比 Python 标准库 urllib 与第三方流行库 requests 在 URL 解析、参数动态编码、网络请求、会话管理、底层连接复用及异常处理等方面的核心区别与选型策略。
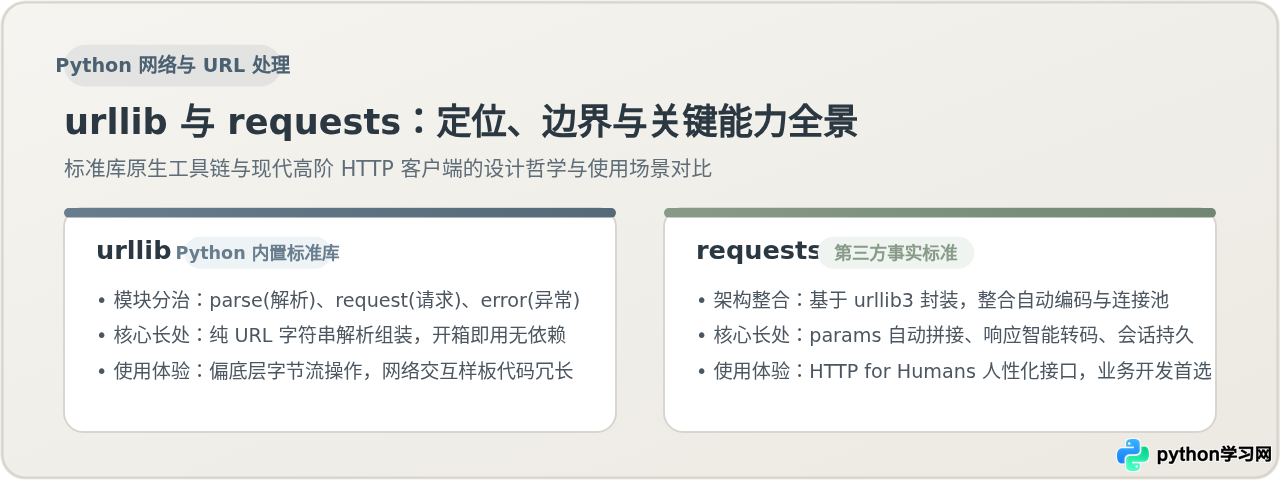
urllib 模块族提供了不需要安装任何依赖的官方原生实现,侧重底层协议规范与流式接口;而第三方库 requests 则专为“以最直观的方式完成 HTTP 交互”而设计,把参数自动编码、连接复用、会话保持与响应解析高度封装。理解两者的分工与关键差异,能够帮助我们在无需外部依赖的环境与高效率业务开发之间做出准确的技术选择。
一、架构定位与模块分工:拆解工具与网络客户端
很多开发者在刚接触 Python 网络编程时,容易把 urllib 和 requests 简单看作“新旧两个相同功能的库”。事实上,它们在架构设计、职责划分和依赖层级上存在本质区别。
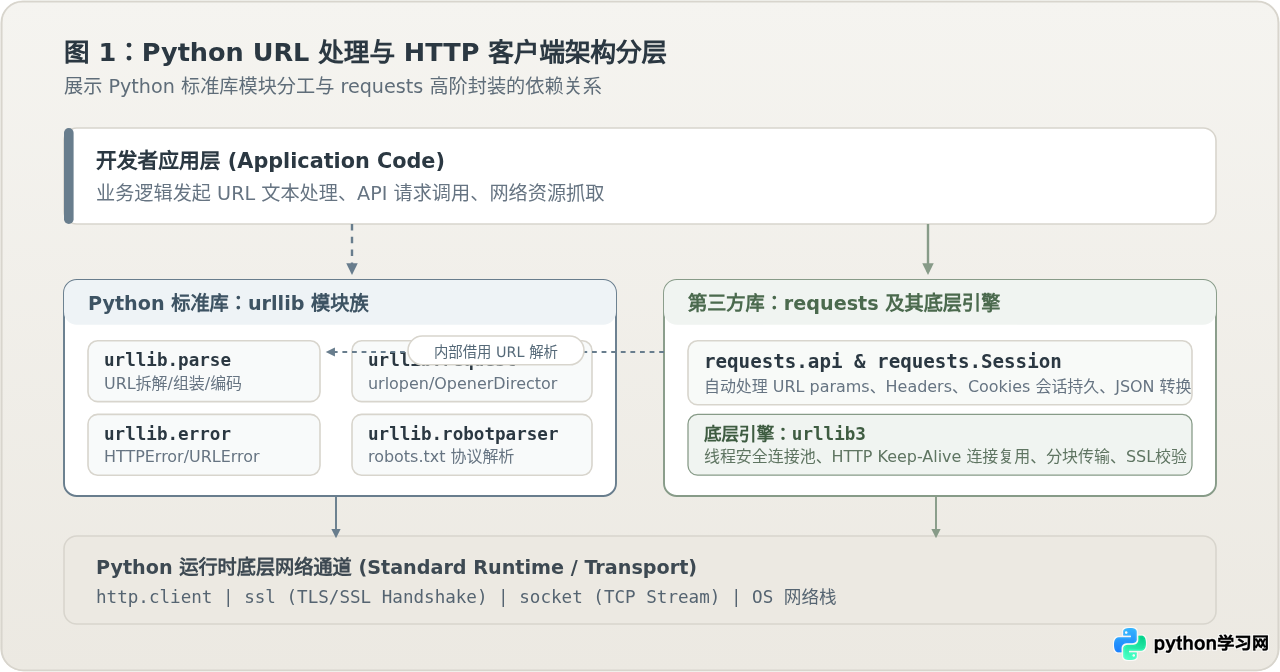
Python 3 将早期的相关工具统一整合成 urllib 包,内部明确划分为四个独立子模块:
urllib.parse:专门用于处理 URL 文本规范,提供路径拆分、组件合并、URL 相对路径解析以及参数编码(quote、urlencode等)。该模块完全不发起网络请求,纯粹在内存中操作字符串。urllib.request:提供基础的网络通信接口(urlopen、Request、OpenerDirector),直接通过底层的http.client和socket与服务端进行原始字节流交换。urllib.error:定义网络交互中可能出现的URLError和HTTPError异常类。urllib.robotparser:负责解析目标站点的robots.txt爬虫协议文件。
相比之下,requests 是一个高阶第三方库。它并不试图从零重写所有网络协议,而是基于成熟的底层连接库 urllib3 进行了精细的人性化封装(“HTTP for Humans”)。在面对 URL 处理时,requests 内部直接复用了标准库的解析机制,但在对外接口上完全抹平了手动转义、手动拼装 URL 的繁琐细节。
二、URL 的参数编码与动态拼接区别
Web 服务中,向 URL 传递查询参数(Query String)是最频繁的操作之一。根据 RFC 3986 规范,URL 查询串必须符合特定的字符集约束,中文字符、空格、特殊标点均需转换为合法的百分号编码(Percent-Encoding)。
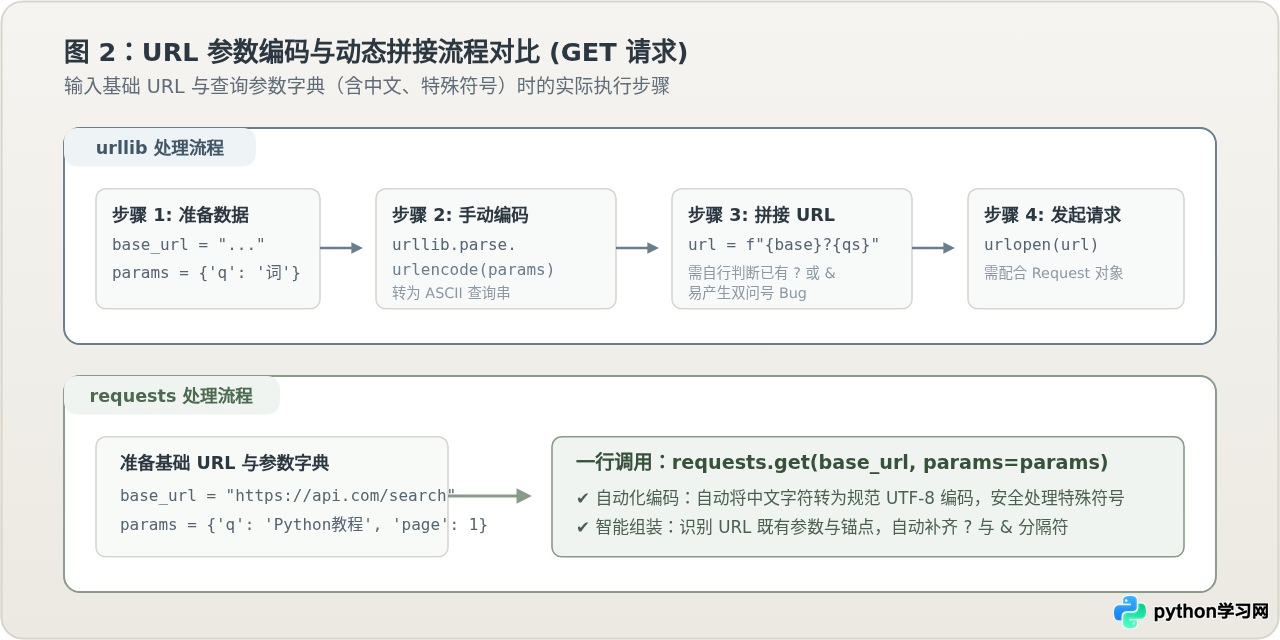
1. urllib 的手动编码与字符串拼接
使用 urllib 时,处理参数由 urllib.parse 子模块完成。开发者必须显式调用编码函数,并自行把生成的查询字符串拼接到目标 URL 上:
import urllib.parse
import urllib.request

base_url = "https://httpbin.org/get"
params = {
    "keyword": "Python网络编程",
    "page": 1,
    "filter": "status=active&type=doc"
}

# 步骤 1:手动将字典编码为符合规范的 query string
query_string = urllib.parse.urlencode(params)

# 步骤 2:手动拼接成完整 URL(需注意基础 URL 是否已存在问号)
full_url = f"{base_url}?{query_string}"

# 步骤 3:发起网络请求
req = urllib.request.Request(full_url, headers={"User-Agent": "Mozilla/5.0"})
with urllib.request.urlopen(req) as resp:
    print(resp.geturl())
https://api.com/items?version=2),开发者如果直接盲目追加 ?query_string,就会破坏 URL 结构导致请求失败。必须自行编写判断逻辑或通过 urllib.parse.urlsplit 和 urlunsplit 重新组装。
2. requests 的字典化自动装配
在 requests 中,URL 参数拼接被抽象为一个声明式的 params 参数。开发者只需传入普通的 Python 字典,库会自动处理编码、特殊符号转义以及已有参数的合并:
import requests

base_url = "https://httpbin.org/get"
params = {
    "keyword": "Python网络编程",
    "page": 1,
    "filter": "status=active&type=doc"
}

# 一步完成:内部自动识别编码,自动处理问号及连字符
response = requests.get(base_url, params=params, headers={"User-Agent": "Mozilla/5.0"})

# 最终实际请求的 URL 已正确完成 Percent-Encoding
print(response.url)
三、请求发起与响应数据解析的链路对比
当处理一个完整的 HTTP 请求周期(包括注入自定义 Headers、控制超时、提交数据并解析返回结果)时,两者的代码组织与执行模型差异更为显著。
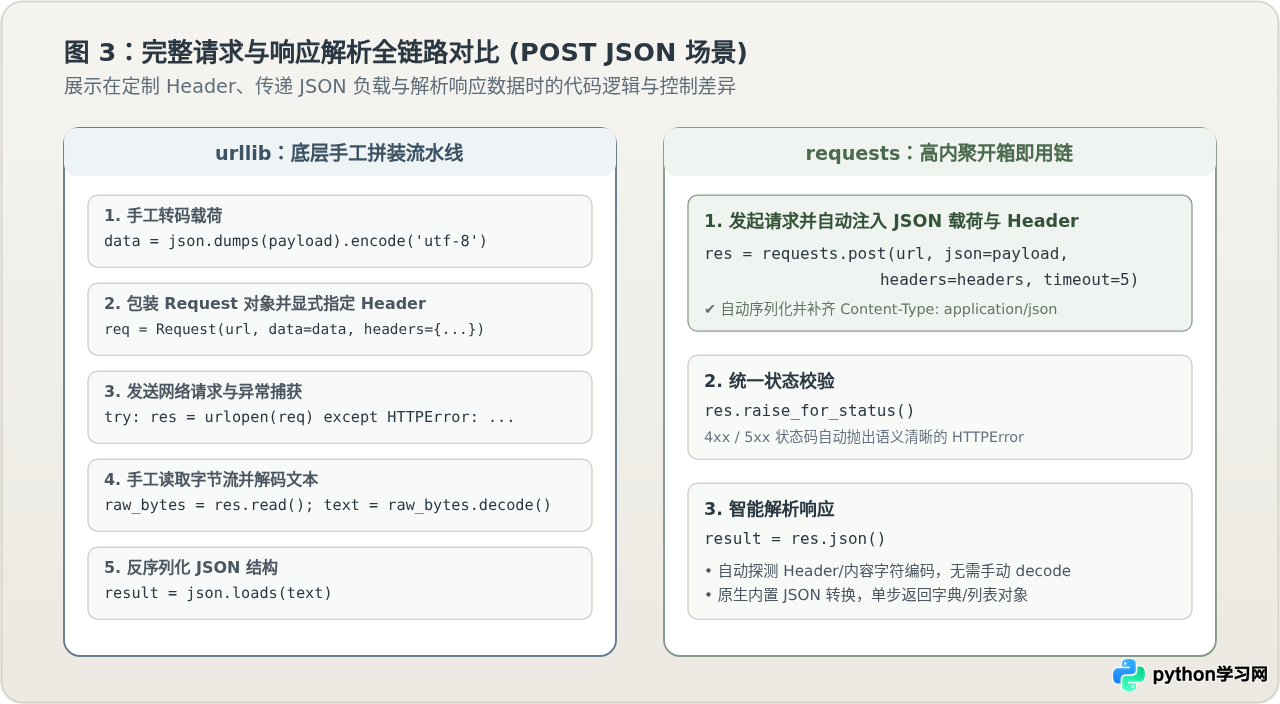
1. POST 请求与负载序列化
以向指定 URL 提交一段 JSON 格式的数据为例,两者的处理链路对比如下:
# --- urllib 方式 ---
import json
import urllib.request
import urllib.error

url = "https://httpbin.org/post"
payload = {"title": "URL处理对比", "author": "Python开发"}

# 1. 手动将字典序列化为 JSON 字符串,再编码为二进制字节
data_bytes = json.dumps(payload).encode('utf-8')

# 2. 构造 Request 对象,并显式指定 Content-Type 和 Content-Length
headers = {
    "Content-Type": "application/json; charset=utf-8",
    "User-Agent": "Python-urllib"
}
req = urllib.request.Request(url, data=data_bytes, headers=headers, method="POST")

try:
    with urllib.request.urlopen(req, timeout=10) as resp:
        # 3. 读取原始字节流并手动按照服务端字符集解码
        raw_body = resp.read()
        text_body = raw_body.decode('utf-8')
        # 4. 手动反序列化为字典
        result = json.loads(text_body)
except urllib.error.HTTPError as e:
    # HTTP 错误状态码会作为异常抛出,错误响应体需从异常实例中读取
    print(f"HTTP 错误: {e.code}, 内容: {e.read().decode('utf-8')}")
except urllib.error.URLError as e:
    print(f"网络不可达: {e.reason}")
# --- requests 方式 ---
import requests

url = "https://httpbin.org/post"
payload = {"title": "URL处理对比", "author": "Python开发"}

try:
    # 一步完成:自动 JSON 序列化、自动注入 Header、自动超时控制
    res = requests.post(url, json=payload, headers={"User-Agent": "Python-requests"}, timeout=10)
    # 统一状态码检查,若为 4xx / 5xx 则自动抛出 HTTPError
    res.raise_for_status()
    # 自动识别字符集编码并解析为结构化字典
    result = res.json()
except requests.exceptions.HTTPError as e:
    print(f"HTTP 异常: {e},响应体内容: {res.text}")
except requests.exceptions.RequestException as e:
    print(f"网络通信失败: {e}")
urllib 默认返回裸字节流(bytes),如果目标网页是 GBK 或 UTF-8,开发者若未先解析 Content-Type 响应头而直接 .decode('utf-8'),遇到非 UTF-8 编码的 URL 内容就会直接抛出 UnicodeDecodeError。requests 则内置字符集分析器(chardet/charset_normalizer),会同时参考 HTTP 头与 HTML 文本特征自动设定 response.encoding,读取 response.text 时自动完成安全解码。
四、底层连接复用与会话(Session)保持
在处理需要连续访问多个相关 URL 的场景(例如带鉴权登录、持续抓取数据、连续调用同一服务器的微服务接口)时,网络底层的连接维护直接决定了程序的性能与实现复杂度。
1. 连接池与 TCP Keep-Alive
urllib.request 的 urlopen 默认是一次性的。每次调用都会经历一次完整的 DNS 解析、TCP 三次握手和 TLS/SSL 证书校验。若在循环中连续请求同一主机的 100 个 URL,会发起 100 次完整的 TCP 建立与销毁,不仅网络延迟高,而且在并发时容易耗尽操作系统的临时端口。
requests 基于 urllib3 构建,其内部默认实现了线程安全的连接池(Connection Pool)。当复用同一个 requests.Session() 对象时,底层会自动保持与服务器的 Keep-Alive 长连接,后续针对相同 host 的 URL 请求将直接复用既有通道,耗时显著缩短。
2. Cookie 与会话追踪
许多网站在用户访问登录 URL 之后,通过 Set-Cookie 头部下发状态凭据。若后续请求其他受保护的 URL,客户端必须将这些 Cookie 自动回传:
- urllib 实现方式:需要手动组装一系列 Handler。开发者必须导入
http.cookiejar.CookieJar,实例化urllib.request.HTTPCookieProcessor,再使用urllib.request.build_opener()绑定生成专属的OpenerDirector对象,代码结构相当复杂。 - requests 实现方式:仅需一行
session = requests.Session(),后续所有session.get(url)和session.post(url)请求都会全自动捕获、持久化并回传相应的 Cookie,行为与现代浏览器一致。
五、核心差异对比与选型决策指南
为了直观展现两者在开发实践中的主要差异,下表列出了核心维度的综合对比:
| 对比维度 | 标准库 urllib | 第三方库 requests |
|---|---|---|
| 依赖成本 | Python 官方内置,零依赖,开箱即用 | 需通过 pip 安装第三方包及其依赖项 |
| URL 结构拆解 | 由 urllib.parse 提供,功能全面完备 |
无专有拆解 API,内部同样依赖标准库 |
| 参数编码拼接 | 需调用 urlencode 手动拼接字符串 |
直接传入 params={...} 字典,全自动处理 |
| JSON 载荷支持 | 需手动 dumps() 并 .encode() 转为字节 |
直接传入 json={...},自动序列化并设 Header |
| 响应内容解码 | 返回原始 bytes,需手动识别编码并解码 | 内置智能编码推断,提供 .text 与 .json() |
| 底层连接复用 | 默认短连接,需自定义复杂 Handler 实现池化 | 默认集成 urllib3 连接池与 HTTP Keep-Alive |
| Cookie 会话维持 | 需搭配 http.cookiejar 与自定义 Opener |
使用 requests.Session() 开箱即用 |
| 重定向控制 | 默认跟随,若需拦截需重写 RedirectHandler | 直接使用 allow_redirects=False 开关控制 |
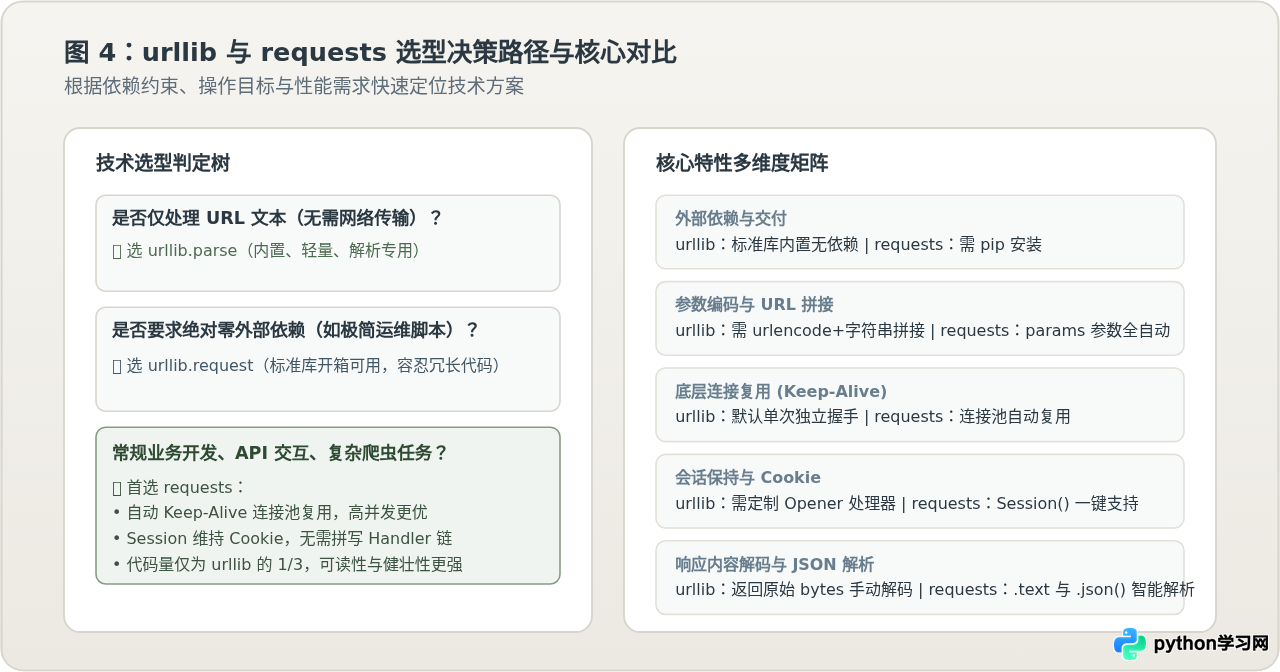
适用场景与选型建议
-
纯 URL 文本处理任务:推荐
urllib.parse
如果你的工作内容是提取 URL 中的域名、判断协议是 HTTP 还是 HTTPS、从给定的长链接中解析查询参数,或者安全转义特定路径片段,完全不需要发起网络连接,那么标准库的urllib.parse(如urlparse、urlsplit、parse_qs、quote)是最轻量、最高效的选择。 -
环境受限的独立运维脚本:推荐
urllib.request
在某些特定的服务器生产环境、无公网访问的内网机器、受限的 Docker 极简基础镜像或需要打包成单文件的独立运维脚本中,安装外部依赖受到严格限制。此时,利用内置的urllib.request编写基础的健康检查或接口触发调用,能够保证脚本在任何标准 Python 解释器上立即可行。 -
主流 Web 开发、数据采集与 API 对接:首选
requests
在绝大多数现代业务开发场景中,可维护性、开发效率和健壮性是核心考量。requests极度简洁的接口不仅能减少 60% 以上的样板代码,还能有效规避字符集转码、连接泄漏、参数转义遗漏等初学者极易踩坑的问题。其开箱即用的连接池和会话机制,在面对网络吞吐和稳定性要求较高的任务时优势明显。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









