

Python汉诺塔非递归实现:基于栈的迭代算法
本文详细讲解如何使用Python显式栈结构实现汉诺塔问题的非递归解法。通过模拟系统递归调用帧的生命周期,消除系统递归深度限制,附带完整代码与步骤原理解析。
解决汉诺塔问题最经典的途径是递归,但当盘片数量增加或运行环境对递归深度有严格限制时,系统调用栈容易发生溢出(RecursionError)。实现非递归汉诺塔的核心,在于使用 Python 自定义列表作为显式栈,手动模拟函数调用帧入栈与出栈的执行时序。本文将拆解递归调用的底层运行机理,给出完整的基于显式栈的迭代算法实现与状态跟踪逻辑。
一、为什么需要显式栈模拟递归
在 Python 默认配置下,解释器的递归深度上限通常为 1000 左右(可通过 sys.getrecursionlimit() 查询)。常规递归算法依赖操作系统和解释器维护的“系统调用栈”。每次函数调用发生时,系统都会在内存中压入一个包含参数、局部变量和返回地址的栈帧。
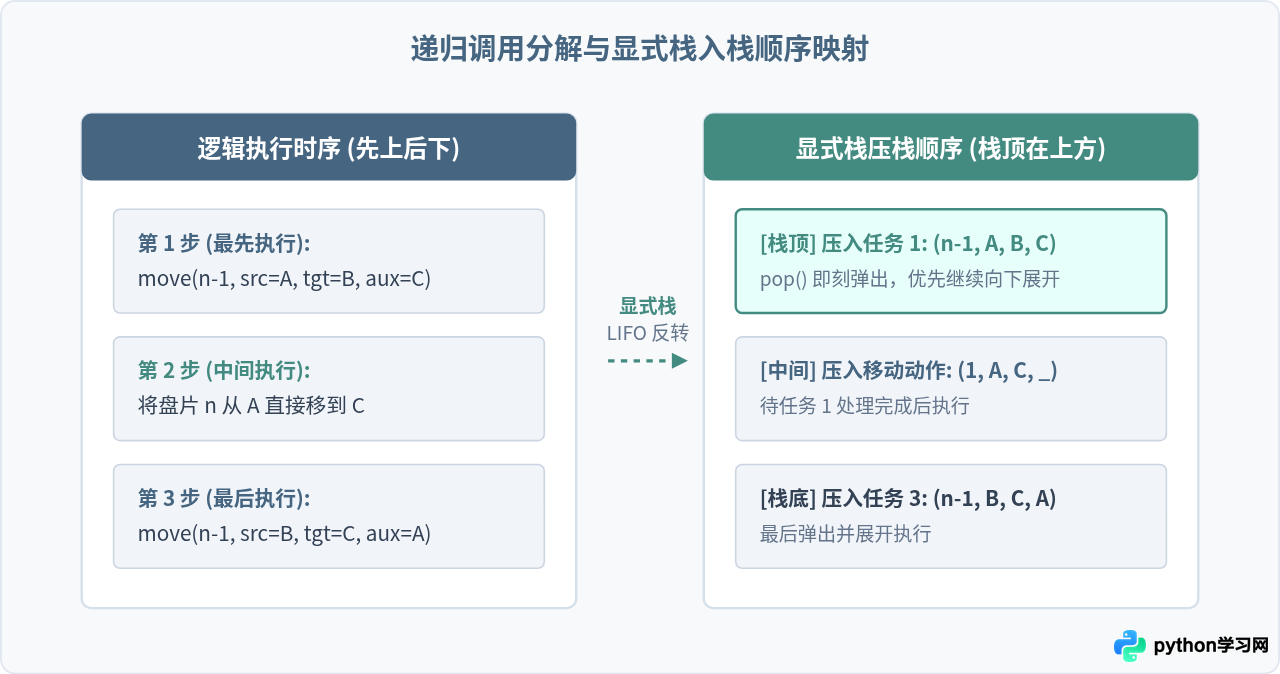
汉诺塔问题的标准分治逻辑包含三步:
- 将上面
n-1个盘子从起始柱借用目标柱移动到辅助柱; - 将底部的第
n个盘子直接从起始柱移动到目标柱; - 将辅助柱上的
n-1个盘子借用起始柱移动到目标柱。
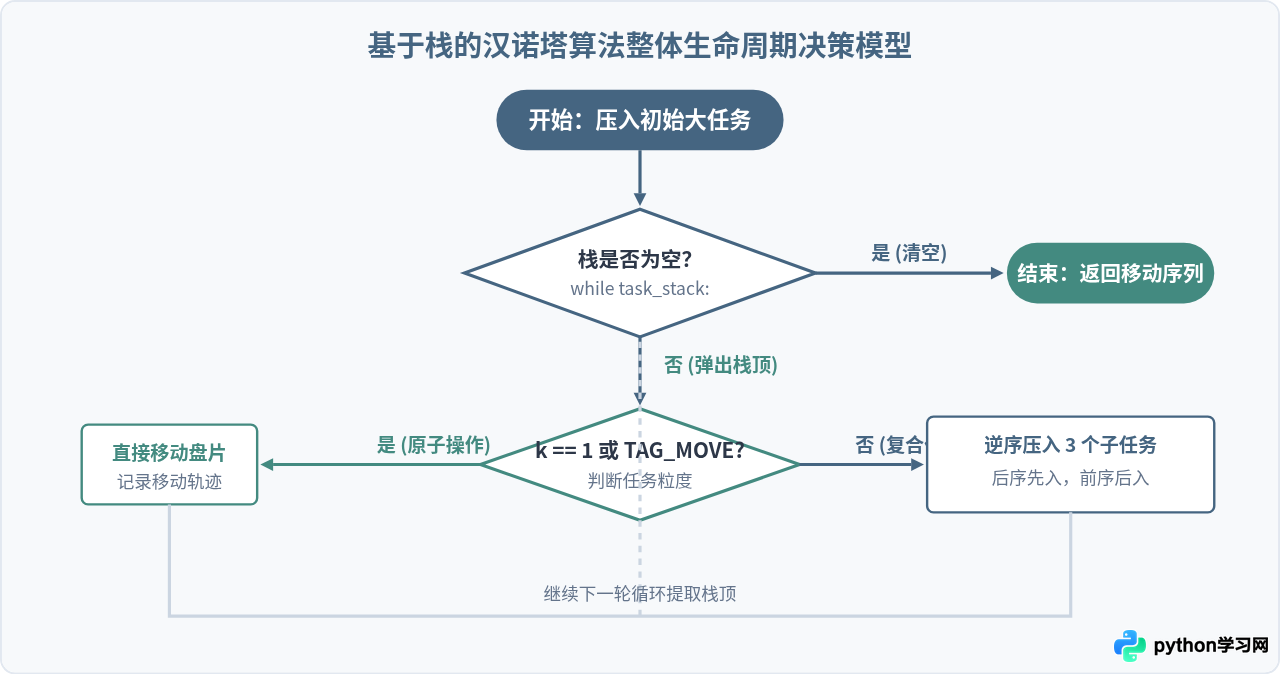
由于栈具有后进先出(LIFO)的特性,若我们用 Python 列表手动维护这些任务,入栈的顺序必须与实际执行顺序相反:后执行的子任务先压入栈底,先执行的子任务留在栈顶以便即时弹出。
二、状态定义与调用帧结构设计
为了让栈能够精确区分“需要继续拆解的递归子任务”与“可以直接挪动盘片的原子动作”,我们可以在入栈元组中引入动作标识(Action Tag):
MOVE:表示当前任务已退化为单盘移动,直接从原柱弹出盘片并压入目标柱;SUB_PROBLEM:表示当前盘数k > 1,需要将其拆分为三个连续动作并按逆序入栈。
显式栈元素使用标准元组 (tag, k, source, target, auxiliary) 表示。其中 k 为盘片数量,source、target、auxiliary 分别代表当前子问题的起始柱、目标柱与辅助柱名称。
三、基于显式栈的迭代算法完整实现
以下为 Python 3 编写的完整独立代码。程序不仅输出了每一次移动轨迹,还通过维护柱子的物理列表,严格检验移动过程中是否满足“大盘永远不能压在小盘上方”的汉诺塔规则。
def hanoi_iterative_stack(n, source_name="A", target_name="C", aux_name="B"):
    """
    基于显式栈实现的非递归汉诺塔算法
    :param n: 盘片总数 (正整数)
    :param source_name: 起始柱标识
    :param target_name: 目标柱标识
    :param aux_name: 辅助柱标识
    :return: 移动步骤列表 [(disk, from_peg, to_peg), ...]
    """
    if n <= 0:
        return []

    # 1. 初始化三根柱子的物理状态 (列表末尾为柱顶盘片)
    pegs = {
        source_name: list(range(n, 0, -1)),
        aux_name: [],
        target_name: []
    }

    # 2. 状态标签常量
    TAG_EXPAND = 0  # 需要进一步拆解为子问题
    TAG_MOVE = 1    # 最小粒度:直接执行移动

    # 3. 初始化显式任务栈,压入初始规模的全局问题
    # 元组格式: (操作类型, 规模k, 起始柱, 目标柱, 辅助柱)
    task_stack = [(TAG_EXPAND, n, source_name, target_name, aux_name)]

    move_records = []
    step_counter = 0

    # 4. 循环迭代模拟调用栈
    while task_stack:
        action, k, src, tgt, aux = task_stack.pop()

        if action == TAG_MOVE or k == 1:
            # 执行原子盘片移动
            step_counter += 1
            disk = pegs[src].pop()

            # 安全合法性断言:若目标柱非空,被放置盘片必须小于柱顶盘片
            if pegs[tgt] and pegs[tgt][-1] < disk:
                raise ValueError(f"非法移动: 盘片 {disk} 不能压在盘片 {pegs[tgt][-1]} 之上")

            pegs[tgt].append(disk)
            move_records.append((disk, src, tgt))
            print(f"步骤 {step_counter:2d}: 将盘片 {disk} 从 [{src}] 移到 [{tgt}] | 状态: A={pegs['A']}, B={pegs['B']}, C={pegs['C']}")
        else:
            # 规模大于 1,拆解为三个步骤,并按 LIFO 逆序压入栈中:
            # 逻辑步骤 3: 将 k-1 个盘从 aux 移动到 tgt (借助 src)
            task_stack.append((TAG_EXPAND, k - 1, aux, tgt, src))

            # 逻辑步骤 2: 将第 k 个盘直接从 src 移动到 tgt
            task_stack.append((TAG_MOVE, 1, src, tgt, aux))

            # 逻辑步骤 1: 将 k-1 个盘从 src 移动到 aux (借助 tgt)
            task_stack.append((TAG_EXPAND, k - 1, src, aux, tgt))

    return move_records

if __name__ == "__main__":
    total_disks = 3
    print(f"=== 开始执行 {total_disks} 阶汉诺塔非递归显式栈算法 ===")
    records = hanoi_iterative_stack(total_disks)
    print(f"=== 执行完毕,共完成 {len(records)} 次移动 (理论值 2^{total_disks}-1 = {2**total_disks - 1}) ===")
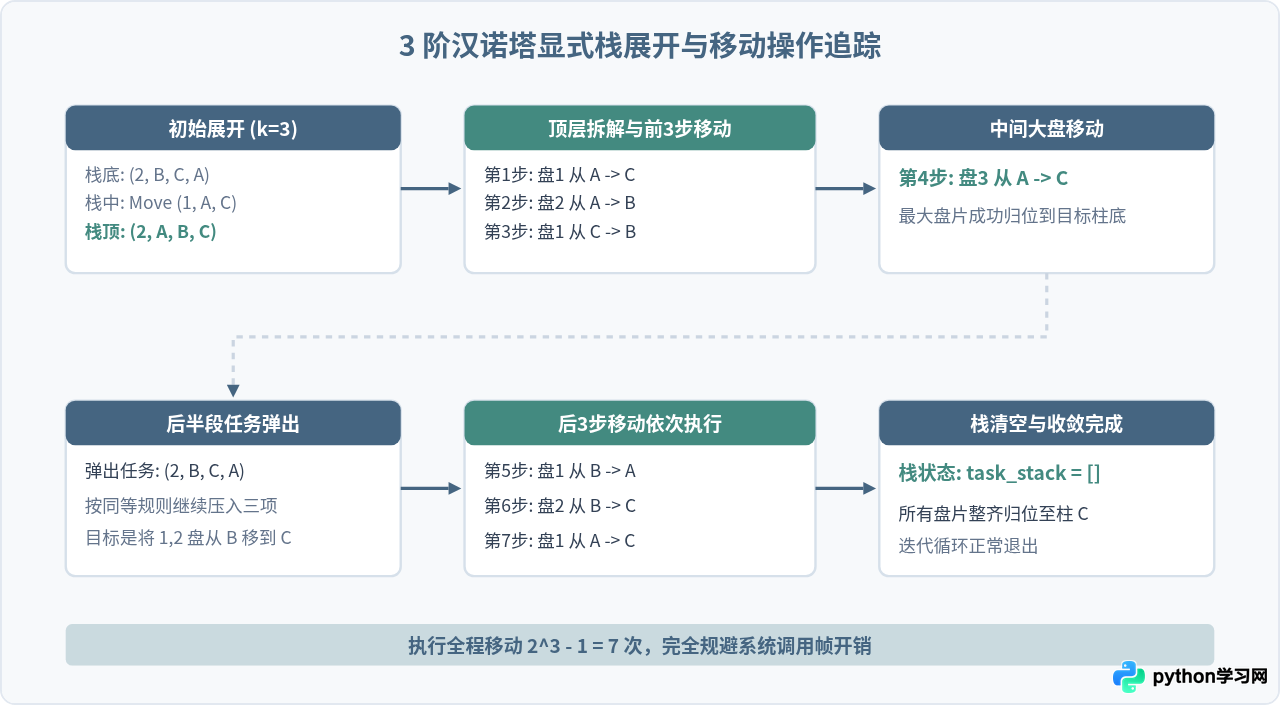
n = 3 时,算法输出恰好为 7 次移动。每次出栈后更新柱子字典,控制台打印直观显示盘片在 A、B、C 之间的实时物理流转,且没有发生任何深度递归。
四、系统递归栈与显式堆内存栈机制对比
虽然递归算法与显式栈算法的渐近时间复杂度均为 \(O(2^n)\),但在执行开销、存储空间分布以及容错能力上存在显著本质差别:
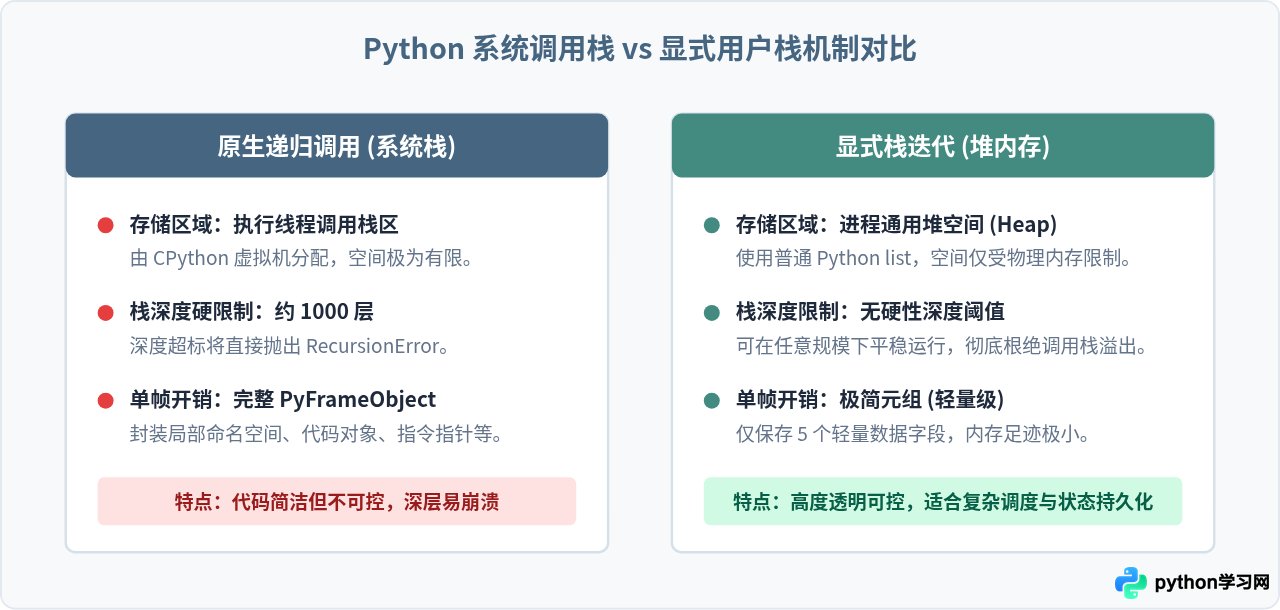
| 比较维度 | 传统递归方案 | 基于列表的显式栈方案 |
|---|---|---|
| 实现机制 | 依赖编译器与解释器的调用指令 | 手写 while stack: 循环驱动 |
| 最大深度限制 | 受 sys.setrecursionlimit() 限制 |
无上限,取决于系统空闲 RAM 大小 |
| 暂停与恢复能力 | 极为困难,无法直接序列化执行栈 | 极易实现,仅需保存 task_stack 列表 |
| 空间复杂度 | \(O(n)\) 系统栈开销 | \(O(n)\) 堆内存开销(栈中最多保留 \(3n\) 个元素) |
五、算法执行流程与工程细节考量
在工程落地或面试讲解过程中,使用显式栈实现非递归算法必须特别关注以下三个核心细节:
- 柱子角色动态轮转:递归展开时,三根柱子在子任务中的角色不断互换。例如把
k-1盘移到辅助柱时,原问题的目标柱变成了临时辅助柱。在压入栈元组时,务必精确对应形参名与实参位置。 - 栈的最大深度峰值:对于
n阶汉诺塔,尽管总步数是 \(2^n - 1\),但在任何单一时刻,显式栈内驻留的元素个数上限仅为 \(3n\)。因为一旦遇到TAG_MOVE或k=1,栈顶元素立即被消耗,不会无限制膨胀。 - 与二进制计数法(Bitwise Method)的区别:除了栈模拟,汉诺塔还有基于奇偶位移动律或格雷码的纯数学解法。但基于栈的实现具有无可比拟的通用价值——它展示了如何将任何复杂的递归算法(如树的遍历、回溯搜索等)改写为迭代循环的标准工程范式。
六、总结
通过使用显式列表模拟调用栈,汉诺塔问题从一个依赖编译器内部机制的黑盒递归调用,转化为完全由开发者自主掌控的数据结构迭代过程。这种方法不仅彻底消除了 Python 递归深度对大盘片数量的限制,而且为断点保存、动态步骤回放及复杂状态校验提供了扎实的底层架构基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









