

为什么数据科学搭建环境常选conda而不是venv?
深入对比数据科学与机器学习场景下选用 Conda 与 venv 的根本原因。从底层 C/C++/Fortran 二进制依赖分发、GPU CUDA 工具链隔离、Python 解释器版本自包含管理,到跨平台可复现性进行全面解析与实操指导。
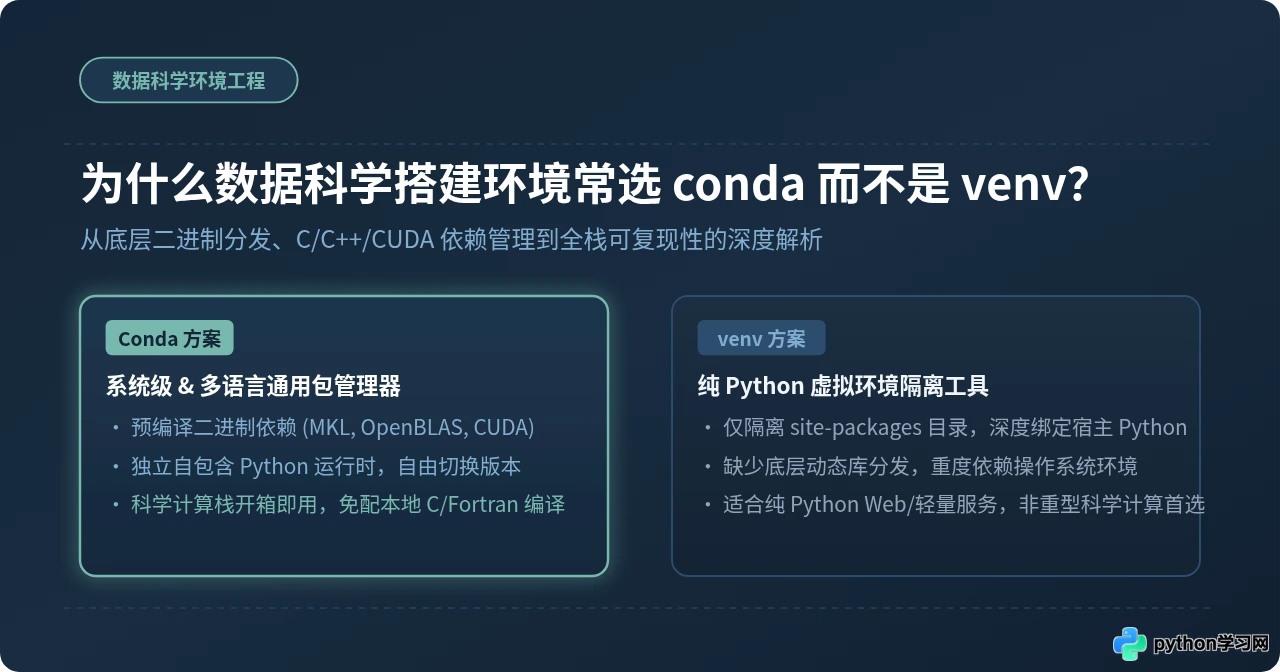
venv 搭配 pip 几乎是标准实践;但在数据科学与机器学习项目中,开发者与团队却普遍优先选择 conda(或 Miniconda / Mamba)。核心原因在于:数据科学依赖的核心库并非纯 Python 代码,而是高度依赖 C/C++、Fortran 底层数学计算库以及 NVIDIA CUDA 等硬件加速工具链。 venv 本质上只是 Python 解释器之上的 site-packages 目录隔离工具,无法分发和管理系统级动态链接库;而 conda 是一个系统级通用包与环境管理器,能够将特定版本的 Python 解释器本身以及全部底层的预编译二进制动态库打包隔离,实现真正的开箱即用与跨平台复现。
一、核心差异:包管理器的定位与管理层级截然不同
假设我们需要在本地部署一个需要 GPU 加速的 PyTorch 训练工程。如果使用 venv,第一步需要确保宿主机安装了与项目匹配的 Python 大版本,并手动在操作系统层面安装正确版本的 CUDA 驱动库、C++ 编译器以及 BLAS 线性代数库;一旦系统缺少这些底层组件,安装时往往会直接报出编译错误。而使用 conda,只需一条安装命令,它会自动将对应的 Python 运行时、CUDA 运行时组件(cudatoolkit)和 Intel MKL 数学库整体下载并注入当前环境。
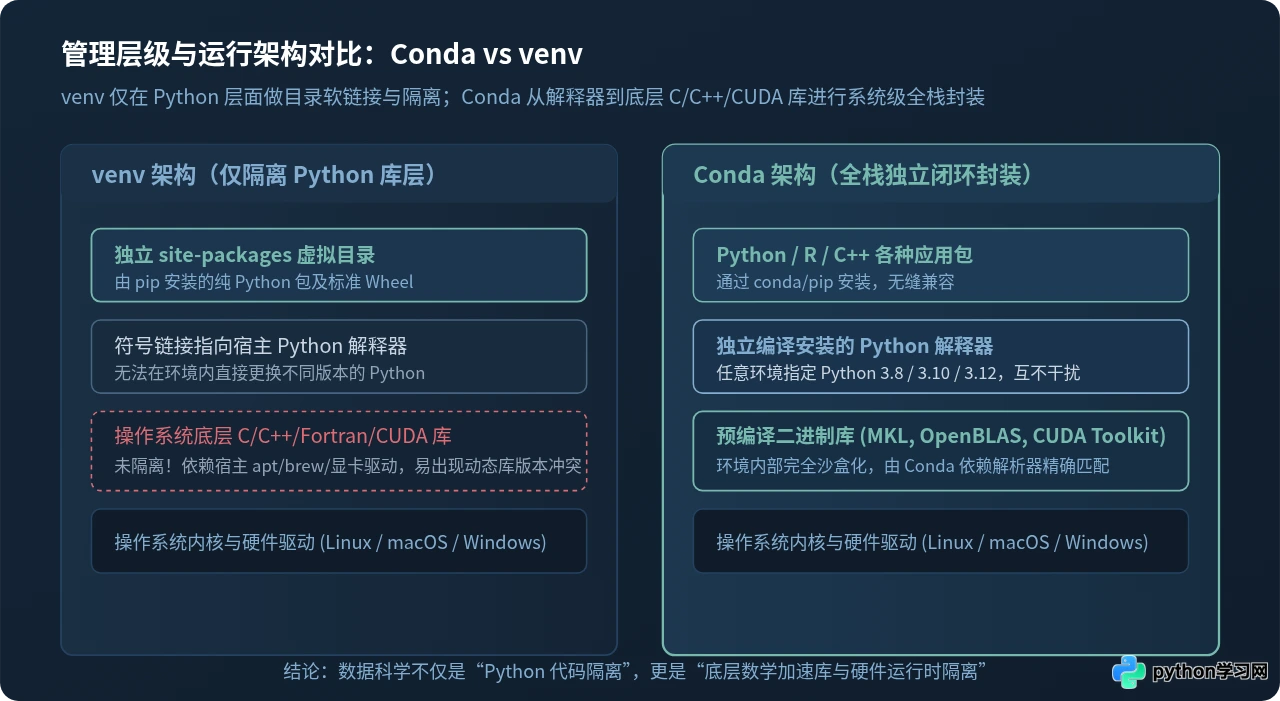
这种体验差异的根源,来自于两者截然不同的设计定位与管理层级:
- venv 的本质:它是 Python 3.3 起内置的标准库模块,其职责仅仅是在操作系统现有的 Python 解释器外部,创建一个包含独立
bin(或Scripts)与site-packages的沙盒目录。它不负责安装 Python 自身,也无法干预操作系统层面的 C/C++ 动态链接库(.so / .dll / .dylib)。 - conda 的本质:它最初由 Anaconda 开发,定位是跨语言、系统级通用二进制包与环境管理器。在 Conda 的视角中,Python 本身也仅仅是一个名为
python的普通二进制依赖包。Conda 既管理 Python 代码,也管理编译工具链、CUDA、OpenBLAS、HDF5、GDAL 等任意语言编写的二进制依赖。
二、底层二进制分发:破解科学计算库的编译与链接痛点
NumPy、SciPy、Pandas 以及 PyTorch 等数据科学基础库,其核心计算引擎全部使用 C、C++ 或 Fortran 编写,以获得极致的矩阵计算性能。这就引出了两套工具链在“分发与安装机制”上的本质分歧。
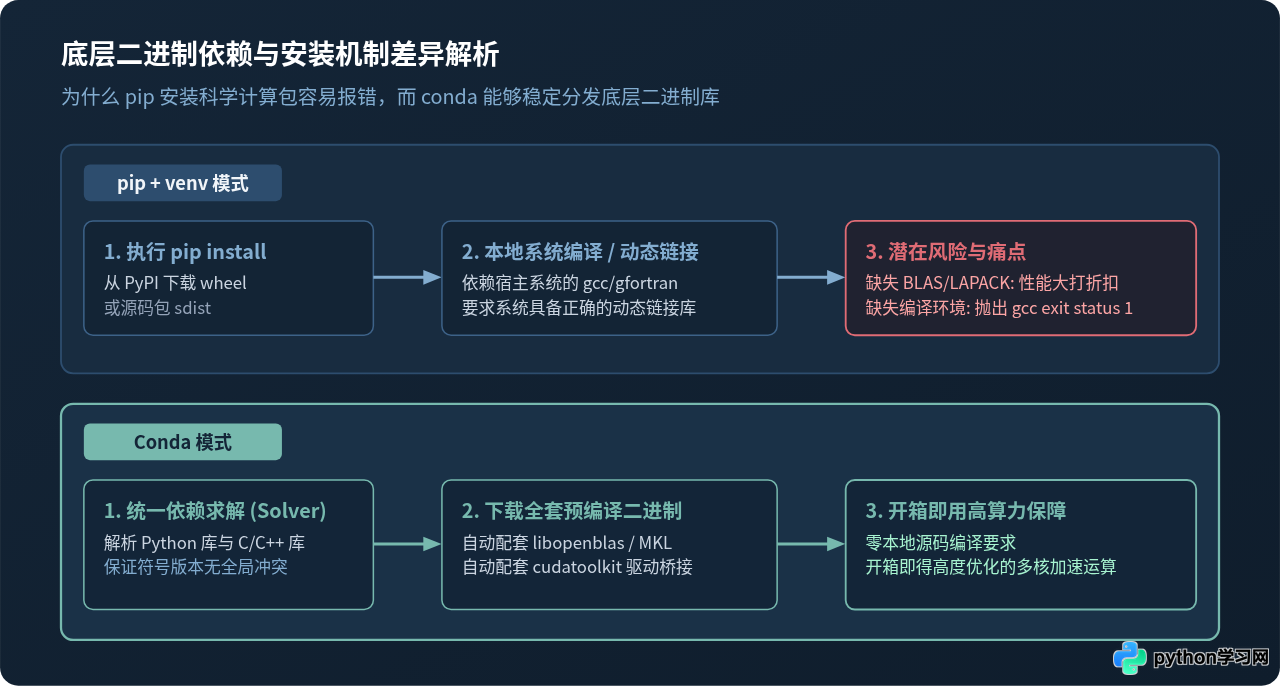
1. pip + venv 的安装逻辑与限制
在 venv 环境中,安装依赖主要通过 pip 从 PyPI 下载。虽然现代 PyPI 提供了预先构建的 wheel 二进制格式(如 manylinux),但轮子内部依然无法完整打包系统级硬件驱动或复杂的专用加速组件。当遇到以下场景时,pip 往往陷入困境:
- 宿主机操作系统的 GLIBC 或 C++ 运行时库版本过旧,导致预编译的 wheel 无法加载符号表。
- 找不到适配平台的二进制 wheel,
pip退化为下载sdist源码包并在本地触发构建。此时若本地未安装gcc、gfortran或对应头文件,终端便会抛出极其冗长晦涩的编译失败日志。 - 线性代数后端(如 ATLAS、OpenBLAS、Intel MKL)未能正确链接,使得 NumPy 运算性能大幅下降数十倍。
2. Conda 的二进制依赖解析方案
Conda 拥有自己独立的软件仓库(如 Anaconda 官方频道和社区维护的 conda-forge)。Conda 仓库中存放的所有包均为严格经过统一环境构建的预编译二进制包。
当执行 conda install numpy 时,Conda 的依赖求解器(SAT Solver)不仅解析 NumPy 自身的版本,还会同步解析并下载经过深度优化的底层数学库(例如 mkl 或 libopenblas)。所有二进制文件均直接解压到当前虚拟环境的 lib/ 目录下,环境内部自动完成动态库路径绑定。开发者哪怕是在一台刚装好系统的纯净机器上,也能在没有安装任何本地编译工具的前提下,直接获得满血性能的科学计算栈。
pip,宿主机往往必须预先正确安装完整匹配的 NVIDIA CUDA Toolkit;而通过 Conda 安装时,Conda 会在虚拟环境内自带兼容的运行时动态库,无需污染全局系统环境。
三、Python 运行时自包含:彻底告别操作系统版本绑定
在实际数据科学项目中,不同的开源模型或论文复现代码往往限定了严苛的 Python 版本。例如,某个早期图像算法库只支持 Python 3.8,而最新的 LLM 框架推荐使用 Python 3.11。
在这个场景下,venv 的机制缺陷十分明显:python -m venv myenv 创建出的环境,其内部 Python 版本完全由当前终端调用的那个 python 可执行程序决定。如果操作系统自带的是 Python 3.12,你无法通过 venv 直接凭空创建一个 Python 3.8 的环境;必须先通过操作系统包管理器(apt/brew)、源码自编译或借助 pyenv 等第三方工具安装 Python 3.8,然后再去调用对应的可执行文件创建 venv。
而在 Conda 中,切换 Python 版本仅需一条参数即可完成:
# Conda 支持任意指定 Python 版本,自动下载对应解释器二进制包
conda create -n py38_env python=3.8 -y
conda create -n py311_env python=3.11 -y
每个 Conda 环境都拥有一份真正独立的、自包含的 Python 二进制文件及标准库。不同环境之间完全隔离,既不会干扰操作系统的系统级 Python 工具(如 Linux 系统内的 yum/dnf 或 cloud-init),也不会在环境卸载时留下残留文件。
四、实操对比:数据科学环境的标准搭建与配置步骤
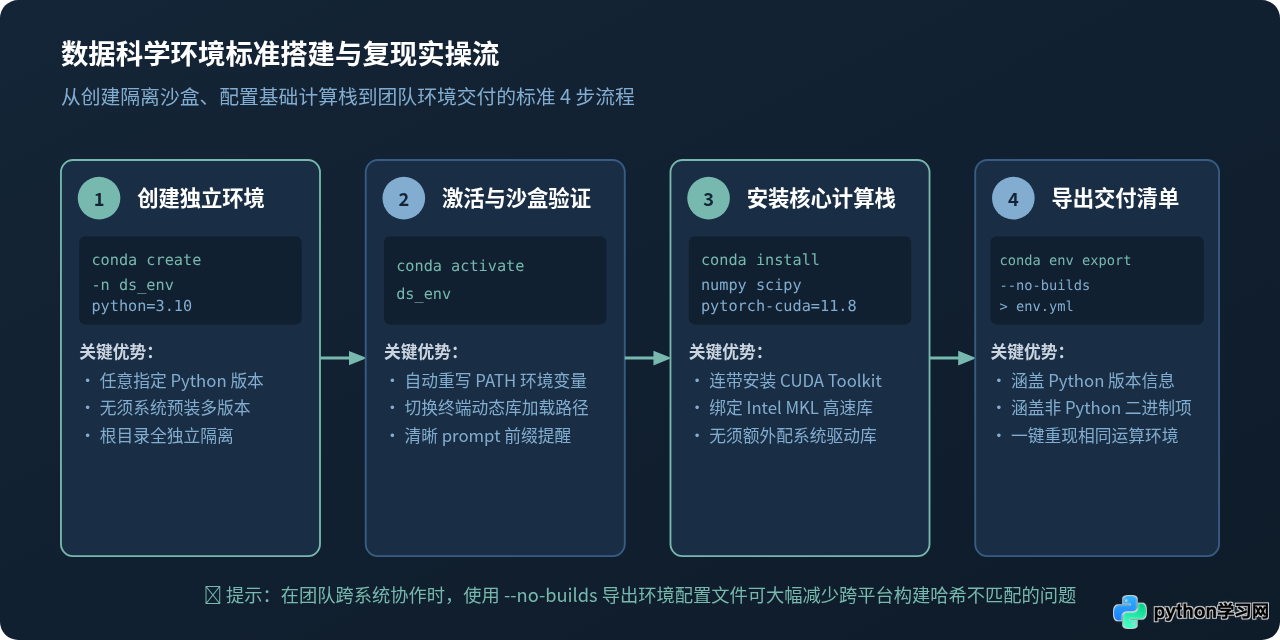
为了直观展示两者的操作差异,以下演示在全新 Linux/macOS 工作机上,为机器学习项目搭建一个包含 Python 3.10、PyTorch(含 CUDA 11.8 运行时支持)与 Pandas 计算栈的完整操作流程。
1. Conda 环境的标准操作步骤
# 步骤 1:创建指定 Python 版本的独立环境
conda create -n ml_research python=3.10 -y

# 步骤 2:激活隔离环境
conda activate ml_research

# 步骤 3:安装深度学习框架与科学计算包(自动捆绑 CUDA 运行时与 MKL)
conda install pytorch torchvision torchaudio pytorch-cuda=11.8 -c pytorch -c nvidia -y
conda install pandas scikit-learn matplotlib -y

# 步骤 4:验证当前环境中的底层依赖与 GPU 支持
python -c "import torch, numpy; print('PyTorch CUDA 可用:', torch.cuda.is_available()); print('NumPy 配置 BLAS:', numpy.__config__.show())"

# 步骤 5:导出环境配置清单供协作团队复现
conda env export --no-builds > environment.yml
2. venv 环境下的对应操作与前置条件
# 前置准备:宿主机必须已经提前安装好 Python 3.10 与系统级 CUDA Toolkit 11.8
# 检查宿主 Python 3.10 是否存在
python3.10 --version

# 步骤 1:基于指定的 Python 解释器创建 venv 虚拟环境
python3.10 -m venv ./ml_research_venv

# 步骤 2:激活虚拟环境
source ./ml_research_venv/bin/activate

# 步骤 3:通过 pip 安装 PyTorch 与科学计算库
pip install --upgrade pip
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu118
pip install pandas scikit-learn matplotlib

# 步骤 4:导出 Python 依赖清单
pip freeze > requirements.txtpip freeze 输出的 requirements.txt 只记录了 Python 包名称和版本,完全忽略了宿主机的 Python 大版本、CUDA 驱动运行时以及底层 C 库。当把该文件发送给另一位同事时,如果对方的操作系统缺少对应的 C++ 编译库或显卡驱动环境,运行代码依然可能失败;而 environment.yml 明确记录了 Python 解释器本身及全部依赖,复现可靠性显著更高。
五、特性横向对比与选型决策指南
尽管 Conda 在数据科学领域占据统治地位,但这并不意味着 Conda 在所有场景下都优于 venv。了解两者的权衡与边界,才能在工程实践中做出最合理的选型。
| 对比维度 | Conda / Mamba | Python 标准库 venv |
|---|---|---|
| 核心定位 | 多语言、系统级通用包与环境管理 | 轻量级纯 Python 虚拟环境隔离 |
| 底层依赖分发 | 自带预编译 C/C++/Fortran/CUDA 库 | 无二进制分发能力,完全依赖操作系统 |
| Python 解释器版本 | 支持在环境内部自由切换与安装 | 无法安装 Python,绑定宿主既有解释器 |
| 环境启动与解析速度 | 依赖解析较复杂(推荐使用 Mamba 加速) | 秒级创建,无复杂求解负担,运行轻量 |
| 磁盘空间与镜像体积 | 基础运行时较大(数十 MB 到数 GB 不等) | 仅几 KB 符号链接与纯 Python 包 |
| 典型适用领域 | 机器学习、深度学习、空间地理信息、生物计算 | Web 后端(FastAPI/Django)、轻量微服务、CLI 工具 |
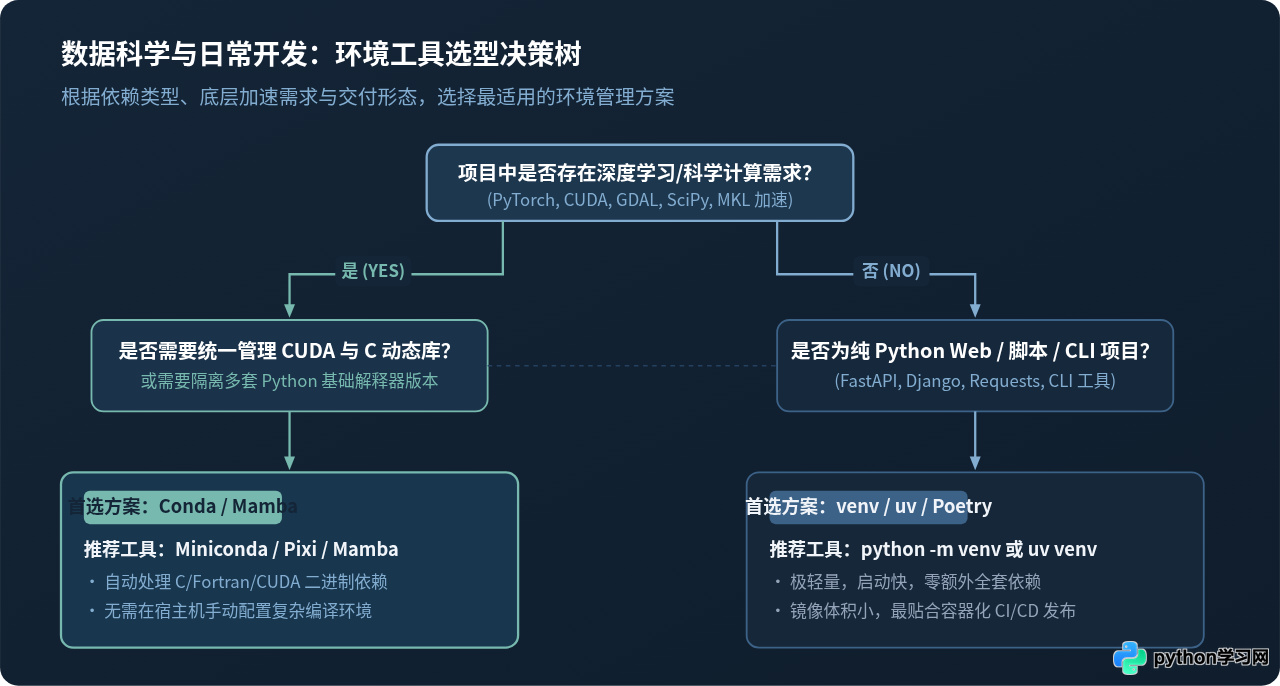
明确的选型建议:
- 必须选用 Conda 的场景:
- 涉及深度学习框架(PyTorch、TensorFlow、JAX)且需要配置 GPU CUDA 加速;
- 项目包含复杂的地理信息处理库(如 GDAL、GEOS)、生物信息学工具(如 Bioconda 软件栈)或需要 R 与 Python 混编;
- 本地宿主机操作系统权限受限(没有 root/sudo 权限),无法使用 apt/yum 安装系统级 C/C++ 依赖库。
- 推荐选用 venv 的场景:
- 纯 Python 开发任务,如使用 FastAPI、Flask、Django 编写 Web API;
- 云原生容器化部署(Docker)。在 Docker 镜像内,基础操作系统镜像已经固化,直接使用
python -m venv或现代工具uv可以将最终镜像体积控制在最小范围; - 编写轻量级自动化测试脚本或简单的命令行运维工具。
六、实践总结与现代替代方案
早期 Conda 最为人诟病的缺点是依赖解析速度慢和安装包体积庞大。为了解决这一问题,现代数据科学工程领域已普遍转向更为高效的演进工具:
- Miniconda 代替完整版 Anaconda:不再预装几百个用不上的预置科学计算包,保持最初仅几十兆的基础体积,按需安装。
- Mamba / micromamba:使用 C++ 重写了 Conda 的底层依赖求解核心与多线程下载模块,将原本数分钟的依赖求解缩短至数秒,同时完全兼容 Conda 的命令与
environment.yml格式。 - Pixi:基于 Rust 构建的新一代跨平台包管理工具,底层同样基于 Conda 庞大的
conda-forge生态,支持像cargo一样通过单个项目锁文件管理多语言科学计算环境。
综合来看,数据科学领域之所以普遍拥抱 Conda,并非出于习惯,而是底层科学计算与硬件驱动生态的刚性需求决定的。选择 Conda,本质上是用一套成熟的系统级沙盒封装掉了繁杂易错的底层编译与动态库链接,让研究人员和工程师能够将全部精力聚焦于数据本身与模型算法逻辑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









