

Python词云怎么过滤停用词:提升内容相关性的设置方法
详细讲解在Python中使用wordcloud和jieba库过滤中文停用词的实用方法,包含停用词表加载、分词过滤、参数配置、代码示例与常见问题排查,有效提升词云主题相关性。
在 Python 中生成词云(主要使用 wordcloud 库)时,默认的过滤机制仅针对英文停用词,直接处理中文文本会导致“的”、“了”、“在”、“是”、“以及”等高频虚词占据整幅图像的核心位置。要有效提升词云的内容相关性,核心做法分为双层治理:一是在使用 jieba 等中文分词工具切词时进行显式匹配过滤,二是在实例化 WordCloud 对象时通过 stopwords 参数传入自定义停用词集合(Set)。通过结合外部权威停用词表与业务特定噪声词,可以精准剔除无意义词汇,让核心主题与高价值信息清晰凸显。
一、停用词过滤机制与处理流水线
词云生成的底层逻辑是“文本分词 → 词频统计 → 字体大小按频次映射渲染”。原生 wordcloud.WordCloud 内置的 STOPWORDS 集合只包含约两百个常见英文虚词(如 the、and、is)。中文语言并没有自然空格隔开单词,必须先借助中文分词器将连续句子拆解为词语序列。
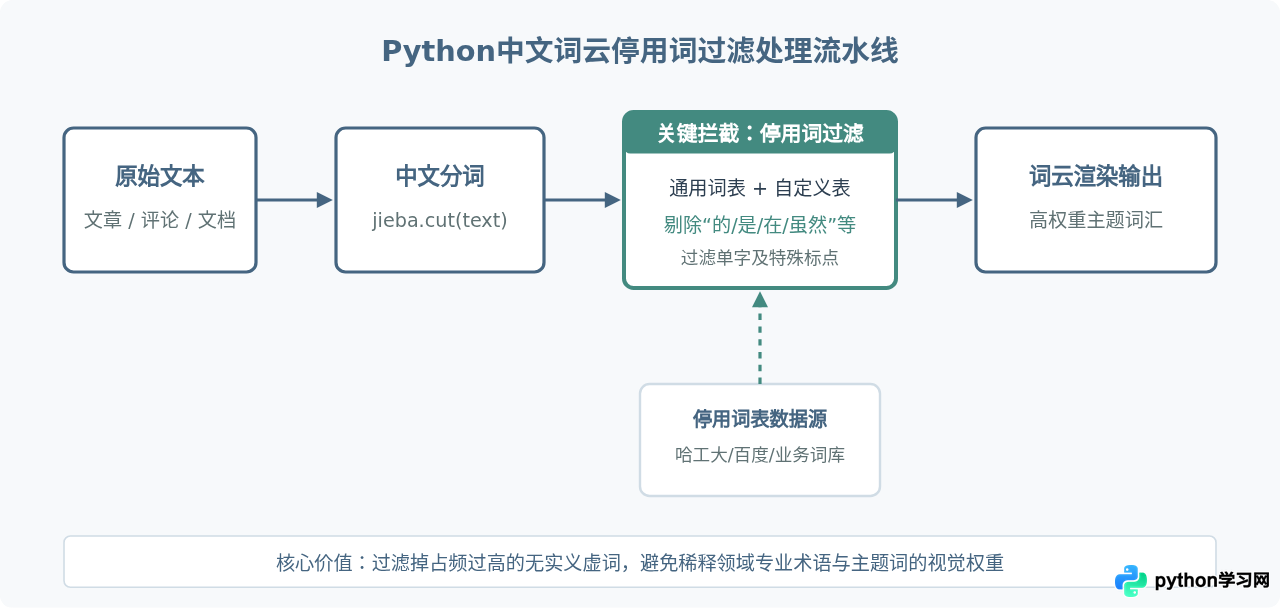
如果分词之后直接拼接空格送入词云生成器,而没有配置中文停用词,分词器产出的助词、连词、语气词和量词就会因为极高的自然语言出现概率,占据词频榜首位。完整的中文词云数据流水线应当在文本预处理与模型渲染之间建立拦截屏障,如下图所示:
二、标准配置步骤与完整实现代码
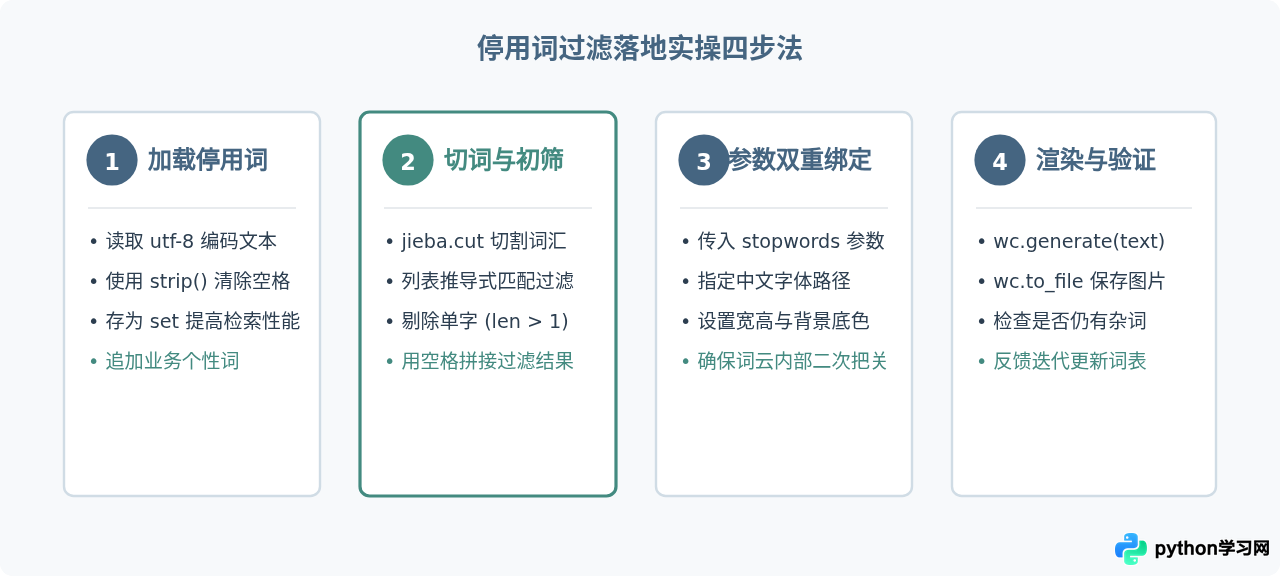
实施停用词过滤应按规范分为四个紧密相连的步骤:准备词表文件、分词过滤、配置 WordCloud、渲染保存。
1. 准备停用词表
常见的开源停用词表包括“哈工大停用词表”、“百度停用词表”以及“中文停用词库(SCU)”。停用词文件通常为纯文本格式(.txt),每行存放一个词。读取时必须显式指定 encoding='utf-8',并通过 strip() 去除首尾的换行符和不可见空白。
2. 完整执行代码示例
下面是一段可直接运行的 Python 脚本,演示如何结合 jieba 与 WordCloud 进行严格的停用词过滤:
import os
import jieba
from wordcloud import WordCloud

# 1. 模拟文本与停用词列表(实际应用中可读取本地 txt 文件)
raw_text = """
Python 是一种广泛使用的高级编程语言。通过 Python 进行数据分析和可视化非常方便。
在文本挖掘中,词云是一种非常直观展示高频词汇的方法。
但是,如果不进行停用词过滤,很多像“我们”、“因为”、“以及”、“虽然”这样的词汇就会大量出现,
从而严重影响分析结果的准确性和展示效果。
"""

# 2. 构建停用词集合 (使用 set 可以获得 O(1) 的极速匹配效率)
# 基础停用词集合
custom_stopwords = {
    "的", "了", "在", "是", "我", "有", "和", "就", "不", "人", "都", "一",
    "一个", "上", "也", "很", "到", "说", "要", "去", "你", "会", "着",
    "没有", "看", "好", "自己", "这", "但是", "因为", "以及", "虽然",
    "这样", "如果", "进行", "很多", "像", "非常", "从而"
}

# 若从外部文本文件加载,可用以下标准函数:
def load_stopwords_file(filepath):
    stopwords = set()
    if os.path.exists(filepath):
        with open(filepath, 'r', encoding='utf-8') as f:
            for line in f:
                word = line.strip()
                if word:
                    stopwords.add(word)
    return stopwords

# 3. 预处理:分词并做前置过滤(不仅过滤停用词,还可过滤单字与空字符)
seg_list = jieba.cut(raw_text)
filtered_words = []
for word in seg_list:
    word = word.strip()
    # 过滤条件:词长大于1、不在停用词表中、不是纯数字标点
    if len(word) > 1 and word not in custom_stopwords:
        filtered_words.append(word)

# 将过滤后的词语用空格连接成字符串,供 WordCloud 接收
processed_text = " ".join(filtered_words)

# 4. 配置 WordCloud 对象
# 注意:Windows 系统可使用 'C:/Windows/Fonts/msyh.ttc' (微软雅黑)
# macOS 系统可使用 '/System/Library/Fonts/PingFang.ttc'
font_path = "msyh.ttc"  # 请替换为本地实际支持中文的字体路径

wc = WordCloud(
    font_path=font_path,
    width=800,
    height=450,
    background_color='white',
    stopwords=custom_stopwords,  # 传入停用词集合作为二次防线
    collocations=False,          # 禁用词云自动搭配词组合,避免重复拼词
    max_words=100
)

# 5. 生成词云并保存
wc.generate(processed_text)
wc.to_file("wordcloud_result.png")
print("词云生成完毕,高相关性词汇已成功聚焦!")
三、过滤前后的效果对比与相关性提升
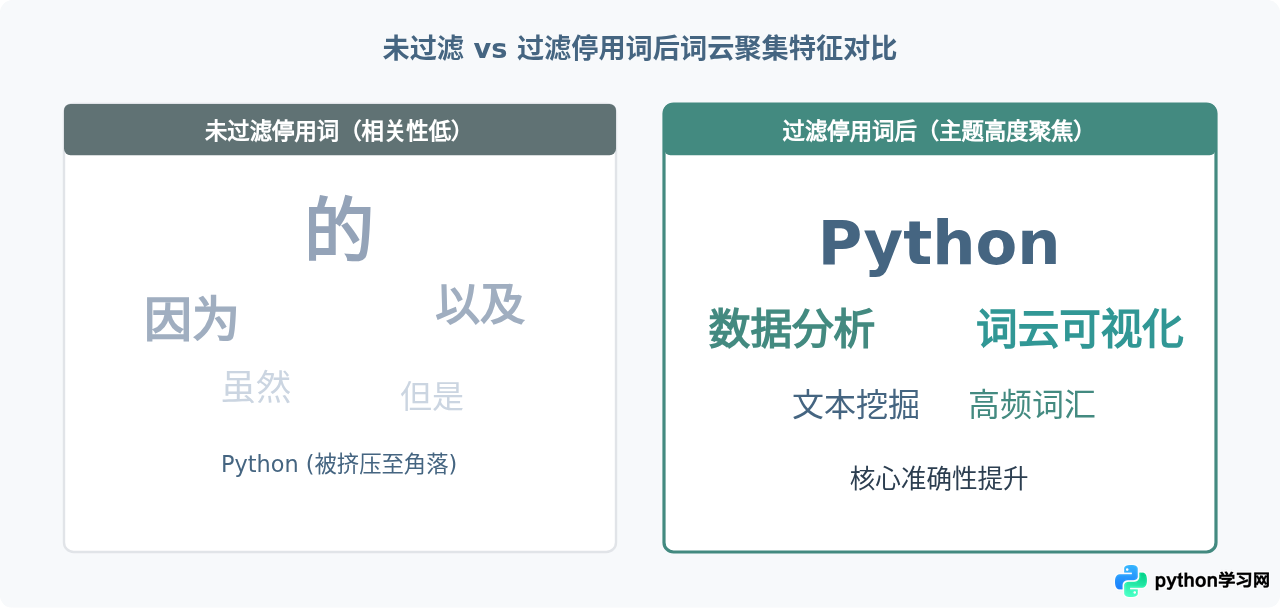
停用词过滤对词云视觉与语义分析的影响是决定性的。未经过滤时,停用词由于词频基数大,会呈现出“越无用、字号越大”的反常现象;实施精确过滤后,行业专有名词与实际表达概念成为主角。
四、提升相关性的进阶设置技巧
在日常数据清洗实践中,单纯套用通用的停用词表往往还不够。许多具有行业背景的公文、技术报告或电商评论会存在大量“合规但无信息量”的高频泛词。以下三个技巧能进一步压榨噪声:
1. 动态合并领域业务停用词
利用 Python set.update() 方法,可以在基础词表之上动态扩充行业噪声词。例如:在分析汽车评论时,“汽车”、“车辆”、“买车”虽然是实词,但对区分车型优缺点没有任何帮助,应将其视作特定业务场景的停用词动态加入:
# 动态扩充领域套话
business_stopwords = {"整体", "方面", "情况", "使用", "进行", "表示", "指出"}
custom_stopwords.update(business_stopwords)
2. 关闭词组自动搭配(collocations=False)
WordCloud 默认开启了 collocations=True 属性,旨在自动识别双词搭配。但对于已经经过结巴精确分词的中文文本,该特性可能导致同一个实词与前后词连带重复拼接出现(如“数据 分析”被重复算作词组),造成权重异常。将其设为 collocations=False 可保证只按独立词频精确统计。
3. 单字与标点符号预清洗
许多分词残留的单字(如“各”、“该”、“每”、“某”)和标点符号难以通过通用词表完全枚举。在推导生成切词结果列表时,直接加上 len(word) > 1 这一过滤条件,能以极小代价清除超过 80% 的零碎噪声。
五、常见问题排查与避坑指南
避坑核心点:停用词必须在文本送入 generate() 之前完成过滤,或者将由空格分隔好的词串同时配合 stopwords 参数传入,确保逻辑双重生效。
| 常见故障表现 | 诱发原因分析 | 针对性解决办法 |
|---|---|---|
| 传了 stopwords 但停用词依然出现 | 直接将未分词的长文本喂给了 WordCloud,或者停用词文本包含换行符/空格导致字符串匹配失败。 | 必须先用 jieba 切词并用空格拼接;读取停用词表时严格使用 line.strip() 清理首尾空白。 |
| 词云中文显示为“方块口口”乱码 | WordCloud 默认字体为 DroidSans,无法映射中文字符集。 | 显式配置 font_path 参数,指向系统中包含中文字体的真实路径(如 simhei.ttf 或 msyh.ttc)。 |
| 专业名词被分词器误切成碎片 | 专业术语或新词未包含在 jieba 默认词库中,被当成多个单字切碎,导致部分被误过滤。 | 分词前调用 jieba.load_userdict("user_dict.txt") 或 jieba.add_word("专有名词") 保护实体。 |
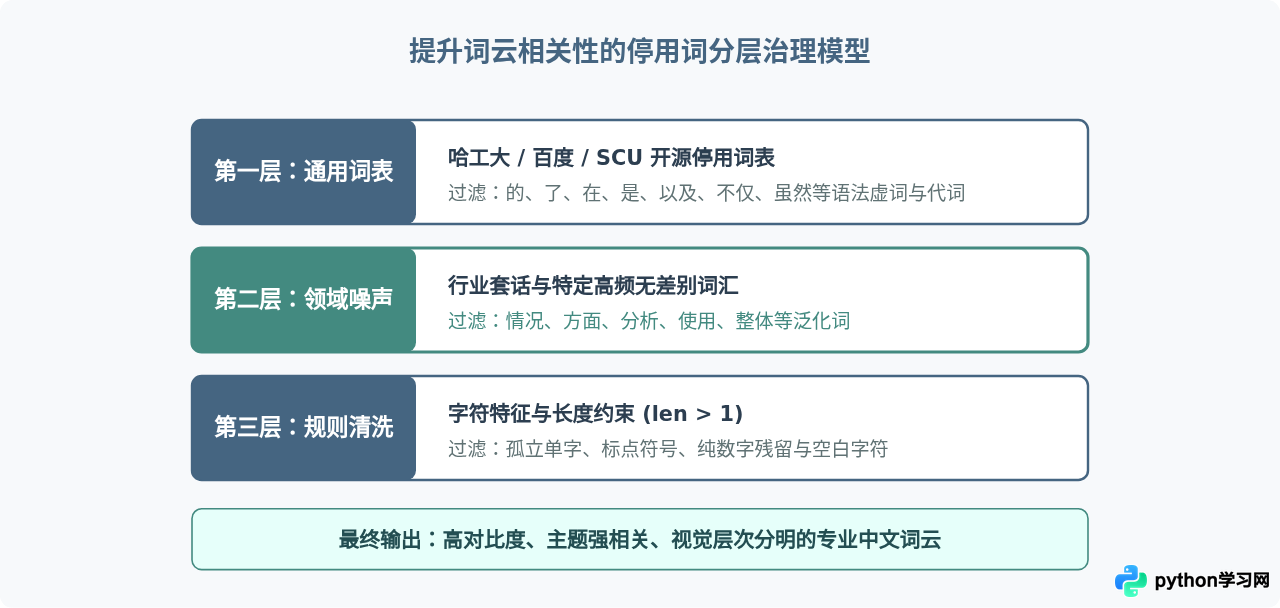
六、总结:停用词分层治理模型
提升 Python 词云内容相关性的核心不在于复杂的绘图特效,而在于前置文本清洗的严密程度。建立“通用语言基础层 → 业务场景领域层 → 规则过滤层”的分层过滤体系,能够保证从源头提纯关键词,使最终产出的词云精准传递文本的核心洞见。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









