

Python wordcloud库中文词云生成与自定义配置详解

本文详解Python wordcloud库的使用,重点解决中文显示乱码问题,通过替换字体文件实现中文支持。内容涵盖圆形词云生成、基于图片背景的词云制作、jieba分词与停用词处理、自定义词汇颜色及权重突出显示等完整流程,提供代码示例与配置参数说明。
Python wordcloud中文乱码解决方案
本文示例主要参考wordcloud官方examples,并对部分示例进行了调整与优化。
一、wordcloud中文词云乱码问题
在使用wordcloud生成词云时,常遇到中文显示为乱码的情况。这是因为wordcloud默认字体不支持中文字符,解决方法是替换其默认字体即可正常显示中文。
1、中文词云乱码现象
我们将使用simhei(黑体)来替换wordcloud的默认字体,以解决乱码问题。
2、替换默认字体的具体步骤
a、将字体文件(如simhei.ttf)复制到wordcloud的安装目录中。具体路径通常为:anaconda(python)-->lib-->site-packages-->wordcloud,如下图所示。
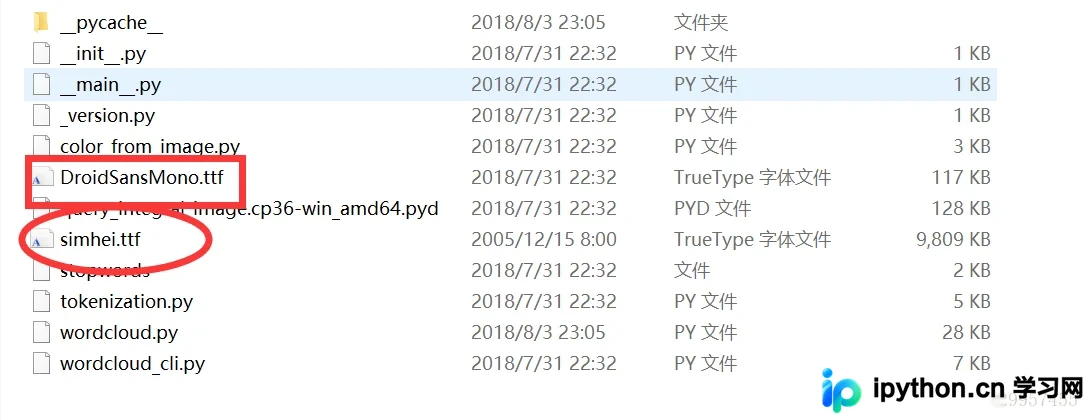
图中矩形框标注的是wordcloud默认的字体文件,椭圆形框标注的是我们下载并添加的中文字体文件。
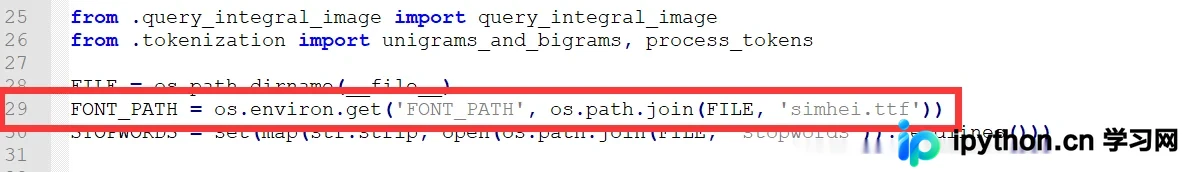
b、修改wordcloud.py文件中的字体设置。打开上述路径下的wordcloud.py文件,找到第29行所示的代码行(如图中框出部分)。
将代码中的DroidSansMono.ttf修改为simhei.ttf即可生效。
wordcloud核心功能示例
二、wordcloud示例演示
1、设计一个简单的圆形词云
import numpy as np
import matplotlib.pyplot as plt
from wordcloud import WordCloud,STOPWORDS
from PIL import Image
from os import path
import matplotlib.pyplot as plt
#用来正常显示中文
plt.rcParams["font.sans-serif"]=["SimHei"]
#用来正常显示负号
plt.rcParams["axes.unicode_minus"]=False
import os
import random,jieba

'''
绘制单个词一个圆形的词云
'''
def single_wordColud():
  text = "第一 第二 第三 第四"
  #产生一个以(150,150)为圆心,半径为130的圆形mask
  x,y = np.ogrid[:300,:300]
  mask = (x-150) ** 2 + (y-150) ** 2 > 130 ** 2
  mask = 255 * mask.astype(int)
  wc = WordCloud(background_color="white",repeat=True,mask=mask)
  wc.generate(text)

  #将x轴和y轴坐标隐藏
  plt.axis("off")
  plt.imshow(wc,interpolation="bilinear")
  plt.show()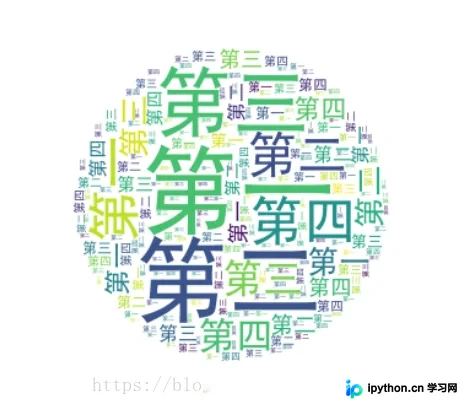
2、以图片形状作为背景设计词云
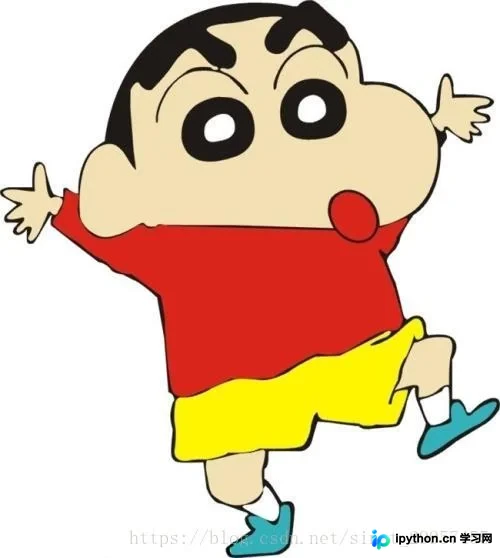
基于图片背景的词云生成
下面以蜡笔小新的图片作为背景来设计词云。我们通过读取一个txt文件,其中包含多段文字,利用jieba库对句子进行分词,去除停用词后,生成一张词云图片。
a、读取文件内容
使用jieba分词后,词与词之间需要通过空格进行分割,否则生成词云时会合并成一个长词。
'''
中文分词
'''
def segment_words(text):
  article_contents = ""
  #使用jieba进行分词
  words = jieba.cut(text,cut_all=False)
  for word in words:
    #使用空格来分割词
    article_contents += word+" "
  return article_contents
b、读取停用词
停用词包括标点符号及无实际意义的词汇,我们需要将这些词过滤掉。
'''
从文件中读取停用词
'''
def get_stopwords():
  dir_path = path.dirname(__file__) if "__file__" in locals() else os.getcwd()
  #获取停用词的路径
  stopwords_path = os.path.join(dir_path,"txt/stopwords.txt")
  #创建set集合来保存停用词
  stopwords = set()
  #读取文件
  f = open(stopwords_path,"r",encoding="utf-8")
  line_contents = f.readline()
  while line_contents:
    #去掉回车
    line_contents = line_contents.replace("\n","").replace("\t","").replace("\u3000","")
    stopwords.add(line_contents)
    line_contents = f.readline()
  return stopwords
c、生成词云图片
def drow_mask_wordColud():
  #获取当前文件的父目录
  d = path.dirname(__file__) if "__file__" in locals() else os.getcwd()
  mask = np.array(Image.open(path.join(d,"img/test.jpg")))
  text = open(path.join(d,"txt/test.txt"),"r",encoding="utf-8").read().
      replace("\n","").replace("\t","").replace("\u3000","")
  #对文本进行分词
  text = segment_words(text)
  #获取停用词
  stopwords = get_stopwords()
  #创建词云
  '''
  max_words:显示词的数量
  mask:背景
  stopwords:停用词,是一个set集合
  margin:词之间的间隔
  background_color:词云图片背景颜色
  '''
  wc = WordCloud(max_words=100,mask=mask,background_color="white",
          stopwords=stopwords,margin=10,random_state=1).generate(text)
  default_colors = wc.to_array()
  # #保存词云图片
  # wc.to_file("a_new_hope.png")
  plt.imshow(default_colors,interpolation="bilinear")
  plt.axis("off")
  plt.show()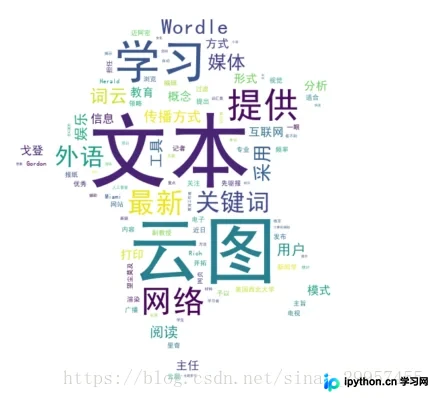
词云颜色与权重自定义
3、自定义词云的颜色
from wordcloud import WordCloud,get_single_color_func
import matplotlib.pyplot as plt

'''
定义一个字体颜色设置类
'''
class GroupedColorFunc(object):
  def __init__(self,color_to_words,default_color):
    self.color_func_to_words=[
      (get_single_color_func(color),set(words))
      for (color,words) in color_to_words.items()
    ]
    self.defalt_color_func=get_single_color_func(default_color)
  def get_color_func(self,word):
    try:
      #设置每个词的颜色
      color_func = next(color_func for (color_func,words) in self.color_func_to_words
               if word in words)
    except StopIteration:
      #词的默认颜色
      color_func = self.defalt_color_func
    return color_func
  def __call__(self,word,**kwargs):
    return self.get_color_func(word)(word,**kwargs)


if __name__ == "__main__":
  text = "第一 第二 第三 第四 第五 第六"
  #创建词云
  wc = WordCloud(collocations=False,background_color="white").generate(text)
  #设置词的颜色
  color_to_words={
    #使用RGB来设置词的颜色
    "#00ff00":["第一","第五"],
    "red":["第三","第六"],
    "yellow":["第二"]
  }
  #设置词默认的颜色
  default_color = "blue"
  grouped_color_func = GroupedColorFunc(color_to_words,default_color)
  #设置词云的颜色
  wc.recolor(color_func=grouped_color_func)
  #显示词云图
  plt.figure()
  plt.imshow(wc,interpolation="bilinear")
  plt.axis("off")
  plt.show()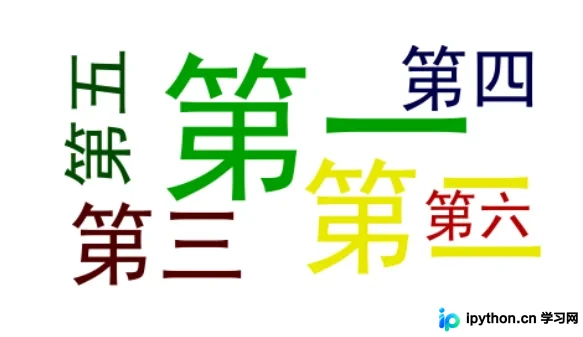
通过定义颜色设置类,可以指定不同词汇显示不同的颜色。
4、自定义突出词的重要程度
生成词云时,默认逻辑是使高频词更突出(字体更大)。有时我们已预先计算好词频权重,希望词云能直接反映权重大小的差异。
from wordcloud import WordCloud
import matplotlib.pyplot as plt
import numpy as np

def get_mask():
  x,y = np.ogrid[:300,:300]
  mask = (x-150) ** 2 + (y-150) ** 2 > 130 ** 2
  mask = 255 * mask.astype(int)
  return mask

if __name__ == "__main__":
  #每个词的权重
  text = {"第一":0.1,"第二":0.2,"第三":0.3,"第四":0.4,"第五":0.5}
  wc = WordCloud(background_color="white",mask=get_mask())
  wc.generate_from_frequencies(text)
  plt.axis("off")
  plt.imshow(wc,interpolation="bilinear")
  plt.show()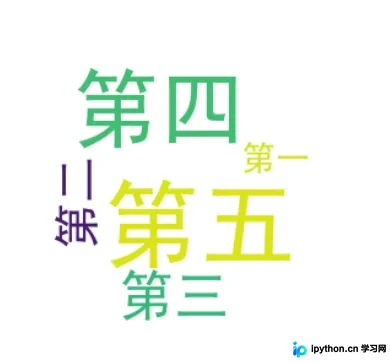
5、保存词云图片
wc.to_file("test.png")更多关于Python词云库wordcloud的使用方法,请查看下方的相关链接。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









