

Python爬虫在舆情监测与社会网络分析中的案例
通过一个完整的实战案例,讲解如何使用Python爬虫采集讨论数据,进行舆情情感计算,并借助NetworkX构建用户互动关系网络完成社会网络分析。
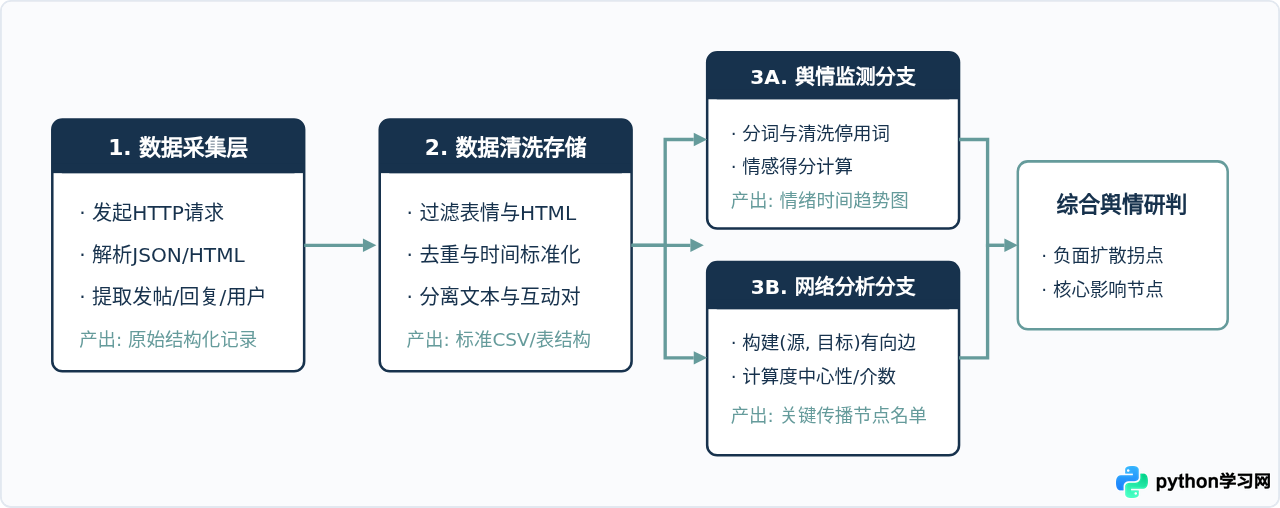
做舆情监测与社会网络分析,核心目的是弄清楚两件事:大家在讨论什么、情绪如何,以及信息是由谁传递给谁的。解决这个需求的技术路径非常明确,就是先用Python爬虫采集互动数据,提取出文本与互动关系字段,再分别做情感走势计算和图节点指标计算。本文以一个典型的产品质量讨论事件为具体案例,展示从数据采集、清洗、舆情分析到社交网络关系图构建的完整过程。
一、案例场景与系统整体设计
在这个案例中,我们假定某消费电子品牌发布了一款新品,在社交平台引发了集中讨论。部分用户反馈设备存在异常发热问题,随后引起大量博主转发、评论和次级扩散。品牌方或研究人员需要掌握情绪走势,并找出传播链条上的关键放大者。
系统主要由四个模块衔接而成:采集层、清洗持久化层、文本情感计算层、关系图构建与指标分析层。每一个层级输出的数据结构都有严格标准,确保爬虫抓取的原始报文能够直接无缝进入分析流程。
二、爬虫阶段:获取包含互动关系的关键字段
传统的文本爬虫通常只关注“正文内容”和“发布时间”,但为了支持社会网络分析,爬虫必须采集到互动的指向信息。如果缺少了“谁在回复谁”或者“谁在转发谁”,后续就无法建立网络连接。
进行此类任务时,数据表中至少要包含以下字段:
- post_id:帖子或主贴的唯一标识。
- comment_id:当前回复记录的唯一ID。
- user_id / username:当前发言人的身份标识。
- target_user_id / target_username:被回复对象或被转发原作者的身份标识。
- content:言论文本,供情感分析与分词使用。
- created_at:规范化时间戳,用于时间序列波动分析。
以下为一个模拟主流社交论坛评论API接口的爬虫模块示例代码。代码使用requests库模拟请求,并通过结构化字段抽取直接整理成规范字典:
import requests
import time
import json
import pandas as pd

def fetch_topic_discussions(keyword, page_limit=3):
    """
    抓取指定关键词下的讨论帖及直接回复关系
    """
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "application/json"
    }

    records = []

    # 模拟分页抓取
    for page in range(1, page_limit + 1):
        # 实际场景下替换为目标站点的搜索或评论API接口地址
        api_url = f"https://api.example.com/v1/search/comments?query={keyword}&page={page}"

        # 此处使用本地模拟解析逻辑,演示字段清洗与提取的核心机制
        # 实际发起网络请求应为: response = requests.get(api_url, headers=headers, timeout=10)
        # response_data = response.json()

        # 演示用模拟返回数据(符合真实API通用格式)
        mock_raw_response = [
            {"cid": "c101", "author": "用户A", "reply_to": "官方旗舰店", "text": "新机器发热严重,退货申请被拒了。", "time": "2026-10-06 10:15:00"},
            {"cid": "c102", "author": "数码老张", "reply_to": "用户A", "text": "可以去打售后电话试试,我的也发烫。", "time": "2026-10-06 10:22:00"},
            {"cid": "c103", "author": "科技小飞", "reply_to": "数码老张", "text": "今天测试跑分直接降频了,确实有问题。", "time": "2026-10-06 10:35:00"},
            {"cid": "c104", "author": "用户C", "reply_to": "数码老张", "text": "老张能出个测评详细说下温控吗?", "time": "2026-10-06 10:48:00"},
            {"cid": "c105", "author": "用户D", "reply_to": "科技小飞", "text": "同感,玩游戏十几分钟就烫手。", "time": "2026-10-06 11:05:00"}
        ]

        for item in mock_raw_response:
            records.append({
                "source_user": item["author"],        # 边发起方(互动人)
                "target_user": item["reply_to"],      # 边接收方(被回复人)
                "comment_id": item["cid"],
                "content": item["text"],
                "timestamp": item["time"]
            })

        time.sleep(1) # 请求间隔,控制访问频率

    return pd.DataFrame(records)

df_data = fetch_topic_discussions("发热", page_limit=1)
print(df_data[["source_user", "target_user", "content"]].head())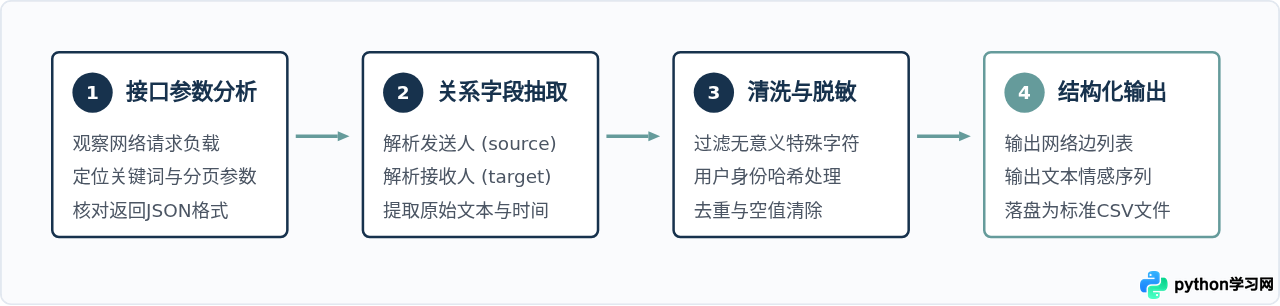
三、舆情监测:情感倾向与时间演变
采集到清洗好的文本后,舆情分析的核心任务是计算每一条发言的情感极性,并统计负面舆情随时间的变化情况。这里使用常用的中文自然语言处理库SnowNLP作为演示。在实际生产工程中,如果数据量庞大且对准确率要求极高,也可以采用预训练好的轻量级BERT分类模型。
from snownlp import SnowNLP
import pandas as pd

def analyze_sentiment(df):
    """
    计算文本情感得分并标记极性
    得分在0.5以上偏向积极/中性,0.5以下偏向消极
    """
    sentiments = []
    labels = []

    for text in df['content']:
        try:
            s = SnowNLP(text)
            score = round(s.sentiments, 3)
        except Exception:
            score = 0.5  # 遇到无法处理的特殊内容给中性默认分

        sentiments.append(score)
        # 根据阈值划分倾向
        if score < 0.4:
            labels.append("负面")
        elif score > 0.6:
            labels.append("正面")
        else:
            labels.append("中性")

    df['sentiment_score'] = sentiments
    df['sentiment_label'] = labels
    return df

# 假定载入清洗好的数据
df_analyzed = analyze_sentiment(df_data)
print(df_analyzed[['timestamp', 'source_user', 'content', 'sentiment_score', 'sentiment_label']])
运行结果中,像“新机器发热严重,退货申请被拒了”会得到低于0.2的低分,被自动打上“负面”标签;而客观求助或技术测试等讨论,分数多集中在0.4至0.6之间。聚合各时间段内负面言论的占比,就可以绘制出舆情趋势曲线,辅助监测人员快速锁定负面爆发的具体时间点。
四、社会网络分析:用NetworkX定位关键传播者
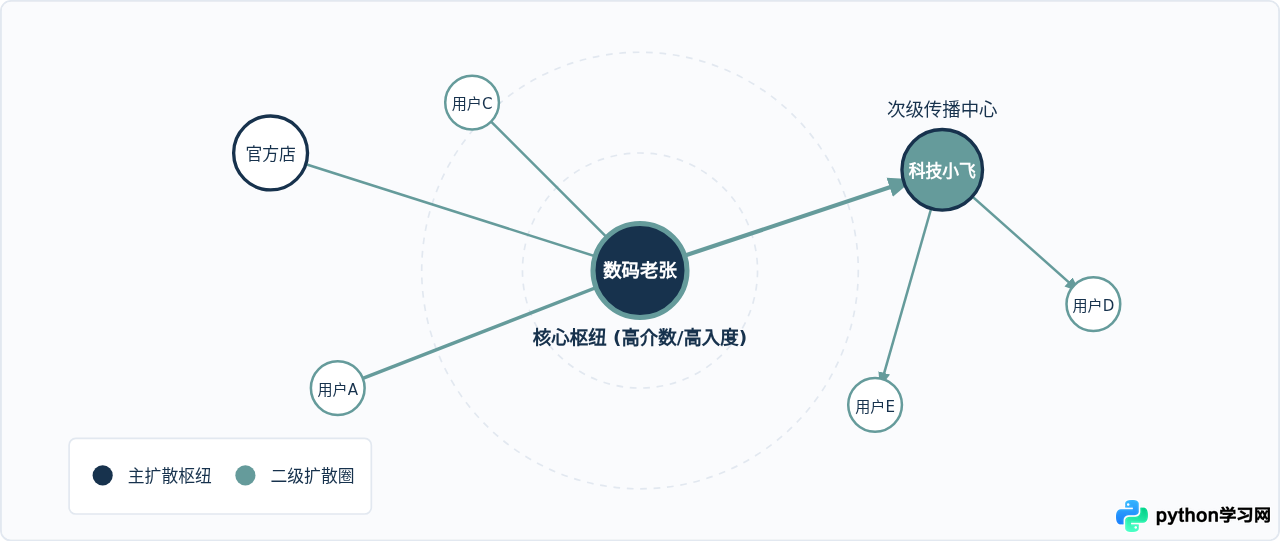
许多人误以为舆情就是数评论数量,但单纯统计总数无法识别传播是由谁放大的。社会网络分析(SNA)的核心就是把用户抽象为“节点”,把用户之间的回复、转发、@抽象为“有向边”。
在Python中,networkx是处理图网络最标准也是最容易上手的工具。我们根据清洗后的source_user和target_user直接构建有向图(DiGraph):
import networkx as nx

# 1. 实例化有向图
G = nx.DiGraph()

# 2. 从DataFrame批量增加边
# 权重weight代表互动频次,多次回复同一对象会累加权重
for _, row in df_data.iterrows():
    u = row['source_user']
    v = row['target_user']
    if G.has_edge(u, v):
        G[u][v]['weight'] += 1
    else:
        G.add_edge(u, v, weight=1)

# 3. 计算关键网络指标
# 入度中心性 (In-degree Centrality): 收到多少人的回复/转发,衡量“权威度”或“被聚焦程度”
in_degree = nx.in_degree_centrality(G)

# 介数中心性 (Betweenness Centrality): 节点处于其它节点最短路径上的频率,衡量“信息桥梁”能力
betweenness = nx.betweenness_centrality(G)

# 整理为清晰的评估报表
rankings = []
for node in G.nodes():
    rankings.append({
        "用户节点": node,
        "入度中心性": round(in_degree[node], 3),
        "介数中心性": round(betweenness[node], 3),
        "入度数(被回复次数)": G.in_degree(node)
    })

df_rankings = pd.DataFrame(rankings).sort_values(by="入度中心性", ascending=False)
print(df_rankings.to_string(index=False))
从代码的输出结果可以直观看到不同角色的差异:
| 指标类别 | 在舆情网络中的实际含义 | 业务研判建议 |
|---|---|---|
| 入度高 (High In-Degree) | 被大量普通用户回复、追问或转发,是话题讨论的焦点核心。 | 此节点一旦输出极端情绪,容易引起广泛群聚共鸣,需要重点关注。 |
| 介数高 (High Betweenness) | 连接了不同圈层(例如普通消费者圈子与数码数码测评圈子)的中介节点。 | 信息跨圈层扩散的关键枢纽,切断或引导该节点即可阻断信息外溢。 |
| 出度高 (High Out-Degree) | 向很多不同人发起回复,通常是活跃发帖者或批量评论账号。 | 用于判断是否存在水军批量洗版或人工带节奏的异常行为。 |
五、全流程落地总结与实操建议
将上述所有模块拼装在一起,就形成了舆情监测与社会网络分析的标准闭环。在将这套系统投入实际使用时,建议遵循三个原则:
- 爬虫字段要前瞻:采集阶段就必须预留好
target_user这类关系字段。如果一开始只抓了文本和发布时间,后续想补做社会网络分析就只能推倒重来。 - 情感与拓扑要结合:单纯看负面情感高并不一定意味着危机,如果负面言论全部分散在孤立的边缘叶子节点(入度和介数都极低),其自然扩散能力非常有限;相反,一旦高介数节点发布负面内容,就必须启动高优先级响应。
- 防爬与数据合规常态化:社交平台接口迭代频繁,网络请求应做好异常重试机制与IP代理池调度,严禁短时间内高频次打垮目标服务器,落盘数据及时去除个人敏感隐私信息。
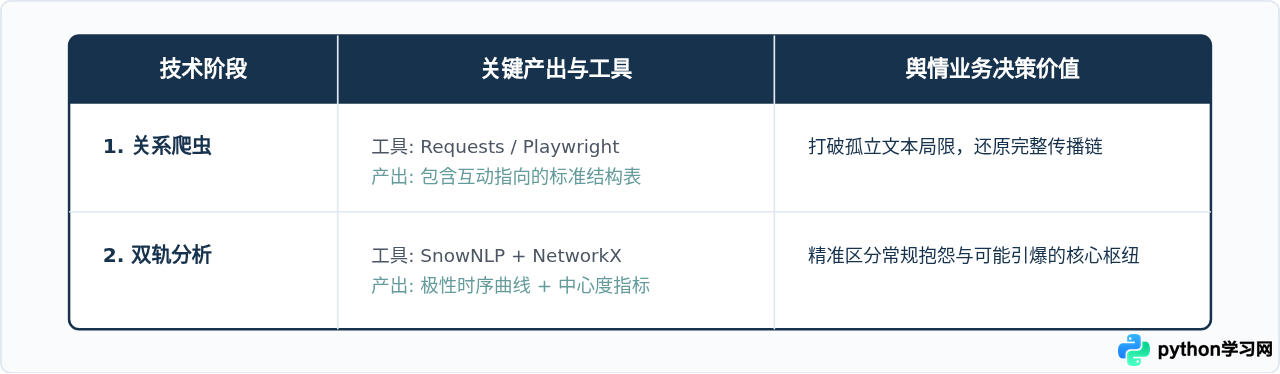
通过这套方法,技术团队可以摆脱人工刷帖的被动局面,将海量杂乱的社交讨论转化为具备量化支撑的情感走势和节点拓扑图,为产品公关和品牌决策提供坚实依据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









